数据是每一家现代企业最核心的资产,但"数据到底该怎么存"却常常被忽视。本篇是 Trailhead「Strategies for Big Data Architecture」模块的中文导读,从数据库的历史与基本原理讲起,带你厘清关系型与非关系型数据库的区别,再系统比较 Salesforce 提供的各种数据存储方案,最后通过四个真实客户场景,演练如何为不同的业务需求选出最合适的大数据架构。
全文分为三个单元:第一单元夯实数据库基础(历史、ACID 与 BASE、四种 NoSQL 类型、什么是"大数据");第二单元逐一拆解 Salesforce 的存储选项(标准/自定义对象、Salesforce Connect、Heroku Connect 与 Big Objects);第三单元化身顾问,用"位置、数据量、使用方式"三个维度为 Frysco、Rockify、Mango、ETailored 四家公司做出决策。每个小节都对应一页 PPT 幻灯片并附讲解视频。
01 理解数据库基础(Understand the Basics of Databases)
本单元是整篇的基石,回答一个最根本的问题:数据在"云"里到底是怎么组织的。学完本单元,你将能够:识别数据库历史上的五个里程碑、区分关系型与非关系型数据库,以及定义什么是"大数据"。
我们常说数据"在云端",但云并不是什么虚无缥缈的东西,而是遍布世界、装满服务器的物理数据中心。Salesforce 在全球就运营着许多这样的数据中心。数据如何组织、如何被访问,完全取决于底层的数据库——这就是本单元要讲清楚的核心。
数据库的历史(History of Databases)
当我们说数据"在云端"时,脑海中浮现的雾气和迷雾其实是个误导——云只是一座装满服务器的物理数据中心,Salesforce 在全球就有很多座。而所有数据如何被组织和访问,完全取决于底层的数据库。
本单元是一堂数据库概念的速成课。我们先从一段简短的历史讲起:1960 年代"数据库"这个词诞生,十年后关系型数据库登场,到今天,存储方案已经从桌面级 SQL 一路演进到云规模的 NoSQL。
时间线(Timeline)
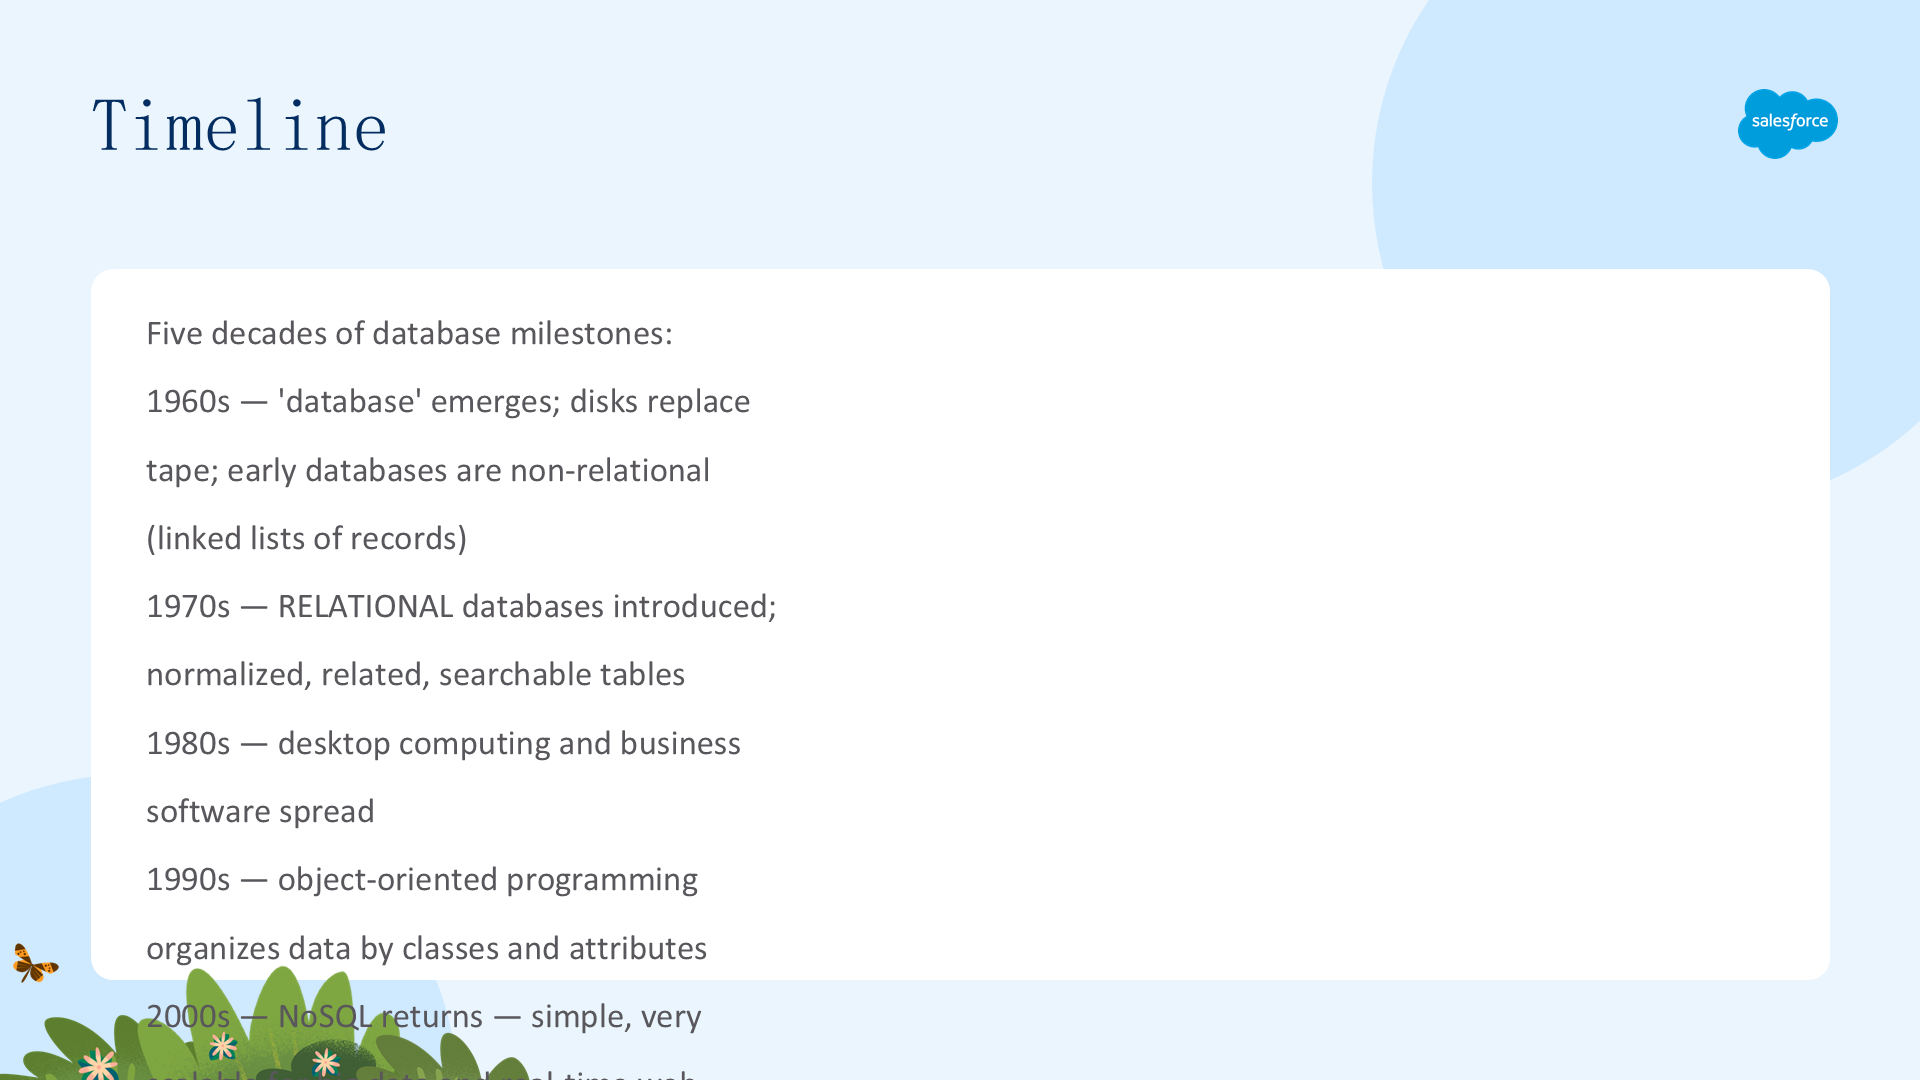
数据库的故事始于 1960 年代——那时一台计算机能占满整整一个房间。下面这条时间线梳理了五个十年间的关键里程碑。

- 1960 年代:早期 1960 年代"数据库"一词出现,磁盘取代了磁带存储。最早的数据库是非关系型的,只是自由格式记录的链表。
- 1970 年代:关系型数据库问世并最终成为主流。与以往不同,它提供了规范化、相互关联、可搜索的表。
- 1980 年代:桌面计算普及,随之而来的是与底层数据库交互的、用户友好的商业软件。
- 1990 年代:面向对象编程(OOP)让数据可以按类和属性来组织,而不再局限于表和字段。
- 2000 年代:非关系型数据库以 NoSQL(not only SQL,不只是 SQL)的形式卷土重来。它们简单且扩展性极强,满足大数据与实时 Web 应用的需求。
有了这段历史铺垫,下面我们来细看数据库的两大分类。
关系型 vs 非关系型(Relational vs. Non-relational)
关系型数据库统治了业界数十年,至今仍然举足轻重。它们把数据拆分到多个相互关联的表中:父表包含被称为"主键(primary key)"的唯一标识符行,子表则用"外键(foreign key)"来引用这些主键。
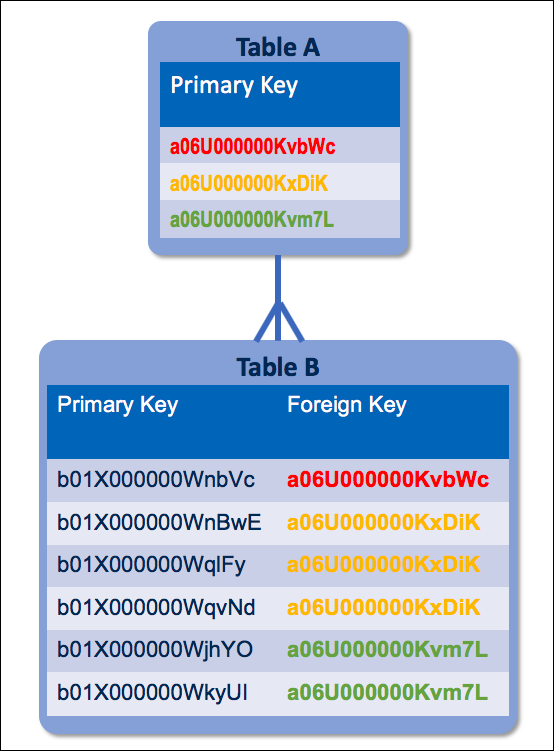
在下图中,表 A 是父表,表 B 是子表。子表通过外键列引用父表的主键列,从而建立两张表之间的关联。
非关系型数据库(又称 NoSQL)则是在 Web 应用产生出无法被塞进刚性结构的数据时才重新兴起的。它们不要求数据套进固定的表结构,因而更灵活、更容易横向扩展。
关系型数据库的特征(Characteristics of Relational Databases)
管理员和开发者通常使用结构化查询语言(SQL)来访问和操作关系型数据库中的数据。关系型数据库的事务具有四个特征,可以用首字母缩写 ACID 来记忆:
- 原子性(Atomic):事务中的所有任务要么全部成功,要么整个事务回滚。
- 一致性(Consistent):数据库的状态在整个事务期间保持一致。
- 隔离性(Isolated):每个事务彼此独立,互不依赖。
- 持久性(Durable):失败事务的数据可以被恢复。
关系型数据库把一致性置于可用性之上,非常适合对结构化的刚性数据进行复杂的分析与操作。但有些时候,数据就是无法被塞进刚性结构——这正是 1990 年代互联网兴起后出现的局面,也催生了非关系型数据库的强势回归。
非关系型数据库的类型(Types of Non-relational Databases)
非关系型(NoSQL)数据库主要分为四种类型,各有其适用的数据形态。

- 键值对(Key-value pairs):采用关联数组模型,数据表示为一组(键 + 值)对的集合。
- 列式存储(Column-oriented stores):使用表结构,但表中的列可以随行而变化(不同行可以有不同列)。
- 文档型系统(Document-oriented systems):每个文档作为数据库中的一个独立实例保存,文档之间可以嵌套。
- 图(Graphs):组织元素、元素之间的关系,以及同时赋予元素和关系的属性。
不同的数据形状,对应不同的 NoSQL 类型——这正是选择时要先想清楚"数据长什么样"的原因。
非关系型数据库的特征(Characteristics of Non-relational Databases)
非关系型数据库共享三个特性,用首字母缩写 BASE 来记忆——它与关系型的 ACID 恰好相反,把可用性置于一致性之上:
- 基本可用(Basically available):即使发生故障,系统依然可用。
- 软状态(Soft state):数据的状态可能会发生变化。
- 最终一致(Eventual consistency):一致性不在事务级别得到保证,但数据最终会在所有节点间同步。
由于结构容易建模,非关系型数据库的扩展性极强;但一致性可能并不完美——它无法保证所有客户端在同一时刻看到完全相同的数据。二者对比下来,没有绝对的赢家:
- 关系型:规范化、SQL、结构化数据、ACID 事务;
- 非关系型:去规范化、有限或异步 SQL、结构化或非结构化数据、无事务或有限事务。
当数据量极其庞大时,非关系型往往是更合适的选择。
你好,大数据(Hello, Big Data)
"大数据"听起来很高大上,但它到底是什么?大数据指的是任何规模过大或过于复杂、无法用传统数据处理应用软件处理的数据集——动辄数亿甚至数十亿行。如今存储便宜、处理快速,大数据无处不在。人工智能(AI)则借助机器学习,以人类望尘莫及的速度处理这些记录。
既然存储和处理都如此廉价高效,企业自然不愿丢弃数据。那到底该怎么选——是用非关系型数据库来应对海量的数量和多样性,还是用关系型数据库来处理复杂的业务逻辑?答案是:两者往往都需要。现代企业通常需要一套企业级架构,把多种技术整合成一个完整的解决方案。
了解了数据库与大数据的基本概念后,下一单元我们来看看 Salesforce 具体如何存储数据。
02 比较数据存储选项(Compare Data Storage Options)
本单元聚焦 Salesforce 的数据存储能力。学完本单元,你将能够:描述 Salesforce 的各种数据存储解决方案,并把数据策略与业务需求正确匹配。
存储数据的方式有很多,关键看你有多少数据、要用它做什么。Salesforce 的存储选项可以按"数据住在哪里"来划分:标准对象、自定义对象和 Big Objects 存放在 Salesforce 自有数据中心;而 Salesforce Connect(配合外部对象)与 Heroku Connect 则把数据放在 Salesforce 之外。下面逐一深入。
概览(Overview)
选择存储方案时,要依据三件事:数据住在哪里、数据量有多大、数据如何增长。
- 在 Salesforce 内部:标准对象、自定义对象,以及 Big Objects。
- 在 Salesforce 外部:Salesforce Connect 与外部对象、Heroku Connect。
每种选项都对应不同的使用场景。本单元的目标,就是让你能把正确的选项匹配到正确的需求上。
标准与自定义对象(Standard and Custom Objects)
无论企业是把 Salesforce 当作传统 CRM 工具,还是当作平台即服务(PaaS),数据都存储在"对象"里。标准对象随 Salesforce 提供,Campaign、Lead、Account、Contact、Opportunity、Case 是最常见的几类记录。你也可以构建自定义对象来存储公司或行业特有的数据。
在以下情况下使用标准或自定义对象:
- 需要用 Flow、验证规则、Apex 触发器(trigger)等工具自动化业务逻辑(它们支持跨多条记录的事务性);
- 每个对象存储少于 2000 万条记录(实际数字可能因用例而异,大容量场景请参考 LDV 白皮书);
- 需要实时访问最新数据。
Salesforce Connect
Salesforce Connect 用于把外部数据连接到你的 Salesforce org,而无需把数据复制进来。需要注意,它有一些功能限制(例如共享规则 Sharing Rules 不适用于 Salesforce Connect)。
只要你的系统提供 OData 2.0 或 OData 4.0 适配器,就可以用点击(而非写代码)的方式构建外部对象;如果会写代码,还可以使用 Apex Connector Framework。Salesforce Connect 让你能直接在 Salesforce UI 中搜索、查看和修改存储在别处的数据。
在以下情况下使用 Salesforce Connect:
- 希望避免把大量数据复制进 Salesforce org;
- 每次只需访问少量数据;
- 需要实时获取最新数据。
Heroku Connect
Heroku Connect 在 Salesforce 与 Heroku Postgres(一种面向开发者的托管 SQL 数据库)之间架起一座桥。没有它,数据只能显示在 Heroku 平台上构建的自定义 UI 中。

如果想在 Salesforce 和 Heroku Postgres 两个数据库中都保留数据,就使用数据复制(data replication)策略。复制可以是单向的(从 Salesforce 到 Heroku Postgres),也可以是双向的。从 Heroku Postgres 回写到 Salesforce 的复制可以配置为极低延迟执行,但不是实时的。
如果不需要把数据存进 Salesforce,则可以借助 Salesforce Connect 的外部对象,把 Heroku Postgres 中的数据"代理(proxy)"进 Salesforce。在以下情况下使用 Heroku Connect:
- 要运行一个可能改变 Salesforce 数据的面向消费者(B2C)应用;
- 需要在 Salesforce 与 Heroku Postgres 之间同步数据;
- 每个对象存储少于 2000 万条记录;
- 需要用 Flow、验证规则、Apex 触发器自动化业务逻辑。
Big Objects
顾名思义,Big Objects 在 Salesforce 平台上存储和管理海量数据——推荐用于超过 2000 万行、甚至高达数十亿行的场景。Big Objects 底层使用非关系型数据库存储数据,支持通过主键访问进行实时 SOQL 查询。
主键访问也叫"索引(index)",由 Big Object 中的自定义字段定义。因此你需要仔细规划:哪些字段被索引、如何索引(升序还是降序)、以及顺序如何——这决定了查询能否在数十亿行数据上顺利完成。
Big Objects 与 Tableau CRM 的集成,每个数据集限制在约 7000 万行以内。你可以利用声明式的 Tableau CRM UI 执行聚合函数,而不必写代码;Big Objects 也可以作为数据流(dataflow)中的源对象。如果数据行数超过 Tableau CRM 的上限,就用 Batch Apex 过滤并存储一个较小的数据子集到次级 Big Object 或自定义对象中,以获得完整的 Salesforce 功能。
在以下情况下使用 Big Objects:
- 处理数百万甚至数十亿行的数据;
- 批量处理大数据集并对完整数据集做聚合;
- 用运营报表或 Tableau CRM 分析大数据。
比较解决方案(Compare Solutions)
逐一了解了每种存储方案后,我们从几个角度把它们放在一起比较。
配置的难易程度——本质上是"点击式 vs 写代码"的权衡。你需要把解决方案与团队技能相匹配,并考虑后续维护所需的人力。
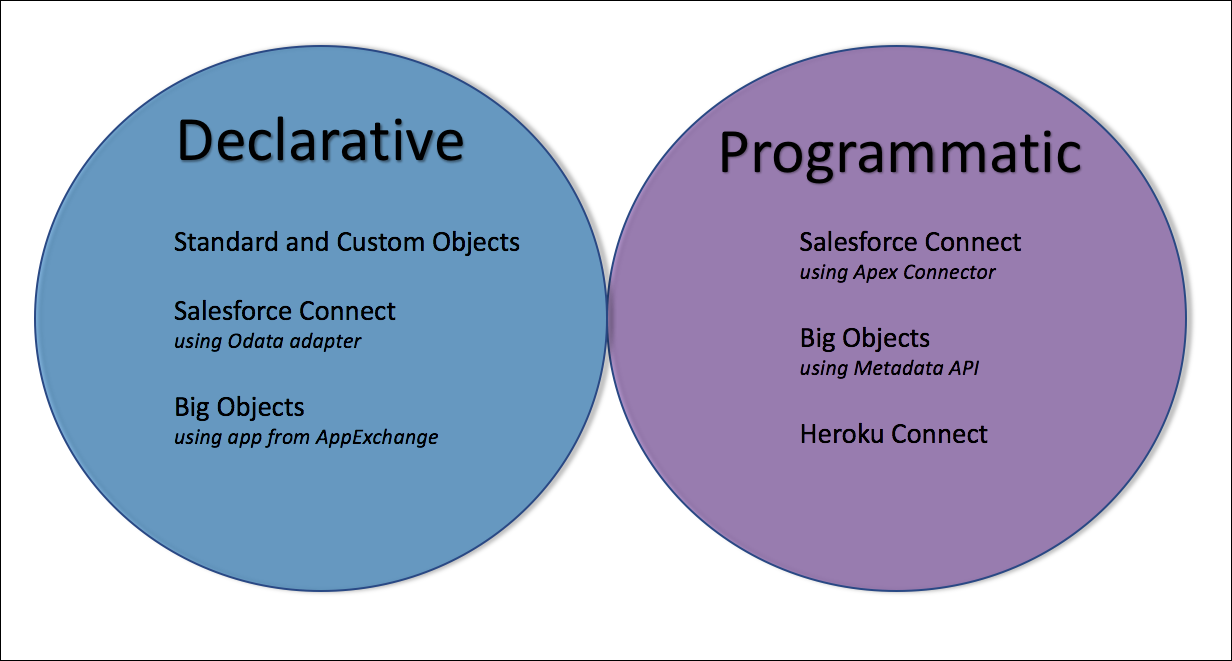
能否显示在 Salesforce UI 中——标准对象、自定义对象和 Salesforce Connect 的数据可以显示在 Salesforce UI 的任何地方(页面布局、列表视图、报表、Visualforce 页面、Lightning 组件)。Heroku Connect 则根据是数据复制还是数据代理,分别使用标准/自定义对象或 Salesforce Connect,无论哪种方式,数据都能显示在 UI 中。
而 Big Objects 不会自动显示在 UI 中,但你有几种选择:可以用 Apex、SOQL 和主键把它暴露在 Lightning 组件或 Visualforce 页面里;更常见的做法是用异步 SOQL(Asynchronous SOQL)查询一个较小的数据子集和聚合结果,存入自定义对象,这样该子集就能显示在 UI 任何地方;也可以把整个数据集接入 Tableau CRM,获得强大的报表能力。
是否满足安全要求——最后,在选择存储方案前,务必把具体的安全需求考虑进去。
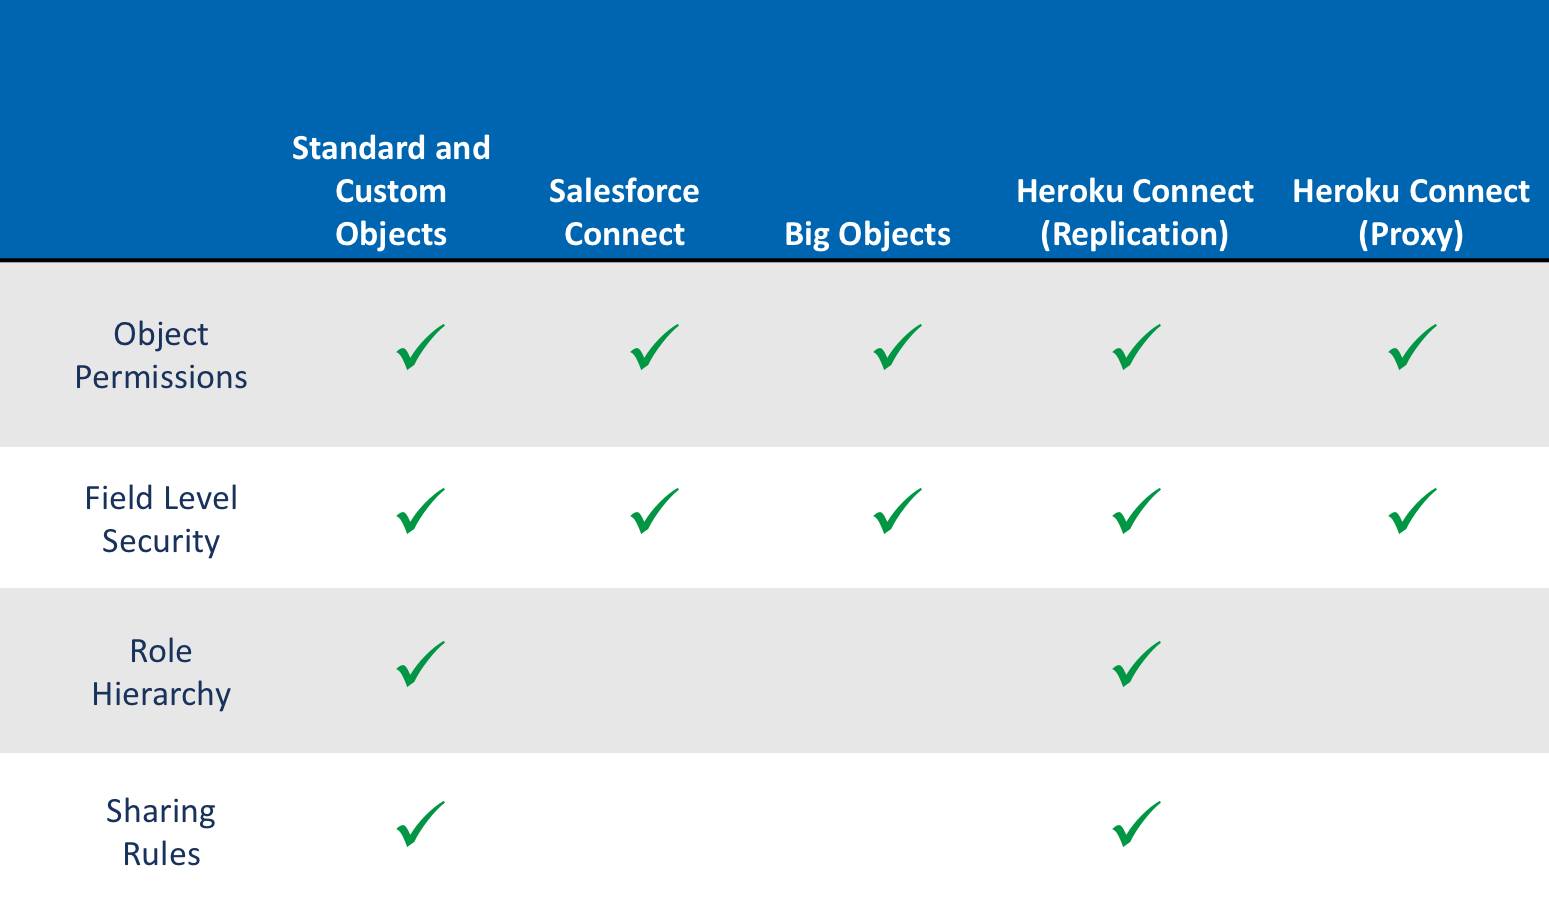
标准对象和自定义对象支持全部 Salesforce 数据安全特性(对象权限、字段级安全、角色层级、共享规则);Salesforce Connect 兼容对象权限和字段级安全;Big Objects 支持对象权限和字段级安全。
03 选择正确的大数据解决方案(Choose the Right Big Data Solution)
本单元进入实战。学完本单元,你将能够:为特定用例选择一个 Salesforce 数据存储方案,并描述如何使用 Big Objects 处理大数据。
恭喜,你刚被一家专注于 CRM 实施的高科技咨询公司 Get Cloudy 录用。Get Cloudy 作为 Salesforce 合作伙伴业务蒸蒸日上,每周都有新客户。作为顾问,你的工作就是为每位客户推荐最合适的 Salesforce 数据存储方案——本单元就教你如何做到。
引言(Introduction)
开始为客户推荐方案前,先问几个问题:数据是否需要在 Salesforce 中留一份副本?数据量有多大——是否超过 2000 万条?是否需要暴露在面向客户的应用中?一旦搞清楚这些,你就能开始排除那些不适用的方案。
评估客户的数据存储需求(Evaluate Your Client's Data Storage Needs)
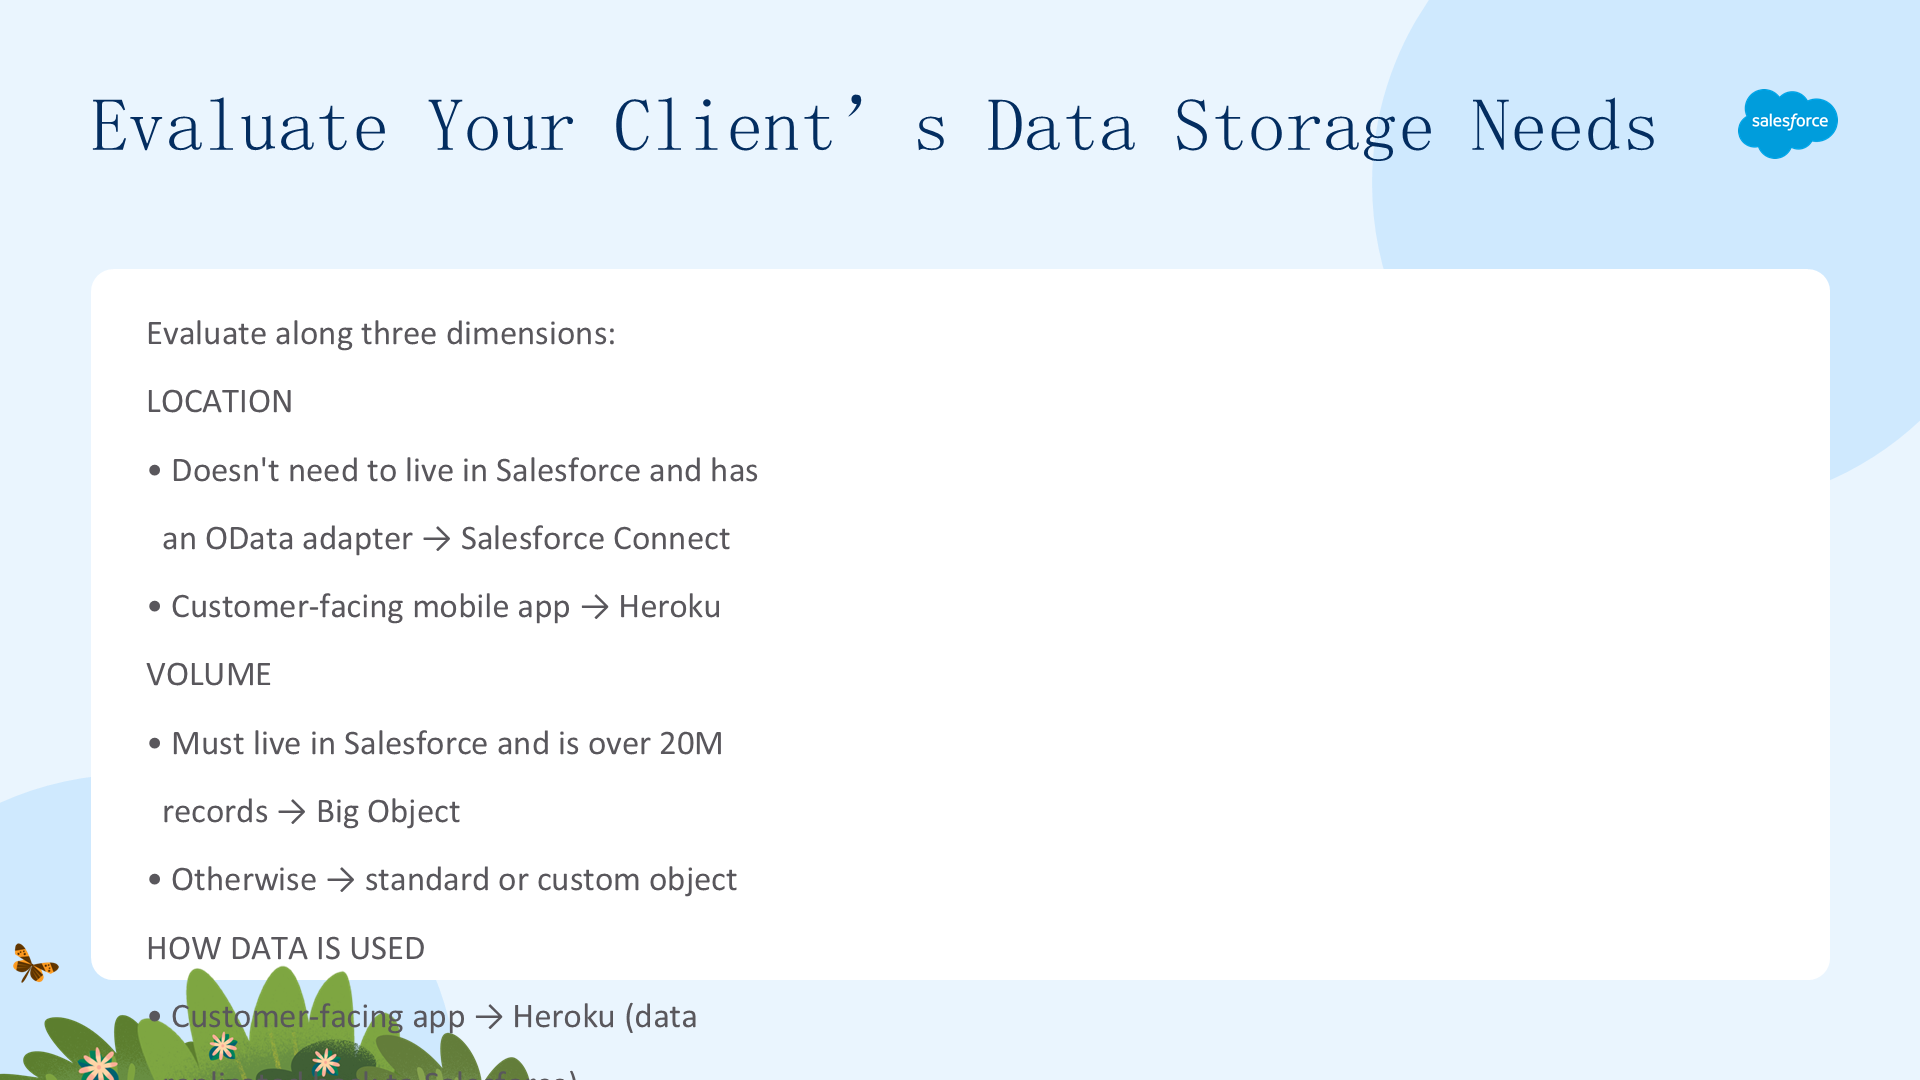
沿着三个维度评估每一位客户:
- 位置(Location):数据是否必须存放在 Salesforce 中?如果不必且已有 OData 适配器,就选 Salesforce Connect;如果是面向客户的移动应用,就选 Heroku。
- 数据量(Volume):如果数据必须存在 Salesforce 里,且超过 2000 万条,就用 Big Object;否则用标准或自定义对象。
- 使用方式(How data is used):数据用于面向客户的应用(Heroku,数据复制回 Salesforce),还是用于分析(Big Objects)。
这三个维度叠加起来,就构成了选型决策的完整框架。
位置(Location)
首先看数据应该存在哪里。
- 如果数据不需要存放在 Salesforce,且已经存在于一个有 OData 适配器的数据库上,那么 Salesforce Connect 是最佳选择。
- 如果数据是面向客户的移动应用的一部分,则由 Heroku 提供托管平台。
- 如果数据在 Heroku Postgres 数据库上、只需要被代理(proxy),也可以用 Salesforce Connect,采用数据代理策略。
数据量(Volume)
如果数据必须存放在 Salesforce,那就要看数据量有多大。
- 超过 2000 万条记录:使用 Big Object,以便高效地存储和查询。
- 少于 2000 万条记录:使用标准或自定义对象是最简单的方式,能获得 Salesforce 完整的特性集。
数据如何使用(How Data Is Used)
接下来问:数据将如何被使用?
- 如果要暴露在面向客户的移动应用中,Heroku 提供应用开发平台——数据存储在 Heroku Postgres 上,并通过数据复制策略同步回 Salesforce。
- 如果不用于应用,那么对于存储在 Salesforce 中的大容量数据,Big Objects 就是答案。
考虑数据分析选项(Consider Data Analysis Options)
客户确定了大容量数据的去处后,还有几件事要想清楚。Big Objects 可以存储数十亿条记录,那么:数据将如何被分析——是整体分析,还是按聚合和子集分析?是否需要为部分数据自动化业务逻辑?
这些问题的答案,决定了你是用 Tableau CRM、用异步 SOQL 把子集推送到自定义对象,还是用 Batch Apex 来处理。
现在测试你的知识(Now, Test Your Knowledge)
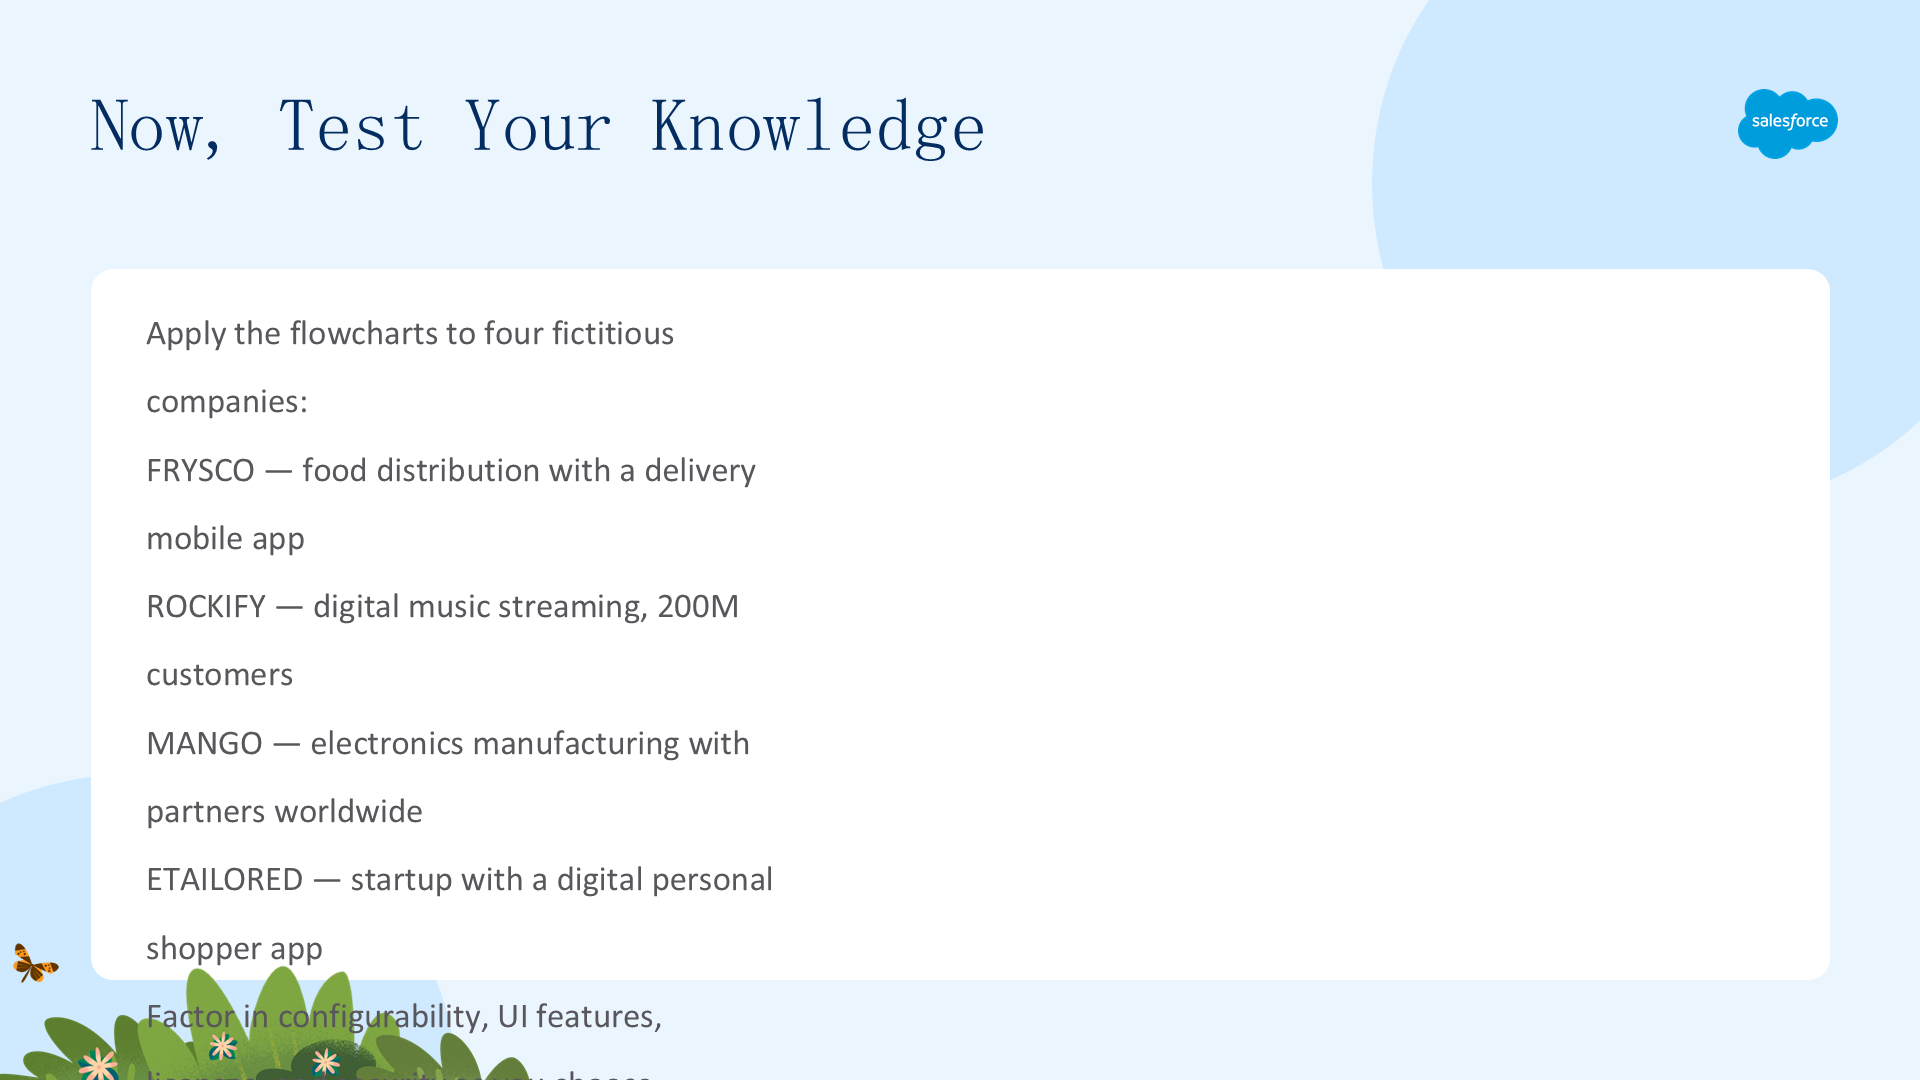
作为 Get Cloudy 最新上任的顾问,你已经准备好根据每位客户的独特情况推荐数据存储方案了。以下面这些流程图作为总体指引,你会为下面四家虚构公司推荐什么方案?别忘了把可配置性与维护成本(点击 vs 代码)、UI 特性、Salesforce 许可证、安全要求一并纳入考量。
四家公司分别是:食品分销公司 Frysco、数字音乐流媒体 Rockify、电子制造企业 Mango,以及创业公司 ETailored。
Frysco
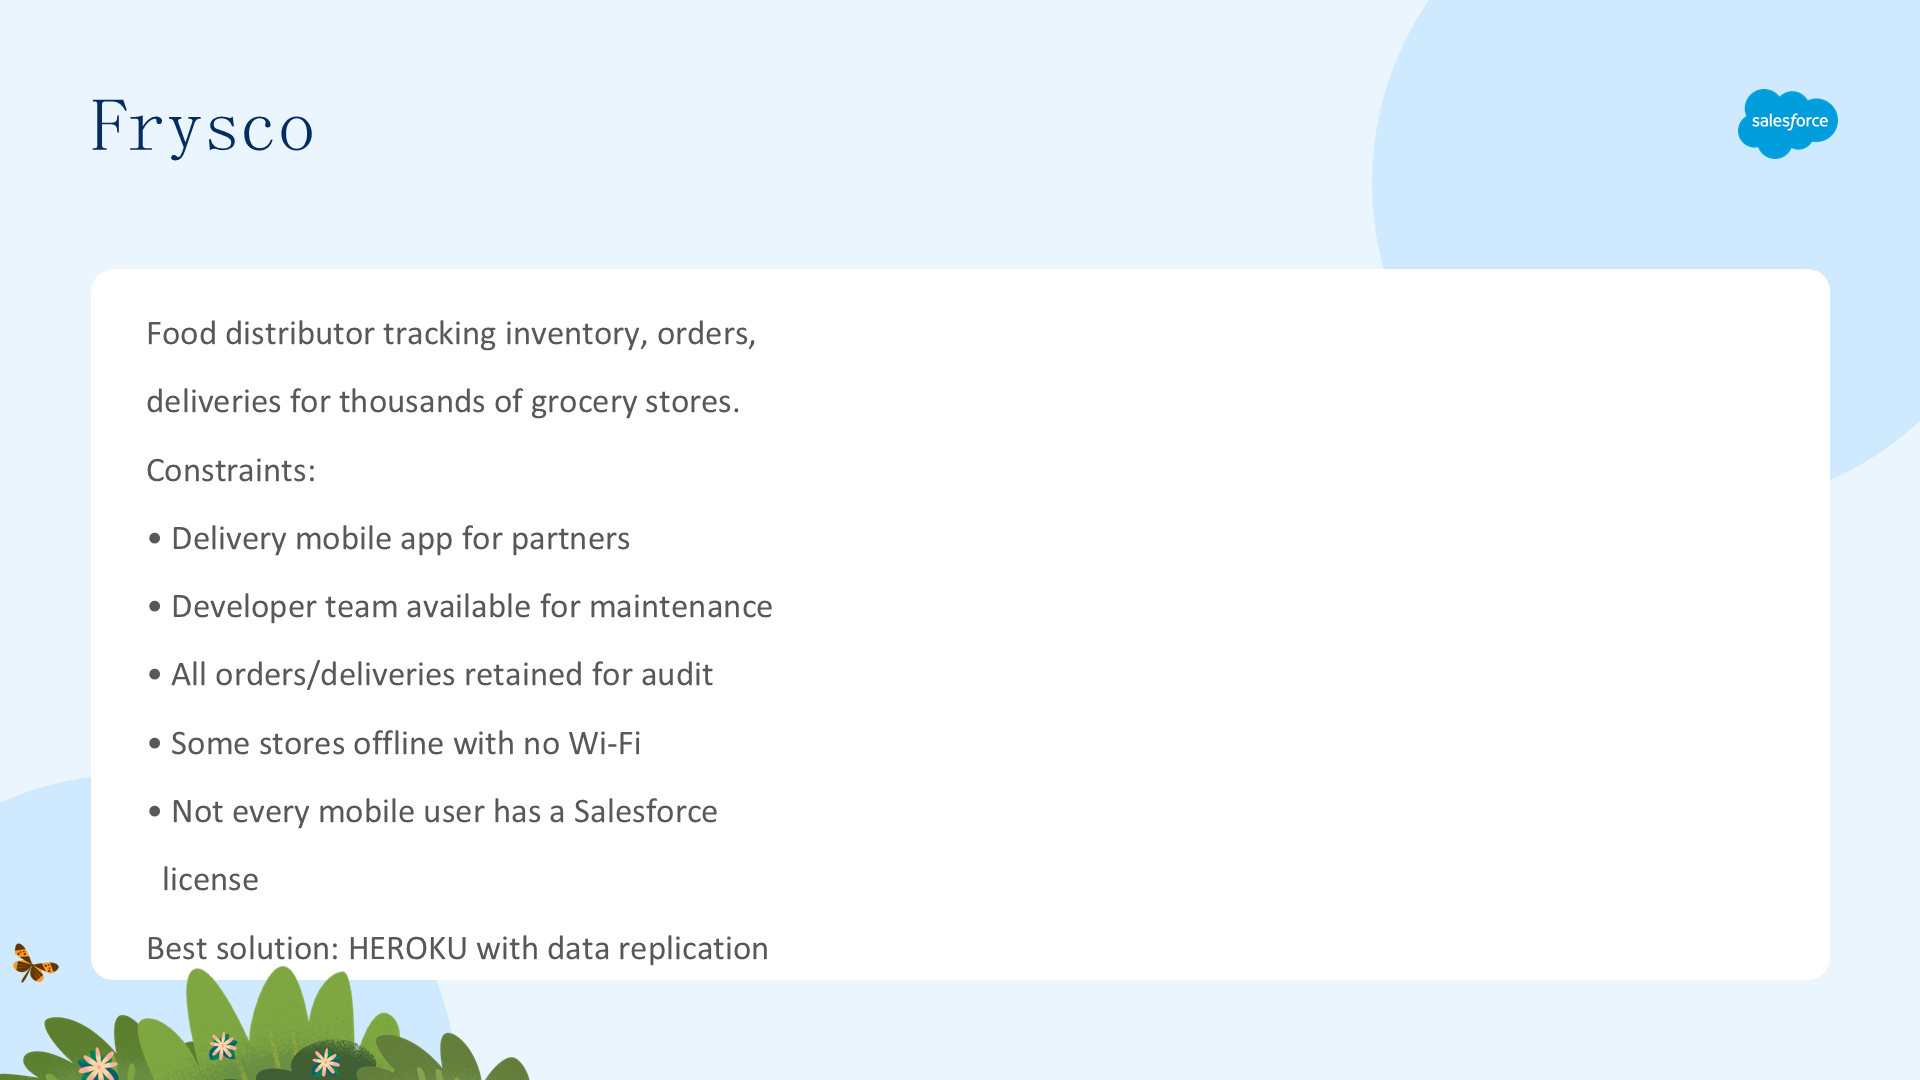
Frysco 是一家食品分销公司,需要一套数据存储方案来追踪库存、订单与配送。它的客户是大型杂货超市,多达数千家。Frysco 需要为配送合作伙伴提供一个移动应用,并满足以下约束:
- IT 部门有一支开发者团队可做长期维护;
- 所有订单与配送记录必须为审计目的而保留;
- 部分乡村杂货店没有 Wi-Fi、连接有限;
- 并非每个移动应用用户都有 Salesforce 许可证。
最佳方案:Heroku + 数据复制(data replication)。移动应用运行在 Heroku 上、数据存在其 Postgres 数据库,开发者负责维护;订单和配送数据再同步回 Salesforce——即便用户离线也能工作,满足审计要求。
Rockify
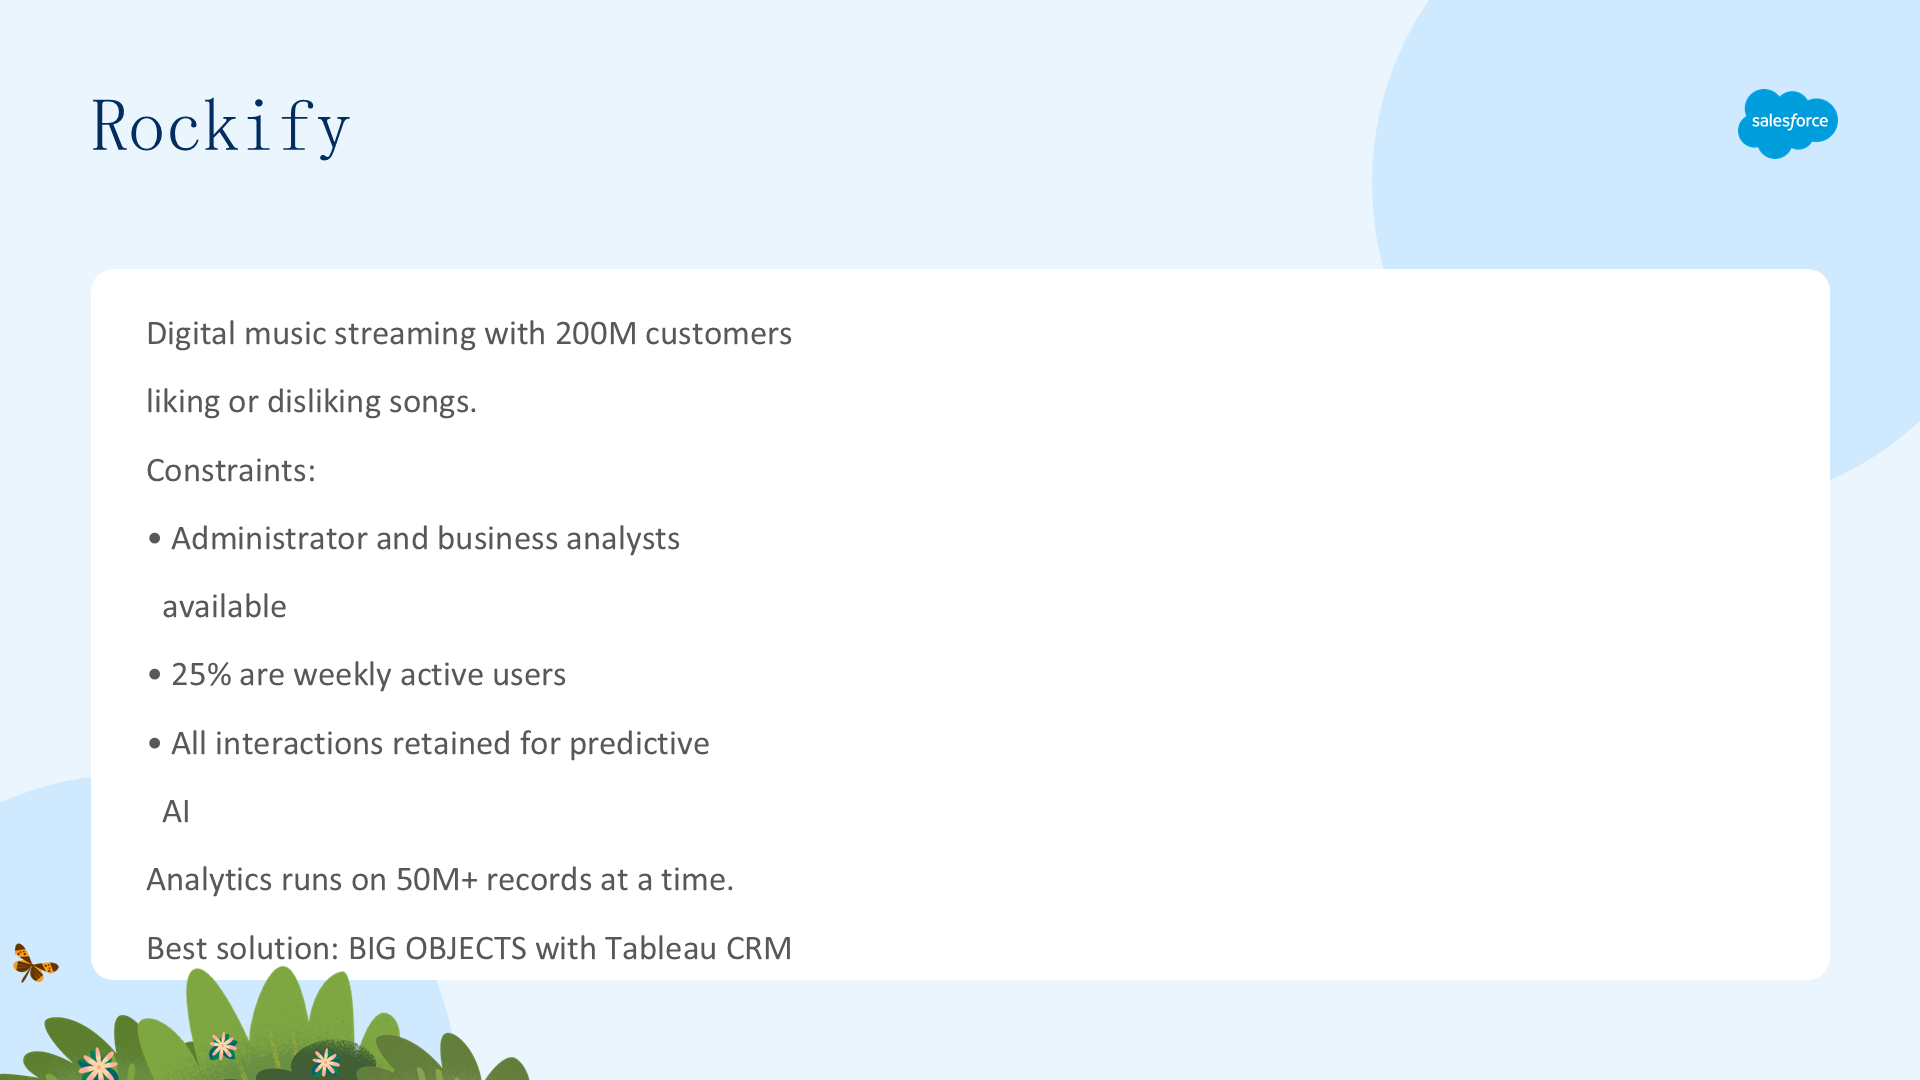
Rockify 是一家数字音乐流媒体服务,需要为客户数据寻找存储方案。全球有 2 亿人在听歌并为每首歌点赞或点踩。公司需要跨不同人群与地域对数据进行有意义的分析,约束如下:
- 有 Salesforce 管理员和业务分析师可做长期维护;
- 2 亿人中 25% 是周活跃用户;
- 所有客户互动必须为预测型 AI 工具而保留。
最佳方案:Big Objects + Tableau CRM。分析需要一次性在 5000 万条以上的记录上运行,数据应存储在 Big Objects 中,并用 Tableau CRM 做分析——这套配置 Salesforce 管理员和业务分析师即可维护,同时所有互动都被保留用于预测型 AI。
Mango
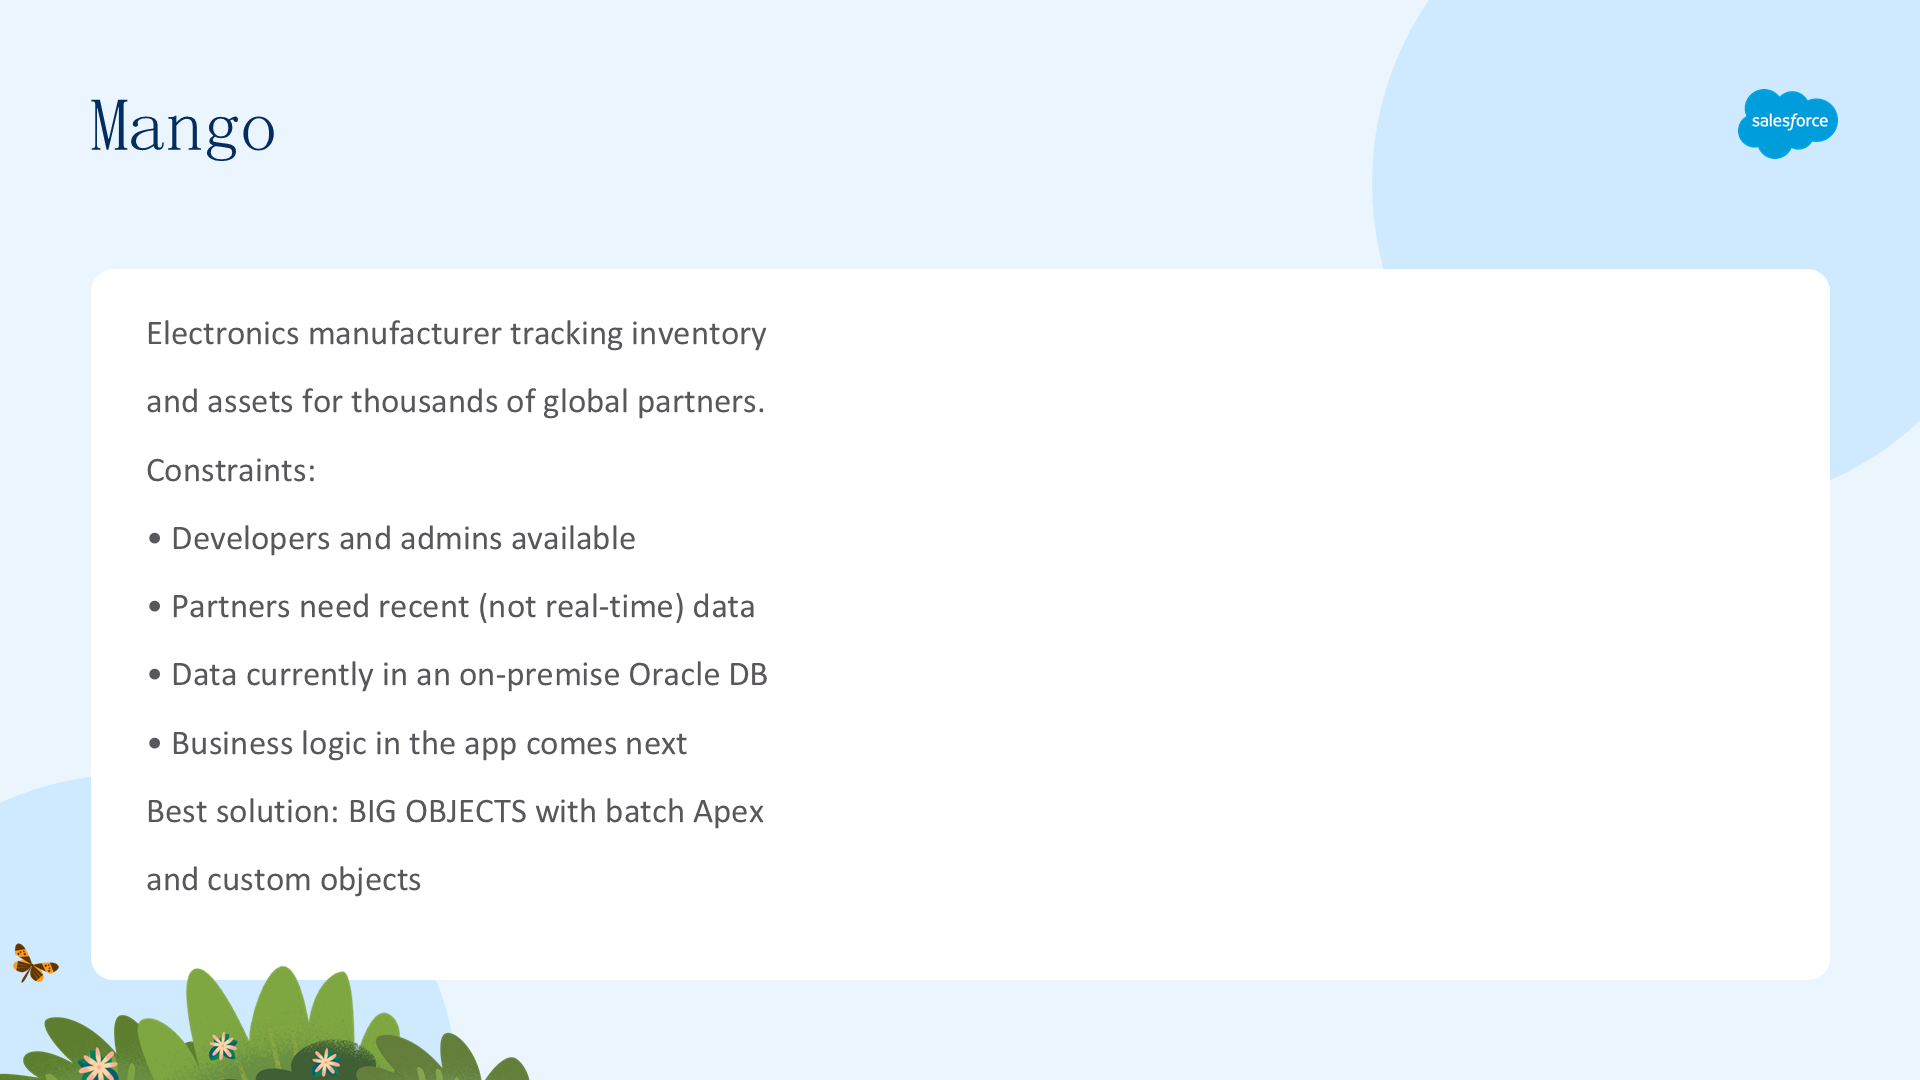
Mango 是一家电子制造公司,需要追踪库存和资产的存储方案,并要把数据开放给全球数千家合作伙伴。约束如下:
- 有开发者团队和 Salesforce 管理员可做长期维护;
- 合作伙伴需要近实时的库存与位置数据(不必实时);
- 数据目前存放在本地的 Oracle 数据库中,报表非常困难;
- 实施后,把尽可能多的业务逻辑融入应用将是下一优先级。
最佳方案:Big Objects + Batch Apex + 自定义对象。Big Objects 存储海量数据,合作伙伴社区则暴露一个较小的子集——用 Batch Apex 同步到自定义对象,让合作伙伴获得近实时的库存与位置数据,同时保留业务逻辑的扩展空间。
ETailored
ETailored 是一家创业公司,开发了一款面向客户的数字个人购物应用。其客服代表用 Salesforce 处理客户问题,并通过问卷收集反馈。近期应用爆红,数据量随之激增,约束如下:
- 初始实施时用的是标准与自定义对象;
- 只有一名管理员和一名开发者做长期维护;
- 问卷量从每年几十万增长到数百万;
- 问卷数据必须为审计保留,但只有过去 6 个月的数据需要立即可分析。
最佳方案:标准对象 + 自定义对象 + Big Objects。日常业务继续沿用标准与自定义对象,问卷量增长到数百万后,用 Big Objects 归档 6 个月以上的数据(满足审计保留),而只有最近 6 个月的数据留在快速对象中供即时分析——这个组合非常适合小团队。
答案(Answer Key)
下面汇总四家公司的推荐方案及理由:
- Frysco → Heroku + 数据复制:移动用户没有 Salesforce 许可证、且可能长时间离线。
- Rockify → Big Objects + Tableau CRM:需要一次性在 5000 万条以上记录上运行分析。
- Mango → Big Objects + Batch Apex + 自定义对象:把数据子集暴露给合作伙伴社区。
- ETailored → 标准/自定义对象 + Big Objects:归档 6 个月以上的问卷数据。
熟悉了这一系列数据存储方案之后,你已经能根据具体需求,为任何业务场景选出最合适的大数据解决方案了。