01 开始使用 Seeding(Get Started with Seeding)
Seeding(种子填充)能把 Salesforce 沙盒和 Scratch Org 用你所需的确切数据快速填充起来。本单元先看清"数据困境"——为什么手工录入测试数据行不通,再了解 Seeding 如何解决这些难题,接着逐项梳理它的核心能力,最后量化它给管理员和其他角色带来的业务价值。
学完本单元,你将能够:
- 解释沙盒环境中开发与测试面临的常见挑战;
- 说明 Seeding 如何应对 Salesforce 沙盒的常见挑战;
- 阐述 Seeding 的核心能力;
- 描述 Seeding 给 Salesforce 管理员及其他角色带来的核心收益。
数据困境:为什么手工录入行不通(一)(The Data Dilemma (1))
作为 Salesforce 管理员或开发者,你几乎每天都在构建新功能、增强现有功能。要确保这些新开发按设计工作,团队必须进行严格的测试——挑战正是从这里开始的。
手工创建测试数据是一个巨大的时间黑洞。这个过程繁琐又容易出错,会把开发者和 QA 宝贵的注意力从更有创新性的任务上拉走。每一个新功能都需要特定的数据场景,而针对每个测试周期手工重建这些场景,很快就会成为瓶颈。
更棘手的是,从 Salesforce 这样高度关系化的平台复制或迁移数据非常复杂。举个例子:如果你为了测试复制一条客户(Account)记录,你还需要一并复制它关联的联系人(Contact)、商机(Opportunity)、案例(Case),以及挂在该客户下的各种自定义对象。手工保持这些复杂的数据关系,是一个让人头疼的大难题。
数据困境:为什么手工录入行不通(二)(The Data Dilemma (2))
沙盒刷新(sandbox refresh)对部分复制(Partial Copy)和完整(Full)沙盒来说是个不错的方案,但并不是每次都能按需要的频率去刷新。而开发者(Developer)、开发者专业版(Developer Pro)以及 Scratch Org 更是没有一个简单的方法来填充数据,导致团队只能基于过时的数据进行构建或测试——结果不准确,Bug 也就悄悄溜进了生产环境。
最后,客户演示和新员工培训也需要当前、相关且真实的数据。缺少这些,演示和培训就会变得干瘪、缺乏说服力。总体而言,这些挑战最终会拖慢开发周期、拉低测试质量,并引入不必要的风险,影响组织为客户交付价值的能力。
Seeding:Salesforce 数据挑战的解决方案
Seeding 直击这些普遍存在的沙盒数据管理难题:它能把数据集从 Salesforce 生产 Org 或沙盒中填充到各类 Salesforce 沙盒(Developer、Developer Pro、Partial Copy、Full),甚至填充到 Scratch Org。
它的工作方式是:先构建模板(Template),用它定义来源 Org 中一组相关联数据的子集;然后用这些模板快速、反复地向任意沙盒播种数据,并保持完全一致的元数据结构。
这意味着你可以快速为沙盒供给特定测试或培训场景所需的确切数据,省下大量时间,同时提升数据质量。
Seeding 功能 — 模板与数据结构(Template and Data Structure)
Seeding 提供了一整套工具和方法,用来定义你要播种数据的结构和关系,帮助你构建、管理和共享模板,确保数据集的一致性和精确性。
- 模板管理(Template Management):构建并管理模板来定义数据集、可视化对象关系,并在整个组织内共享这些模板,从而保证测试环境之间数据配置的一致性和可复用性。
- 保持对象关系(Maintain Object Relationships):Seeding 会保留 Salesforce 复杂的数据关系。Levels 模板会按层级自动纳入相关记录(例如为 Account 对象自动纳入所有相关对象),而 Nodes 模板则让管理员显式选择要纳入哪些相关对象。
- Nodes 模板:添加每一个你想播种的对象。你从一个被称为"根对象(root object)"的单个对象开始,再加入子对象以及可选的父对象,还可以继续添加任意多个根对象。这种方法要求你对来源数据层级有深入了解。
- Levels 模板:先选择你想播种的第一批对象(通常位于数据层级的顶端),这些就是你的根对象;对每个根对象,只需指定要向下纳入多少层数据层级来包含额外的相关对象。
- Generate 模板:先添加所有你希望"生成合成数据再播种到沙盒"的对象(根、子、可选父对象)。
Seeding 功能 — 数据控制与完整性(Data Control and Integrity)
这些功能让你对即将播种的数据拥有细粒度控制,从而保证数据质量、相关性和完整性,帮助你筛选、抽样和管理数据,打造一个完美的测试环境。
- 灵活筛选(Flexible Filtering):使用简单而强大的过滤器,精确选择你想纳入播种数据的记录或记录类型。这种细粒度控制确保你的沙盒只包含相关数据。
- 覆盖率功能(Coverage Feature):使用"按覆盖率抽样(Sample for Coverage)",确保你的沙盒拥有一份具有代表性的数据集,能反映生产 Org 中取值的完整分布。
- 灵活的数据源(Flexible Data Sources):既可以从实时生产 Org 播种以获取最新实时数据,也可以从备份中播种。从备份服务播种需要 Backup & Recover。
- 生成并播种合成数据(Generate and Seed Synthetic Data):无需选择播种源,即可生成合成数据并直接播种到沙盒。Generate 模板让你无需从生产 Org 或另一个沙盒复制数据,就能为对象创建相关的测试数据。当开发者和测试者把 Seeding 与 Anonymize 结合使用时,可以省去手工创建测试数据或寻找合适复制源的麻烦。
Seeding 功能 — 运营与高级功能(Operational and Advanced Features)
这些功能精简了播种过程本身,聚焦于运营效率、自动化和排障,旨在改善数据管理任务的整体工作流和可靠性。
- 增量播种(Incremental Seeding):利用增量播种来微调你的数据集,实现高效更新,而不必每次都做完整的数据刷新。
- 排障与报告(Troubleshooting and Reporting):使用 Seeding Summary 报告快速排查权限或数据问题,该报告能提供播种过程的洞察。
- 自动化管理(Automation Management):Seeding 提供选项,在播种过程中禁用 Salesforce 触发器自动化。这个功能就像一位"交通警察",防止这些自动化在新插入的数据上触发而产生意料之外的副作用或错误。
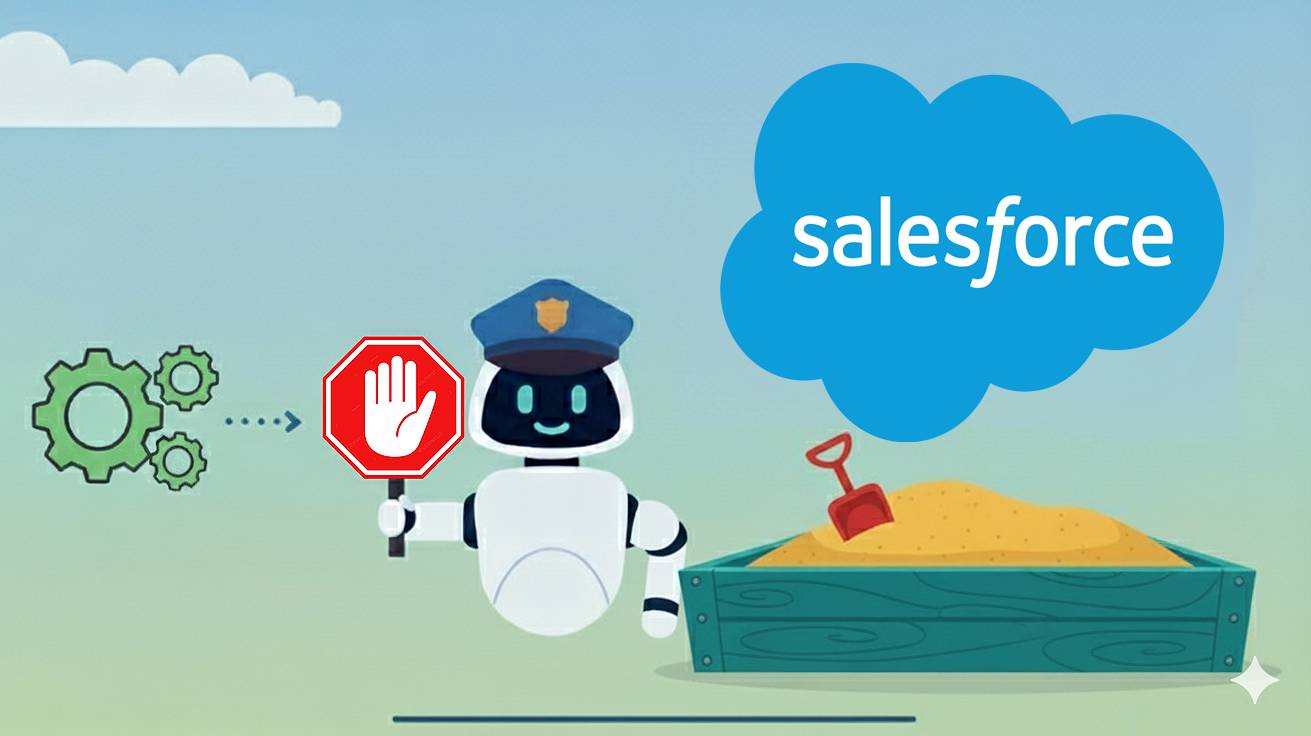
上图形象地展示了自动化管理的作用:一个机器人举着国际通用的"停止"手势,挡在代表自动化的齿轮前面,阻止自动化在 Salesforce 沙盒中发生。
Seeding 的业务价值(The Business Value of Seeding)
对 Salesforce 管理员和开发者而言,Seeding 带来了实实在在的收益和业务价值。
- 降低运营成本:自动化的数据供给和减少的手工录入,降低了与 Salesforce 开发和测试相关的运营成本,可带来约 12.7 万美元的基于生产力的 ROI。
- 加速上市时间:随时可用且真实的数据带来高效的开发和测试周期,从而更快地把新功能推向市场。使用 Seeding 的应用团队生产力提升了 12%。
- 赋能管理员:无需手工录入或复杂的数据加载工具操作,就能快速为开发、QA、销售和培训等不同团队供给相关数据的沙盒。
- 提升测试质量:QA 和 UAT 测试者能够基于类似生产的数据进行更全面、更准确的测试,从而在开发生命周期早期就发现 Bug,确保更高质量的发布。
- 简化演示与培训:Seeding 让你轻松用定制数据做引人入胜的客户演示,也为新员工提供贴近真实场景、可动手学习的沙盒。
通过自动化 Salesforce 沙盒和 Scratch Org 的播种流程,你让团队在正确的时间拿到正确的数据,进而实现更快的创新和更稳健的 Salesforce Org。
02 构建 Seeding 模板并运行任务(Build Seeding Templates and Run Jobs)
理解了 Seeding 的价值之后,接下来看看如何实际设置并运行你的第一个 Seeding 任务。本单元涵盖使用 Seeding 的先决条件、三种不同类型的 Seeding 模板,以及如何准备、运行和监控一个 Seeding 任务。
学完本单元,你将能够:
- 识别 Seeding 设置的先决条件和初始考量;
- 区分不同类型的 Seeding 模板;
- 准备、运行并监控一个 Seeding 任务;
- 监控任务进度并解读报告。
Seeding 实施的先决条件与初始设置考量
在开始使用 Seeding 之前,需要先落实几个基础要素,以确保流程顺畅高效。
- 理解你的 Salesforce Schema:熟悉组织的 Salesforce Schema 和对象关系,对构建准确有效的 Seeding 模板至关重要。
- 定义你的用例:清晰勾勒出你的具体目标来指导方法。例如,质量保证测试的数据播种需求可能与培训完全不同。明确的目标能帮助你决定哪种 Seeding 模板最适合,需要多少个不同的模板,以及要包含哪些对象。
- 梳理组织的敏感数据:提前规划如何对敏感数据(尤其是来自生产环境的数据)进行匿名化处理,以确保沙盒环境的合规性。
- 了解组织的自动化:留意目标沙盒中的 Salesforce 触发器自动化,因为播种数据可能触发这些自动化。Seeding 提供自动禁用并重新启用这些自动化的选项,像"交通警察"一样,在你准备好让它们运行之前阻止自动化触发。
- 建立 Seeding 界面的外部账户登录:创建那些连接相关 Org 和沙盒的服务。
Nodes、Levels 还是 Generate 模板:该用哪个?
Seeding 提供三种类型的模板:Nodes、Levels 和 Generate。理解它们之间的差异,有助于你为数据播种需求选择正确的方法。
- Nodes 模板:需要你显式添加每一个对象——根对象、子对象和可选的父对象,提供精确控制,但要求你深刻理解 Schema。
- Levels 模板:只需添加根对象并指定向下包含的数据层级数,配置更简单,覆盖范围更广。
- Generate 模板:构建方式与 Nodes 类似,但它生成的是合成数据,而不是从某个源复制数据。
Nodes 模板
Nodes 模板要求你添加每一个想播种的对象,包括起始的根对象、任意子对象,以及可选父对象。这个过程要求你对来源数据层级有详细的了解。Nodes 模板提供对播种数据的精确控制。
在以下场景考虑使用 Nodes 模板:
- 特定数据集:当你需要播种一个非常精确的数据子集,并且对对象关系有清晰理解时。
- 复杂层级:当数据模型复杂、需要显式定义每一个要包含的对象时。
- 预定义模板:对于配置、定价、报价(CPQ)、Salesforce Field Service 以及 nCinoStarter 这类复杂的基于记录的配置,可用的 Predefined Nodes 模板能够应对特定行业用例。这些模板通过一套预填充的基线数据对象帮你节省时间,还可以根据你的 Org 进一步定制。
Levels 模板
Levels 模板只要求你添加想播种的根对象。对每个根对象,你还可以指定向下包含多少层数据层级,从而纳入额外的对象。例如,从 Account 对象向下两层,意味着你选择了直接连接到 Account 的对象,以及连接到这些对象的对象。这个过程不需要你对来源数据层级有详细了解。
在以下场景考虑使用 Levels 模板:
- 更广的数据集:当你需要播种一组更广泛的相关数据,而不必手工逐个选择对象时。
- 简化的配置:当你更倾向于一种精简的模板创建方式时,尤其是当你知道需要某一层级以下的全部数据,或者不确定每一个具体对象时。
Generate 模板
你构建 Generate 模板的对象层级的方式与 Nodes 模板相同——添加所有必要对象:根对象、子对象和可选父对象。不过,使用 Generate 模板时,你还可以在 Seeding 任务中生成合成数据。
构建 Generate 模板不需要播种源,但它确实需要一个你选择的 Anonymize 模板的引用。当你用 Generate 模板运行 Seeding 任务时,任务会先用 Anonymize 模板的对象字段定义生成必要的合成数据(每个对象 100 条记录),然后再把数据播种到 Generate 模板中指定的目标沙盒。Anonymize 模板和 Generate 模板必须配置为相同的对象。
筛选数据并选择源与目标
Nodes 和 Levels 模板都支持为 Seeding 筛选记录,确保你只填充所需的数据。
Seeding 允许你把数据集从 Salesforce 生产 Org 或 Salesforce 沙盒(这些被视作播种源)填充到各种目标,包括 Salesforce 沙盒(Dev、Dev Pro、Partial Copy、Full)、Scratch Org,甚至是生产 Org。注意,向生产 Org 播种需要 Master Admin 权限和 Backup & Recover。
若要最新数据,你可以从所选源的实时版本播种;或者,也可以使用源的备份版本,或任意其他生产 Org 的备份。
选择你的 Seeding 方法
执行 Seeding 任务时,可从以下方法中选择:
- 增量(Incremental):从模板向目标插入新记录。Seeding 只管理它插入的记录,不会更新或修改已有记录,也不会改动由之前 Seeding 任务手工加载或创建的记录。
- Upsert:向目标插入新记录,并更新已有记录。
- 清理并插入(Clean and Insert):该方法先删除目标中 Seeding 模板所定义的每个对象的所有已有记录,再从源插入这些对象的所有记录。模板之外的对象不受影响。Seeding 不会删除自动克隆的对象,如 Users、Product2 和 PriceBook——这些对象在沙盒创建时会被自动纳入。
准备并运行 Seeding 任务
要配置一个 Seeding 任务,需要为你的数据指定目标服务,并选择一个方法(Incremental、Upsert 或 Clean and Insert)。你还可以选择禁用 Salesforce 自动化。配置好这些设置后,一键即可开始数据填充流程。
监控任务进度并解读报告
Seeding 任务开始后,可以从 Recent Seeds 标签页监控进度。该标签页显示当前正在处理的对象、记录数量,以及将要播种的记录总数。
任务完成后,Seeding 会通过电子邮件向你发送状态通知。
你还可以访问以下详细报告:
- Seeding Report:汇总一个已完成的 Seeding 任务,帮助你排查阻止记录插入或删除的问题。报告包含失败记录汇总、失败原因、任务时长以及每个阶段的分解。错误按类型和对象分组。报告还包含可下载的日志文件,其中列出了所有被抓取的记录 ID,以及在目标中新创建或更新的记录 ID。最后,报告还包含一个错误日志文件,列出未能插入或更新的记录 ID。
- Salesforce Automations Report:列出在任务开始时被禁用、并在任务完成后重新启用的所有 Salesforce 自动化,以及任何相关的错误或警告。
调度 Seeding 任务
Seeding 支持调度循环任务和一次性任务。这个功能对于为持续开发、测试或培训维护最新沙盒尤其有用。例如,你可以调度一个每周任务,用最新生产数据刷新沙盒,从而消除手工干预。
一次性任务适用于特定场景,比如为新项目准备沙盒、复现一个生产 Bug,或为一场重要演示搭建干净的环境。通过自动化例行任务并在需要时精确供给专用环境,调度为你提供了更强的控制力和效率。
03 应用 Seeding 最佳实践(Apply Seeding Best Practices)
本单元提升你的实操水准——涵盖测试数据管理的最佳实践、常见任务问题的解决方案,以及需要围绕其进行设计的局限性。
学完本单元,你将能够:
- 应用管理测试数据的最佳实践;
- 识别常见任务问题并描述解决方案;
- 描述 Seeding 功能的一些局限性。
测试数据管理最佳实践(一):理解你的 Schema
要确保播种过程高效成功,第一步是彻底理解你的 Schema:仔细审查对象关系,尤其关注你计划播种的那些具体对象。这是一个关键的第一步,能极大提高数据成功填充的可能性——它能防止你对"模板到底会拉进来什么"感到意外。
测试数据管理最佳实践(二):优化目标环境的元数据
在复制记录(尤其是较旧的记录)之前,请确保目标 Org 的结构能够容纳即将到来的数据。这包括检查正确的记录类型、选择列表值以及依赖关系,以防止 Salesforce 报错。
提前准备好目标环境的结构,可以避免那些本会在播种过程中打断流程的 Salesforce 错误。
测试数据管理最佳实践(三):精简模板设计
保持模板简单有效:
- 避免冗余的根对象。即使一个对象在模板中多次出现,Seeding 也会智能地防止重复。
- 子对象会自动继承根对象上的筛选条件。因此你只需配置一次筛选,就能让它向下级联,从而简化配置、保持模板干净。
测试数据管理最佳实践(四):管理用户对象
Seeding 的智能自动化会替你处理用户对象,因此通常你无需手工纳入它们:
- 自动克隆:用户记录会在沙盒创建和沙盒刷新期间被自动克隆,以防止权限错误。
- 映射:来自 Salesforce 刷新的标准用户通过其邮箱进行映射。
- 未匹配的用户:在源中存在但目标中不存在的用户,会被映射到当前已认证用户。
- 添加缺失用户:如果你的组织需要添加缺失的用户,可以把用户对象添加到 Nodes 模板中——这一能力是 Nodes 类型独有的。
- 排除的类型:某些用户类型(如 Owner 和 Case Team 联系人)不会被自动克隆,因为它们不影响播种过程。
常见任务问题与解决方案(一):常见错误
运行 Seeding 任务时,你可能会遇到与数据完整性和权限相关的错误。下面是一些示例:
- 无效的交叉引用键(Invalid Cross-Reference Key):某个被引用的父记录在 Seeding 任务中缺失,或当前已认证用户缺少必要权限。
- 已删除的实体(Deleted Entity):某条源记录引用了目标中已被删除的记录。
- 选择列表值错误(Picklist Value Error):源中的某个选择列表值在目标环境中未启用或已不再有效。
常见任务问题与解决方案(二):解决方案
下面是一些解决上述问题的建议:
- 确保所有被引用的父对象都包含在你的模板中;
- 核实相关对象和记录类型的用户权限是否正确;
- 确认所有必要的选择列表值在目标环境中都已启用且有效;
- 如果沙盒中发生了手工数据变更,在向目标播种时选择"重新索引(re-indexing)",让 Seeding 能正确引用沙盒中已有的记录。
常见任务问题与解决方案(三):Salesforce 自动化错误
除了数据完整性错误,你还可能遇到自动化、重复数据或字段限制相关的问题。
Salesforce 自动化错误:
- 原因:通常是 Salesforce 中处于活动状态的触发器或验证规则阻止了数据插入或更新。
- 解决方案:考虑在播种过程中临时禁用自动化,或修改你的模板或数据集,使其符合活动中的自动化规则。Seeding 的自动化管理选项让第一种做法变得很容易。
常见任务问题与解决方案(四):重复数据错误
重复数据错误:
- 原因:当 Salesforce 在记录插入或更新过程中发现匹配的唯一标识符时,就会生成错误。
- 解决方案:启用索引(indexing)来审查目标中的现有数据;或者使用字段映射(Field Mapping),按唯一字段值而不是按记录 ID 来映射。
Seeding 功能的局限性
虽然 Seeding 是一款强大的工具,但了解一些会影响你数据播种策略的局限性也很重要。
该应用目前不支持播种若干对象和字段类型,包括但不限于:
- Big Objects(大对象)
- 计算字段(公式字段,Calculated/formula fields)
- Chatter 对象
- 外部对象(External objects)
- Case Article 对象
- 标签(Tags)
在规划播种策略时,要留意这些限制,让你的方案始终保持在受支持的范围内。
Seeding 功能局限性(一):Levels 模板的限制
使用 Levels 模板时,请牢记以下限制:
- 附件和内容处理:附件(Attachment)和内容文档在播种过程中会被跳过(不会被播种,也不会用占位文件替换)。
- 批量大小:你无法为 Levels 模板减小批量大小。
- 对象和字段支持:某些对象和字段不受支持,包括 AgentWork、Calendar 和 FeedItem 对象。
- 非必填父对象:虽然必填父对象会被自动纳入,但非必填父对象只能在模板内添加到根对象上。
Seeding 功能局限性(二):一般性限制
以下限制更广泛地适用于播种过程:
- 数据量:单个任务中根记录的数量、单个模板中对象的总数都存在固有的数量上限。
- 大规模解决方案:对于非常大或复杂的数据量,你可能需要拆分任务或简化模板,以确保最佳性能。