一、探索大语言模型数据掩码
本单元学习为什么对 LLM 掩码敏感信息至关重要,以及 Einstein Trust Layer 的功能——检测、掩码与去掩码。
学完本单元,你将能够:解释对大型语言模型(LLM)掩码敏感信息的重要性、描述 Einstein Trust Layer 的功能。
为什么 LLM 数据掩码很重要
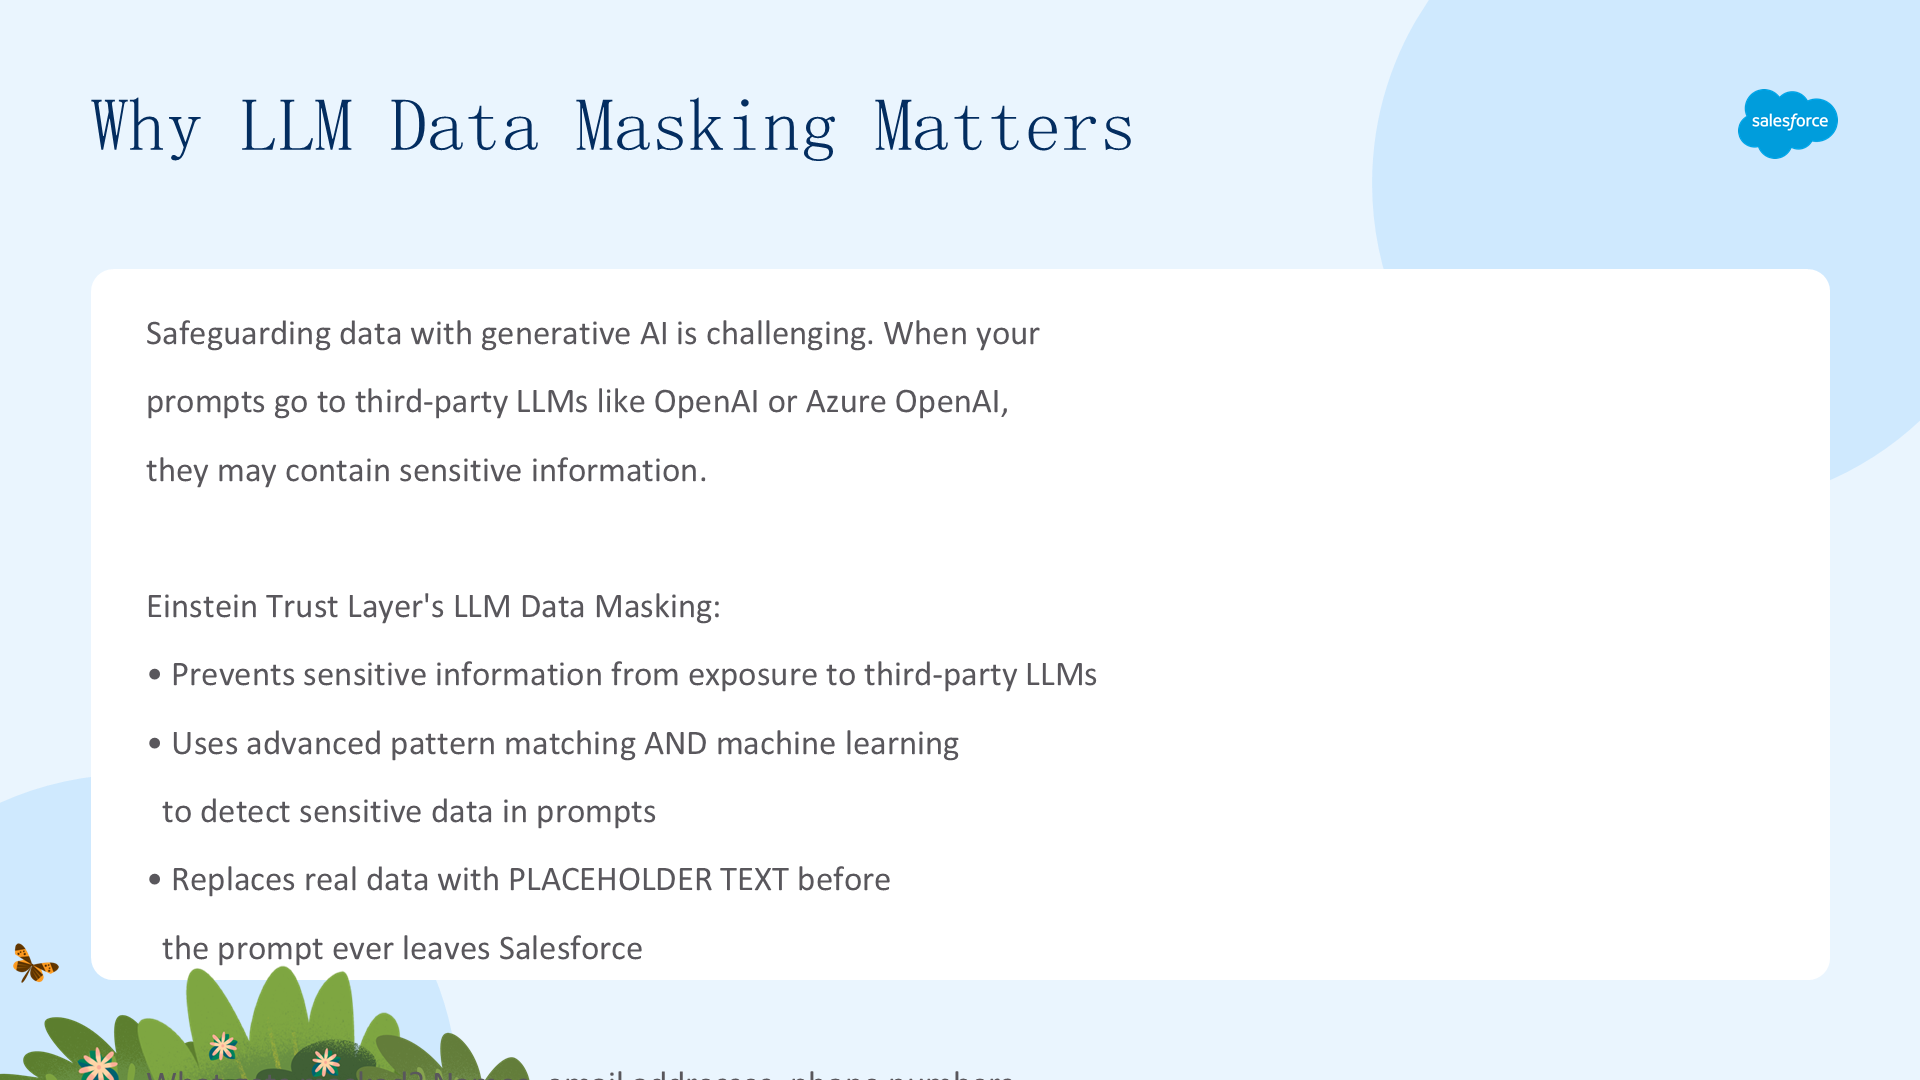
用生成式 AI 保护数据充满挑战。当你的提示发送给 OpenAI、Azure OpenAI 等第三方 LLM 时,其中可能包含敏感信息。Einstein Trust Layer 的数据掩码有助于防止敏感信息暴露给第三方 LLM——这就是"LLM Data Masking"名称的由来。它用先进的模式匹配与机器学习检测提示中的敏感数据,把真实数据替换为占位文本后再把提示发送出去。被掩码的包括:姓名、邮箱、电话号码、信用卡号、社会安全号、公司名等(可根据风险画像配置)。重要:面向 agent 的 LLM 数据掩码是禁用的;它适用于 Einstein Service Replies、Einstein Work Summaries 等嵌入式生成式 AI 功能。
检测与掩码如何工作
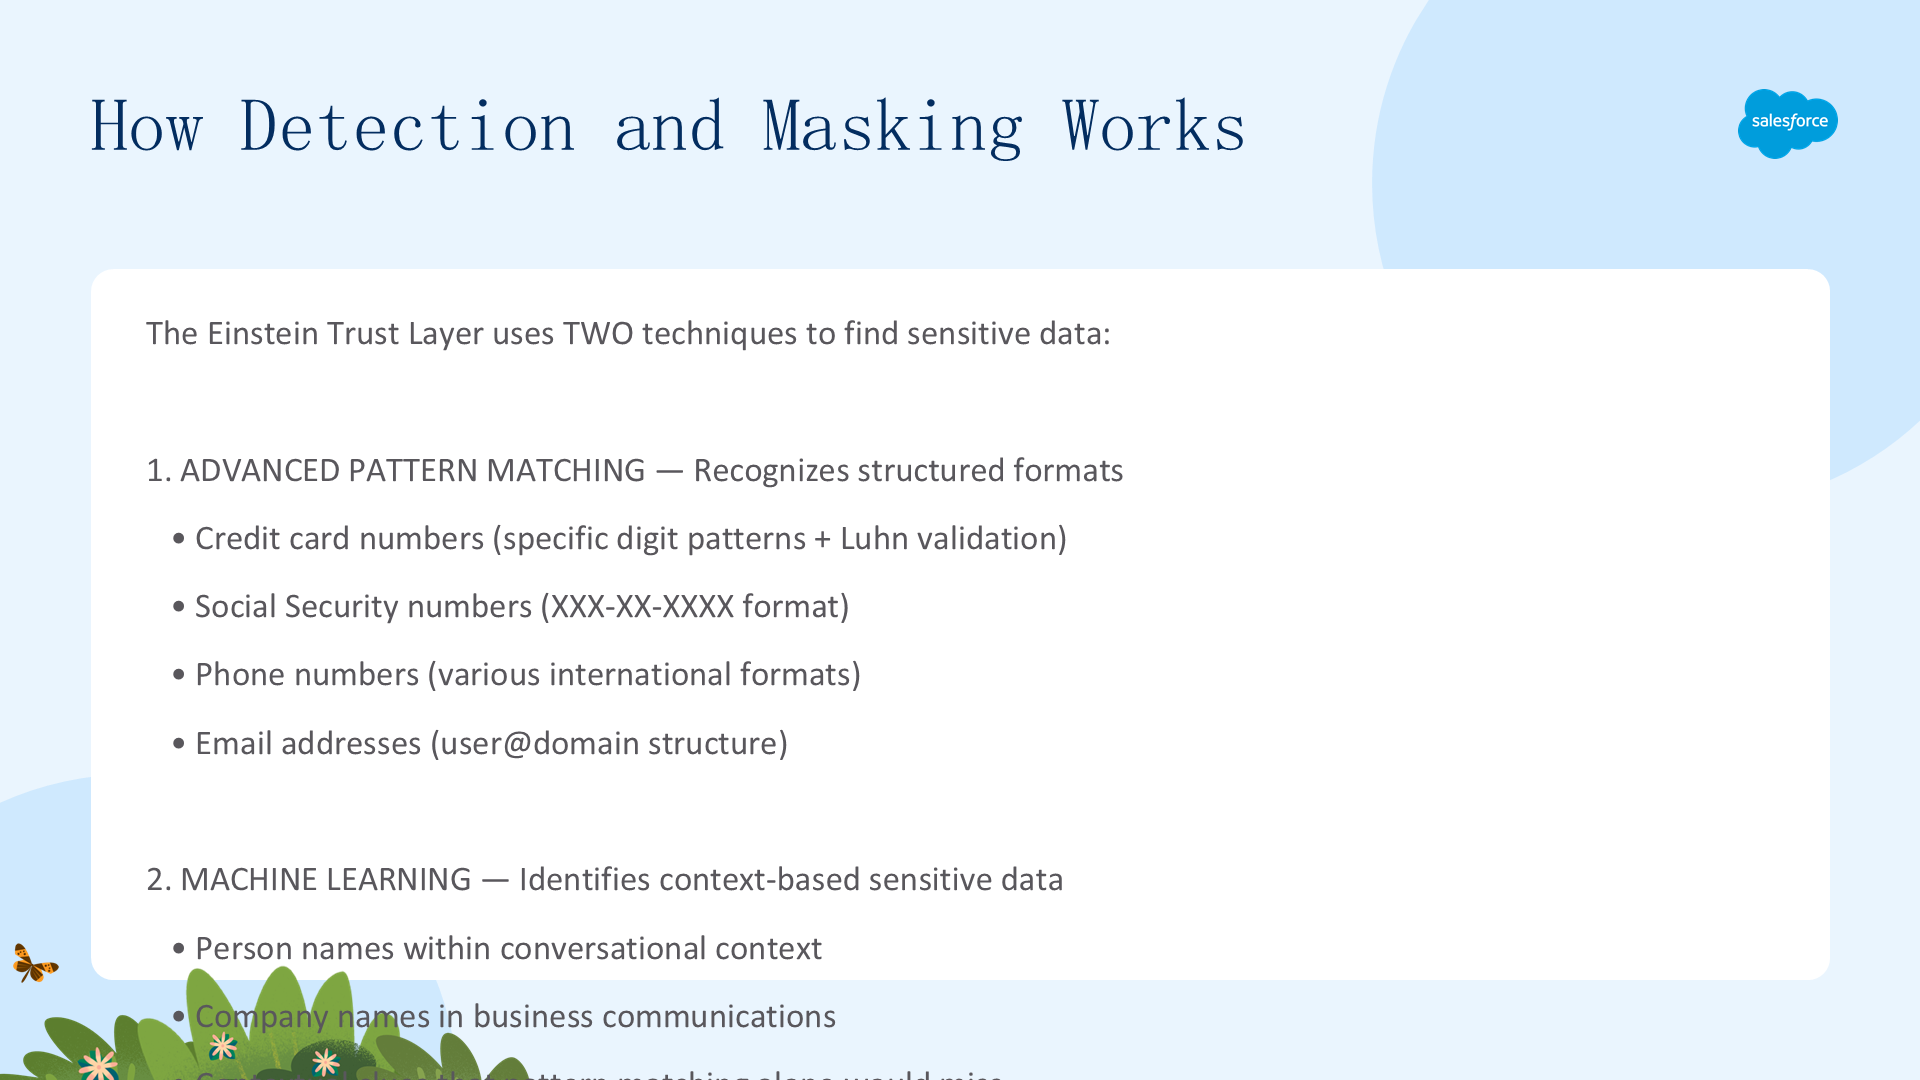
Einstein Trust Layer 用两种技术发现敏感数据:高级模式匹配识别结构化格式(信用卡号、SSN 的 XXX-XX-XXXX 格式、电话号、邮箱的 user@domain 结构);机器学习识别基于上下文的敏感数据(对话上下文中的人名、商务沟通中的公司名等模式匹配会漏掉的信息)。检测后数据被替换为占位文本——例如 "Jim" 变为 <Person_0>(第一个发现的人名),"jim@example.com" 变为 <Email_0>。占位符保留了提示的语义结构,让 LLM 仍能理解问题,但真实敏感数据从未离开 Salesforce。
去掩码——还原原始数据
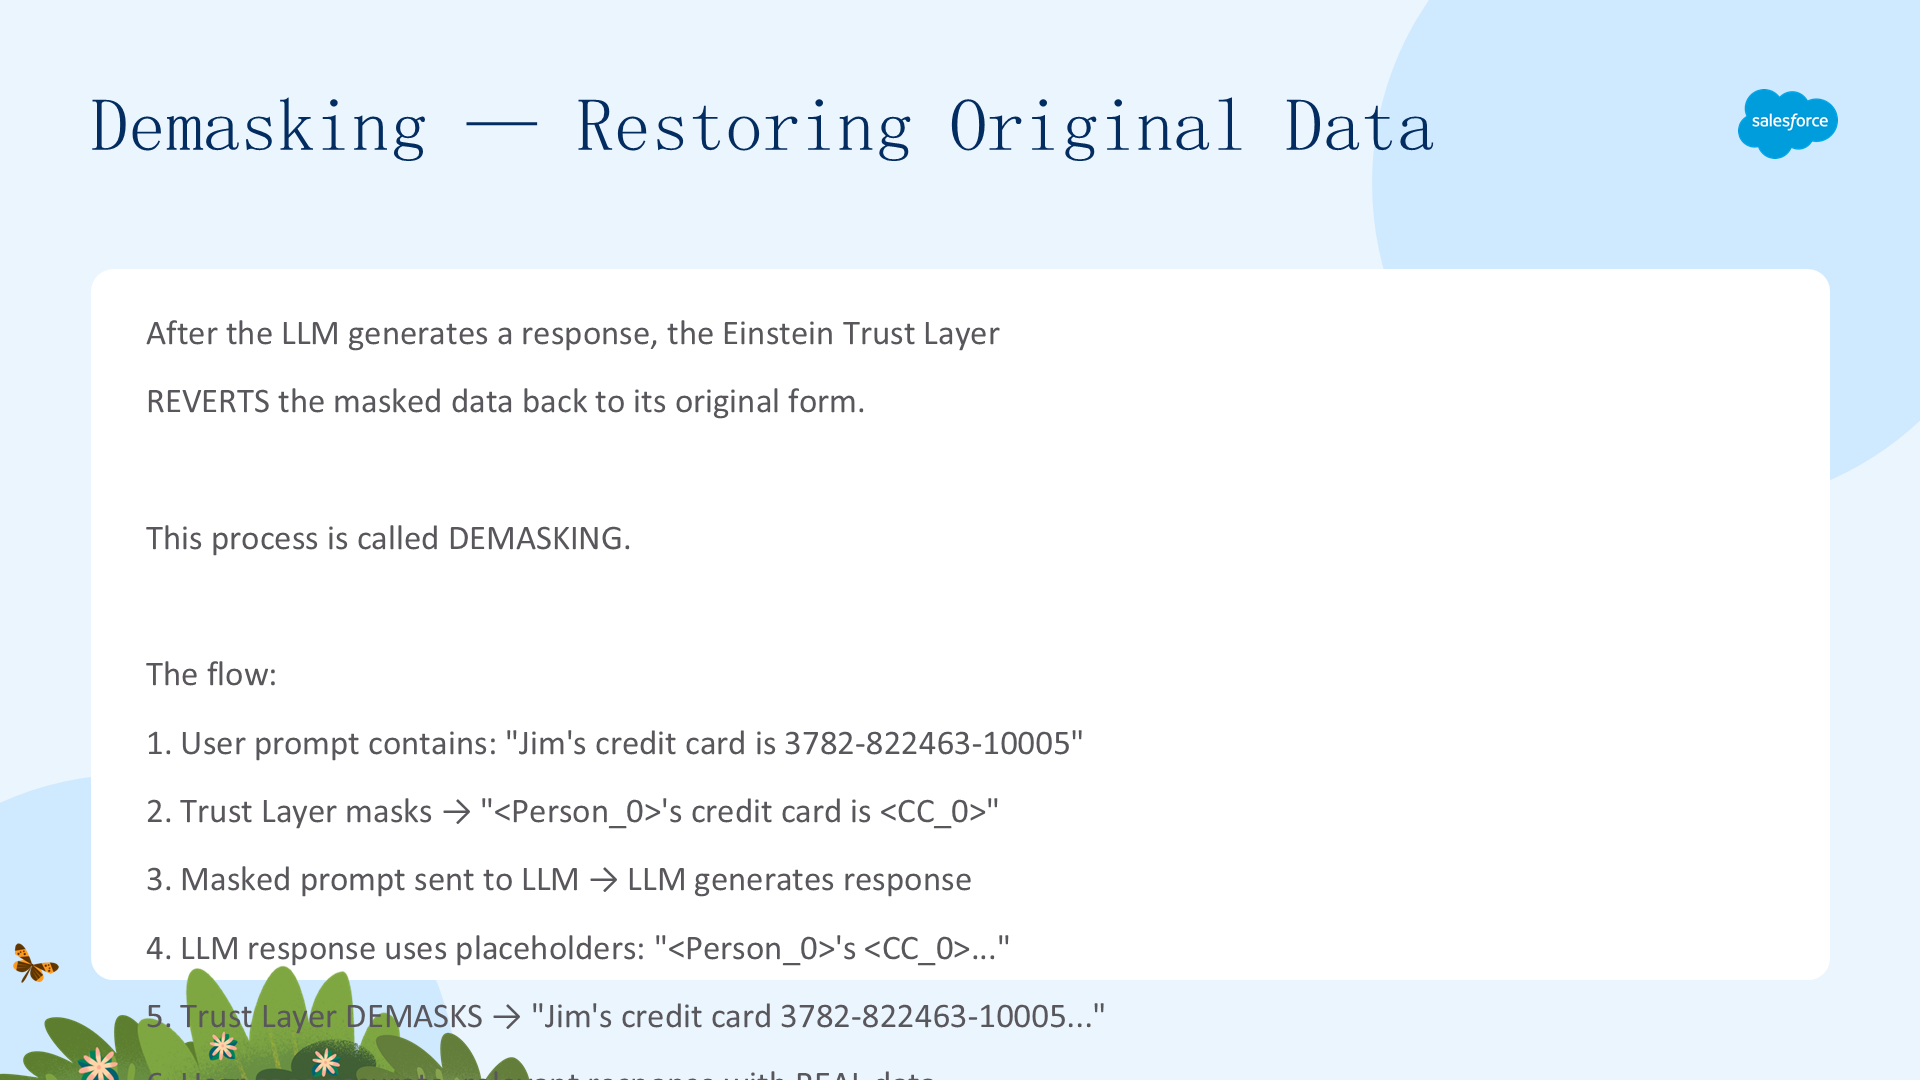
在收到 LLM 生成的响应后,Einstein Trust Layer 把被掩码的数据还原为原始形式,这个过程叫去掩码(demasking)。流程:用户提示含真实数据 → Trust Layer 掩码成占位符 → 掩码后的提示发给 LLM → LLM 用占位符生成响应 → Trust Layer 去掩码还原真实数据 → 用户看到准确、相关的响应。去掩码确保:响应准确、相关;敏感数据从未暴露给 LLM;用户体验无缝(用户永远看不到占位符)。LLM 从不知道它在谈论 Jim,但 Jim 得到了他的答案。
为数据掩码做准备——风险评估
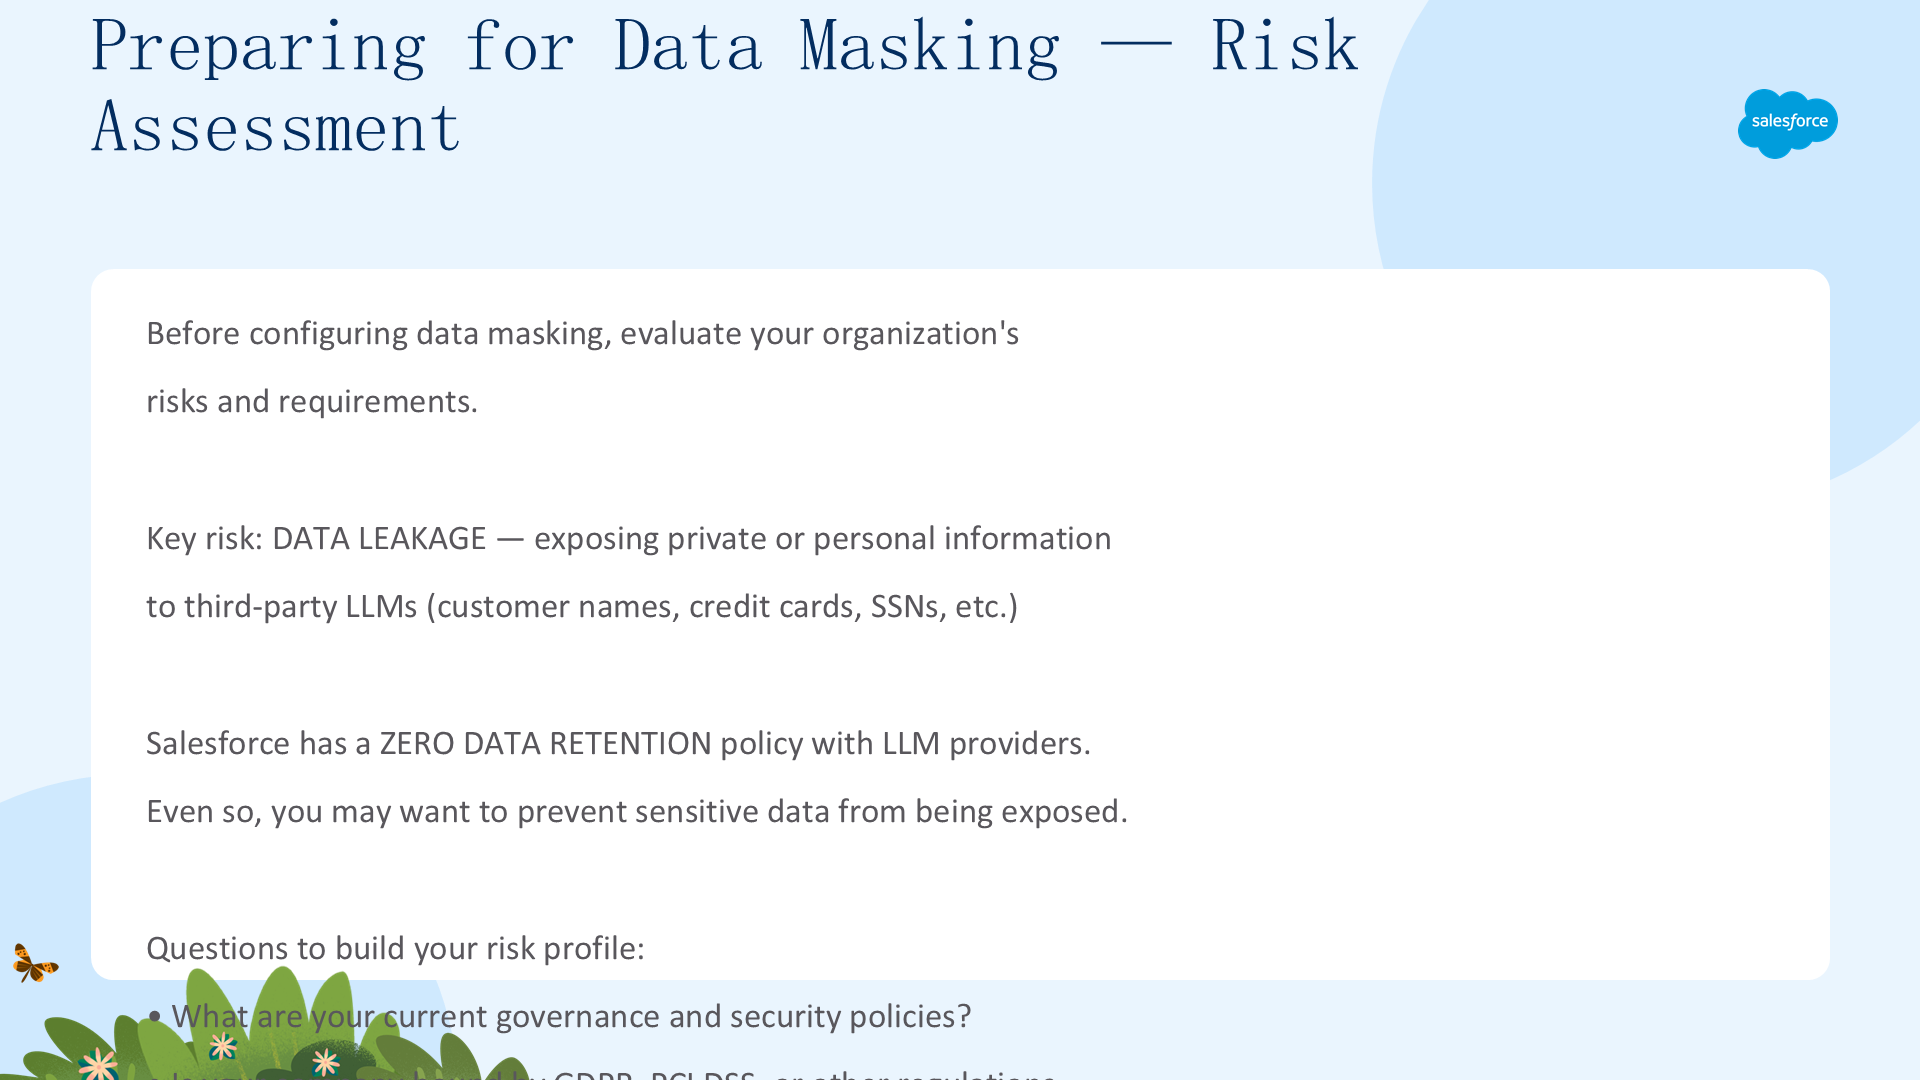
配置数据掩码前,先评估生成式 AI 给业务与用例带来的数据安全与隐私风险。LLM 数据掩码帮助缓解的关键风险之一是数据泄漏——把客户姓名、信用卡号、社会安全号等私人/个人信息暴露给第三方 LLM。Salesforce 与第三方 LLM 提供商(如 OpenAI、Azure OpenAI)有零数据保留策略,你通过提示发送的数据不会被 LLM 保留;即便如此,你仍可能想确保敏感数据不被暴露。建立风险画像的问题:当前治理与安全策略是什么?公司是否受 GDPR、PCI DSS 等数据法规约束?数据驻留要求是什么?敏感数据是否是为生成有用响应而必需的?哪些 AI 用例会在提示中包含敏感数据?你的风险容忍度决定了要掩码哪些数据类型。
掩码的平衡——安全 vs 响应质量
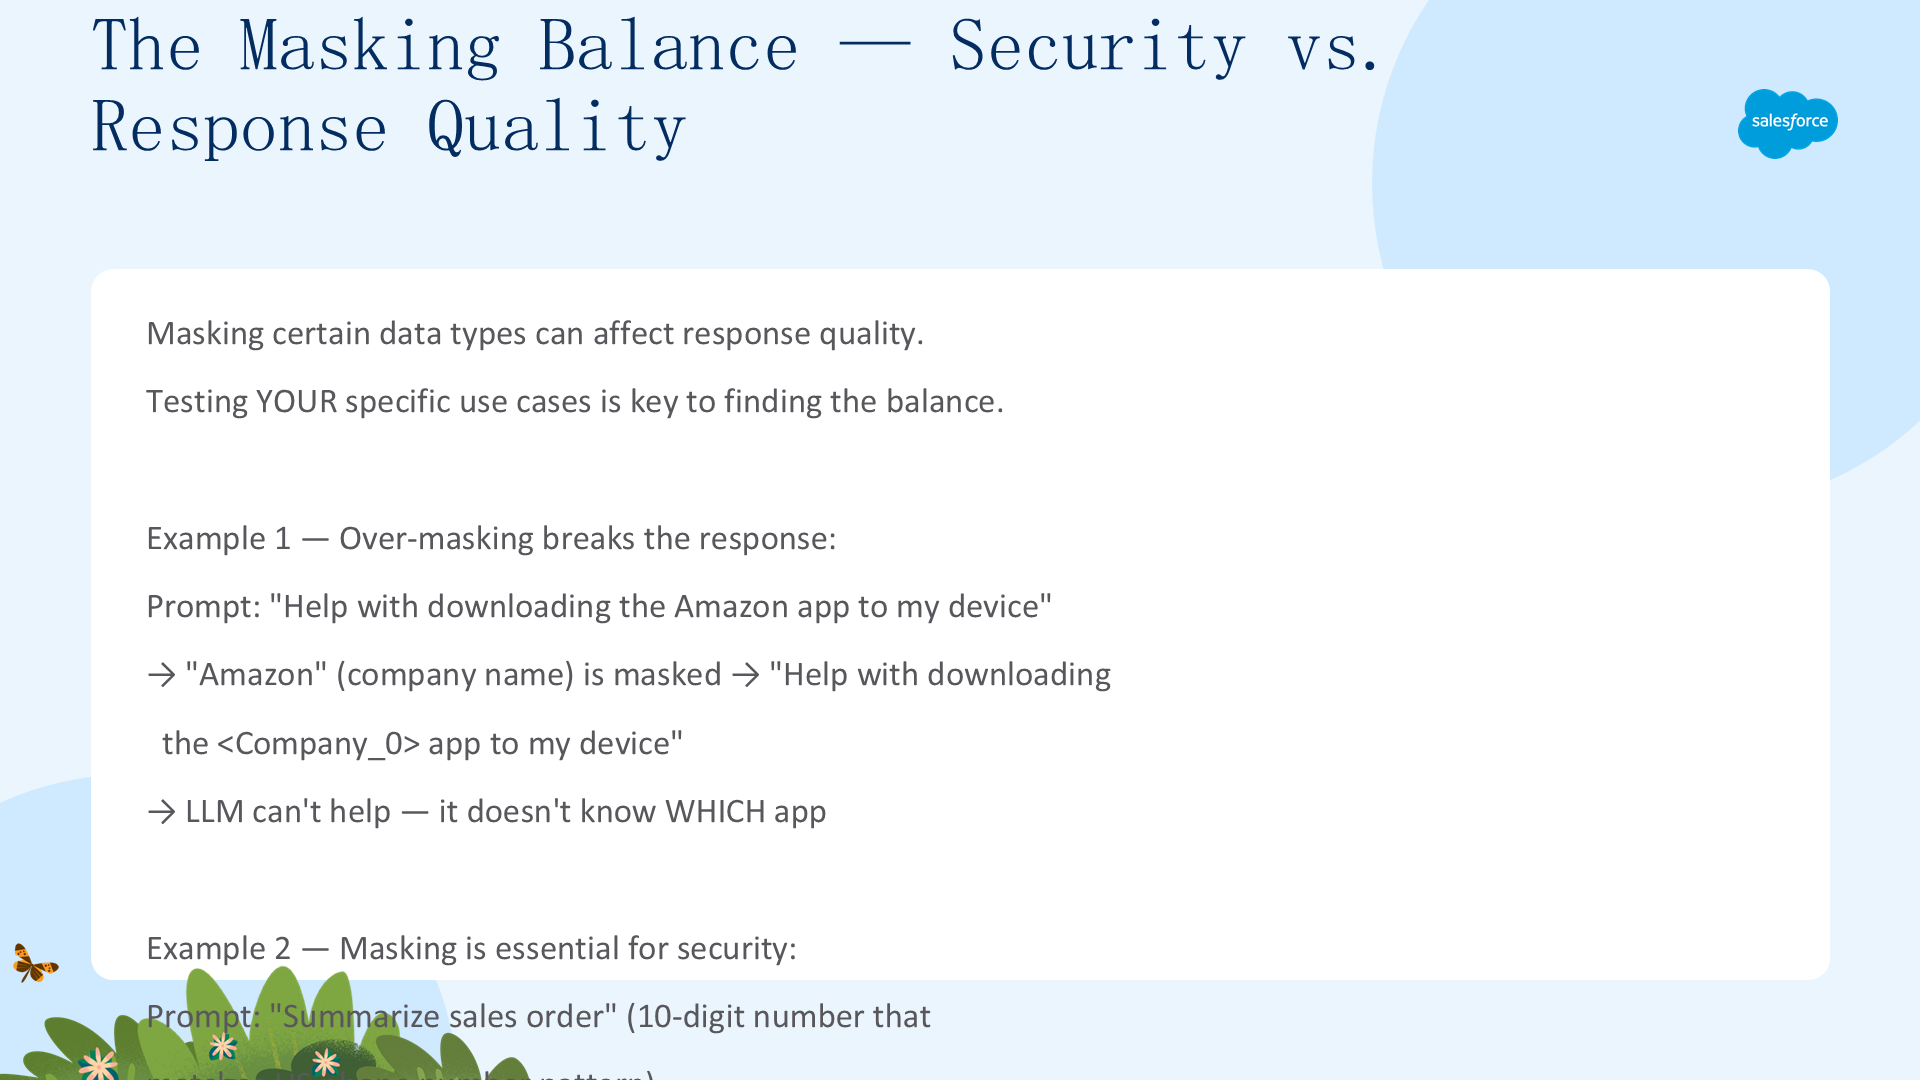
掩码某些数据类型会影响响应质量,测试你的具体用例是找到平衡的关键。示例一(过度掩码破坏响应):提示要求帮助下载 Amazon 应用到设备,但 Amazon 作为公司名被掩码,LLM 不知道你要下载哪个应用,无法给出有用响应。示例二(掩码对安全至关重要):提示要求总结一个销售订单,订单是 10 位数字、与美国电话号格式相似,于是被当作电话号掩码,响应可能不够准确,但保护了可能是真实电话数据的信息。关键原则:掩码 = 安全,但过度掩码 = 降低 AI 质量。针对用例测试每个数据类型,只掩码风险画像所必需的。
Einstein Trust Layer——默认设置与审计
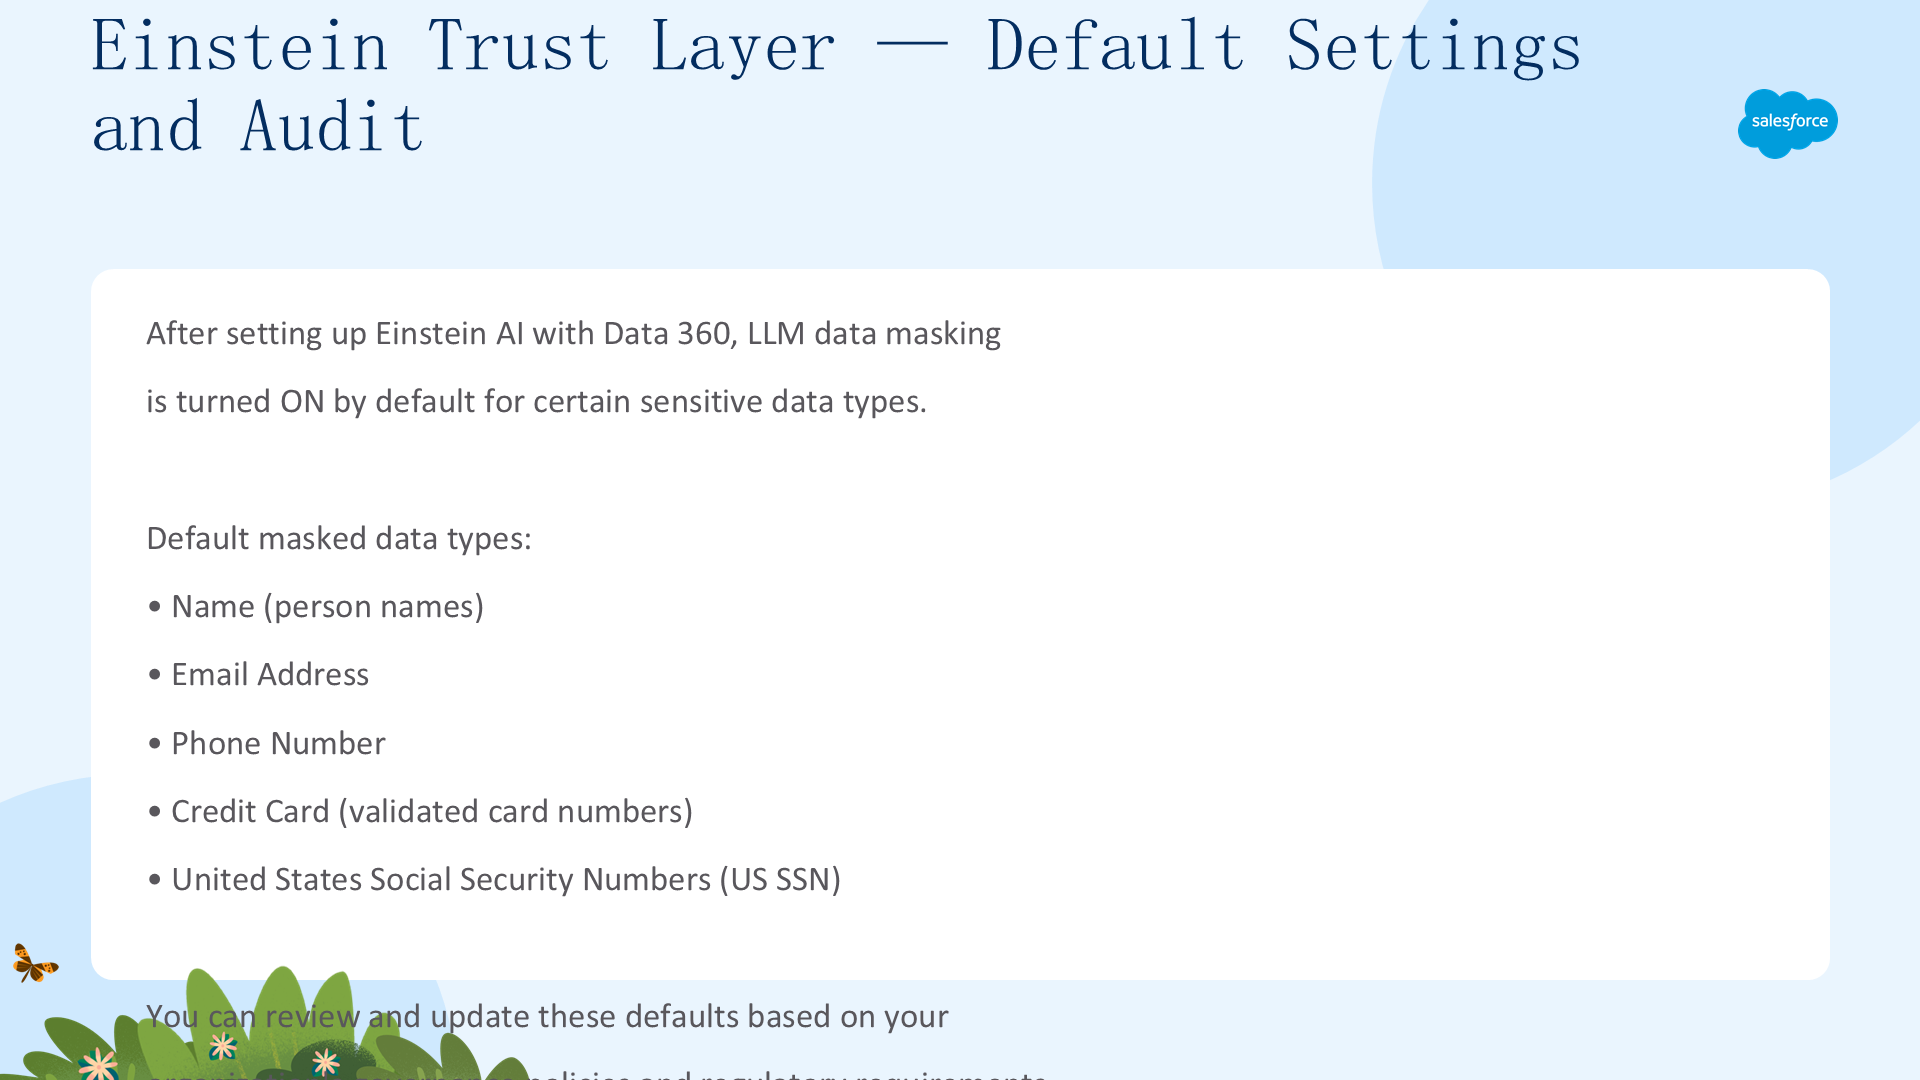
设置 Einstein AI 与 Data 360 后,LLM 数据掩码对某些敏感数据类型默认开启。默认掩码的数据类型:Name(人名)、Email Address、Phone Number、Credit Card(经校验的卡号)、US SSN。你可根据组织治理策略与法规要求审查并更新这些默认值。审计线索:所有数据掩码活动作为审计线索记录在 Data 360 中,可用预置仪表盘验证掩码与去掩码,或创建自定义报告与仪表盘。支持的数据条目与语言:Einstein Trust Layer 支持多种掩码数据类型(公司名、信用卡号、邮箱等),并支持多语言,确保全球运营能符合数据掩码要求。
二、配置 LLM 数据掩码策略
本单元动手配置:注册带 Data 360 与 Einstein AI 的 playground、在 Trust Layer 配置 LLM 数据掩码、在 Prompt Builder 验证掩码数据。
学完本单元,你将能够:注册带 Data 360 与 Einstein AI 的 Custom Playground、配置 Trust Layer 的 LLM 数据掩码、在 Prompt Builder 验证掩码数据。
启用 Einstein 生成式 AI 与 Trust Layer
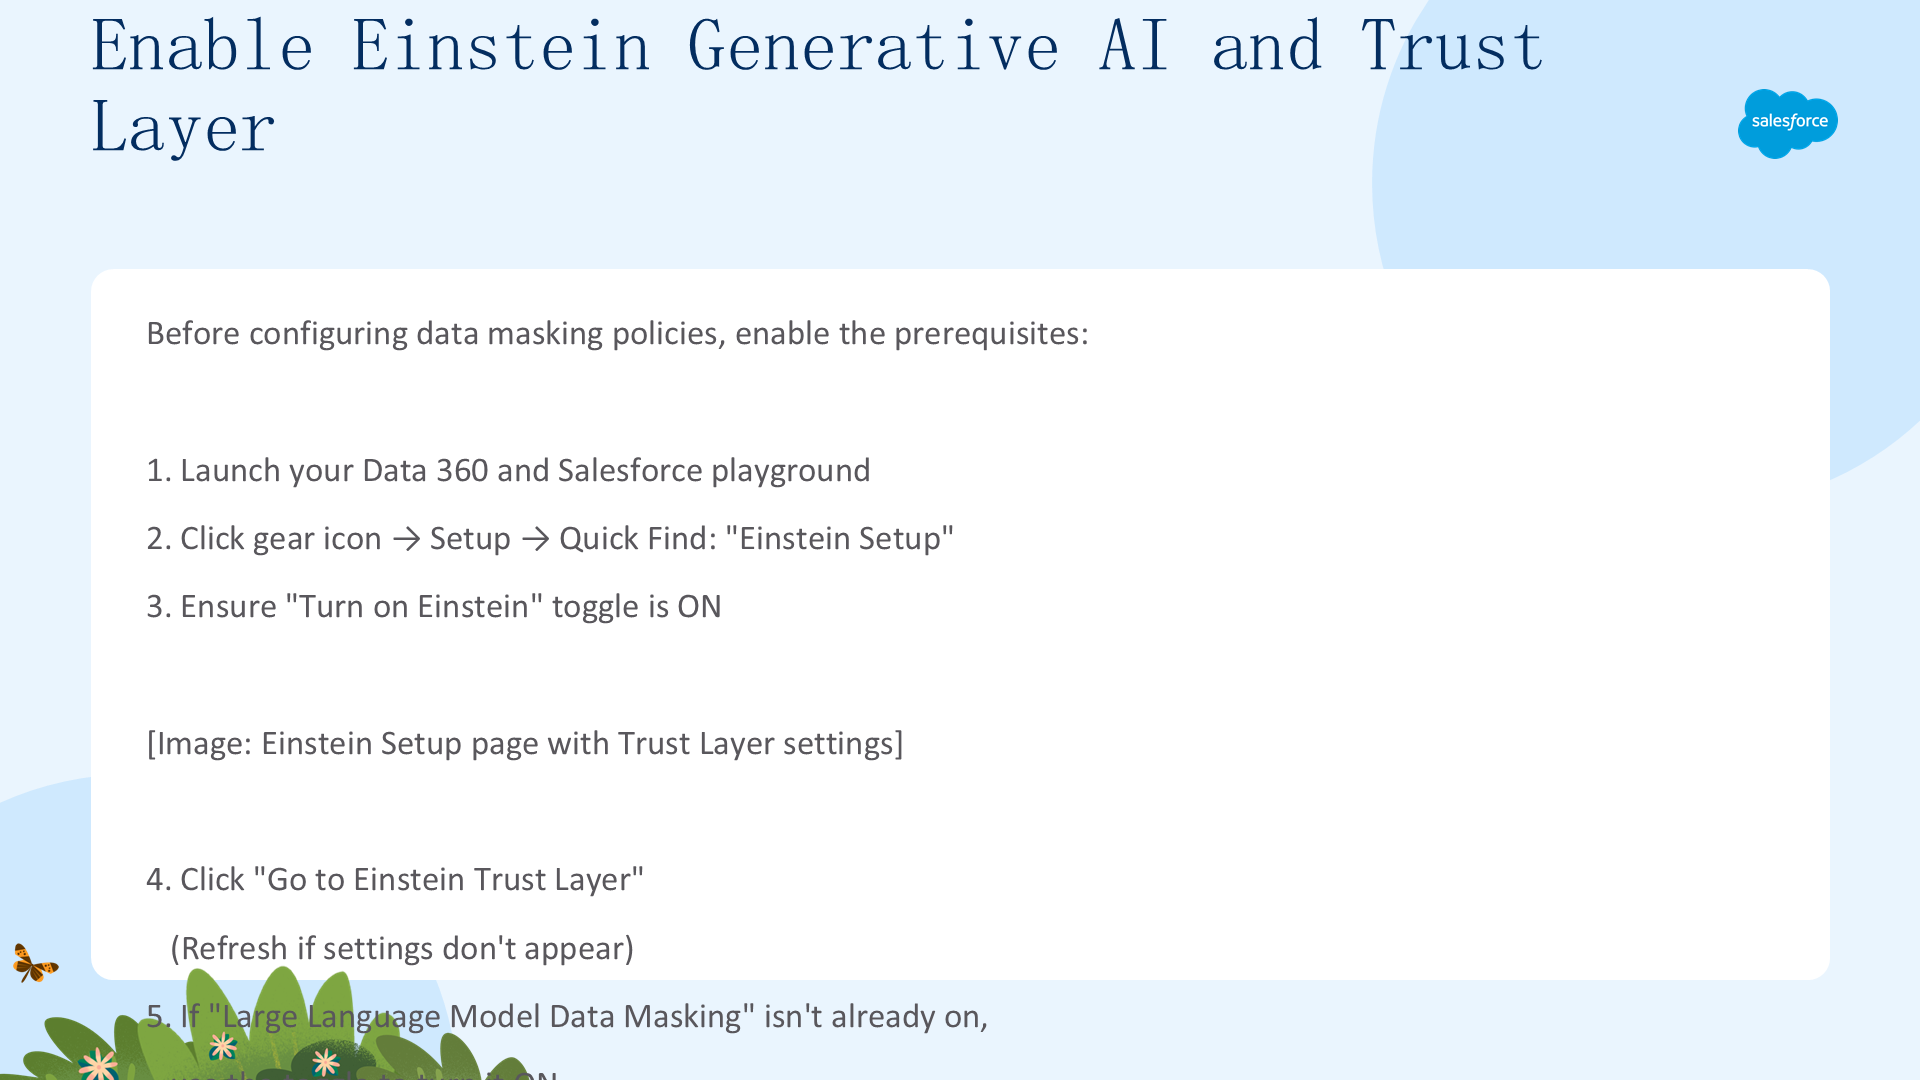
配置数据掩码策略前,先启用前提条件:启动 Data 360 与 Salesforce playground;点击齿轮图标进入 Setup,在 Quick Find 搜索并选择 Einstein Setup;确保 Turn on Einstein 开关为 On。

点击 Go to Einstein Trust Layer(若看不到设置请刷新),如果 Large Language Model Data Masking 尚未开启,用开关打开它。查看列出的敏感数据类型:Name、Email Address、Phone Number、Credit Card、US SSN 默认已掩码。
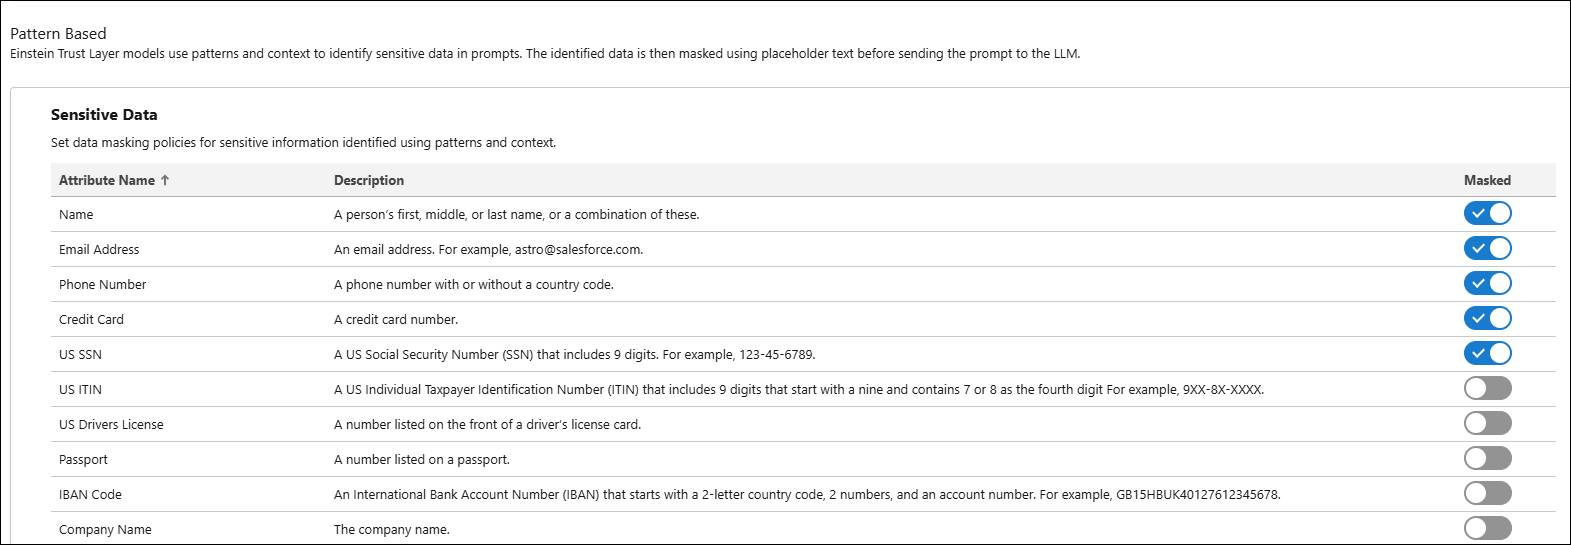
注意 Company Name 默认未掩码——我们稍后在本单元启用它。
启用 Sales Emails 并创建提示模板
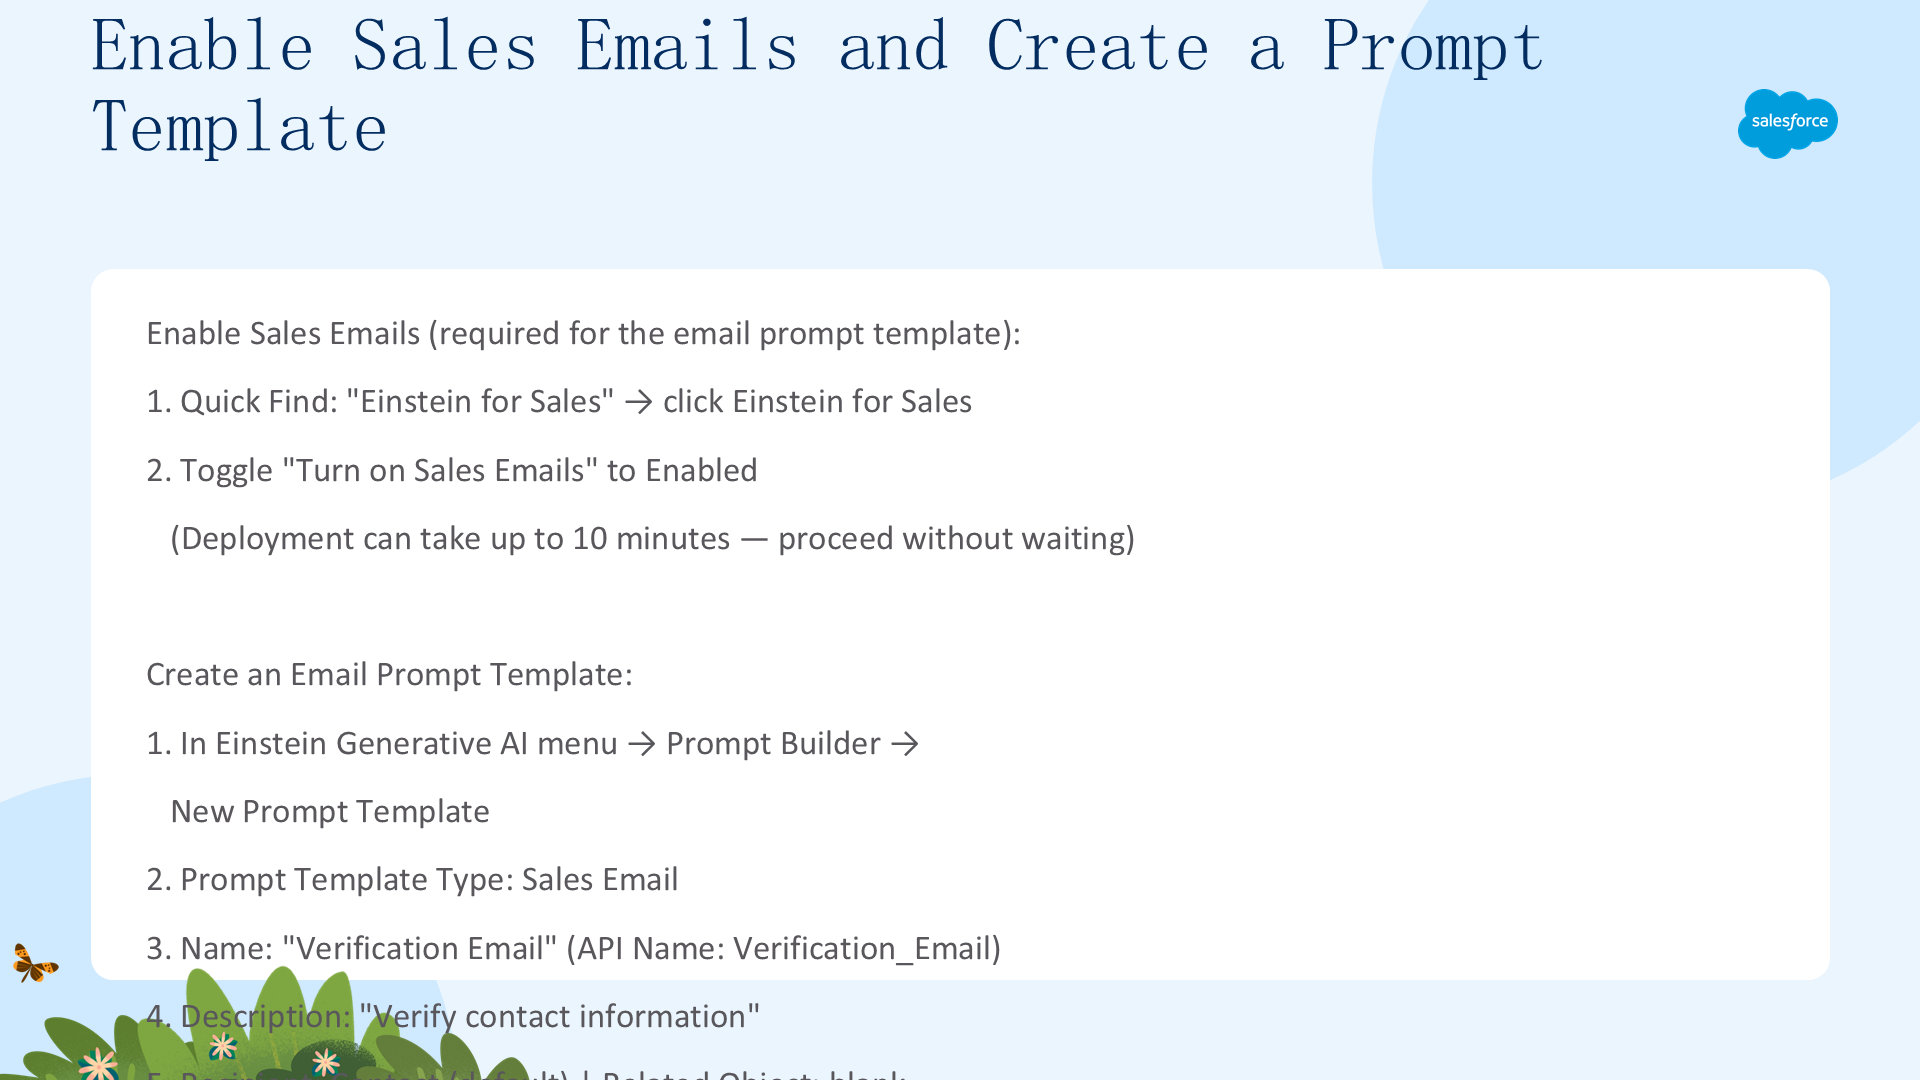
启用 Sales Emails(创建邮件提示模板所需):在 Quick Find 输入 Einstein for Sales,点击 Einstein for Sales,把 Turn on Sales Emails 开关设为 Enabled(部署可能长达 10 分钟,无需等待,继续下一步)。创建邮件提示模板:在 Einstein Generative AI 菜单展开后点击 Prompt Builder,点击 New Prompt Template,Prompt Template Type 选 Sales Email,命名 Verification Email(API 名 Verification_Email),描述填 Verify contact information,Recipient 默认 Contact、Related Object 留空,点击 Next 进入 Prompt Template Workspace。现在你有了实时测试数据掩码的画布。
验证数据掩码的实际效果
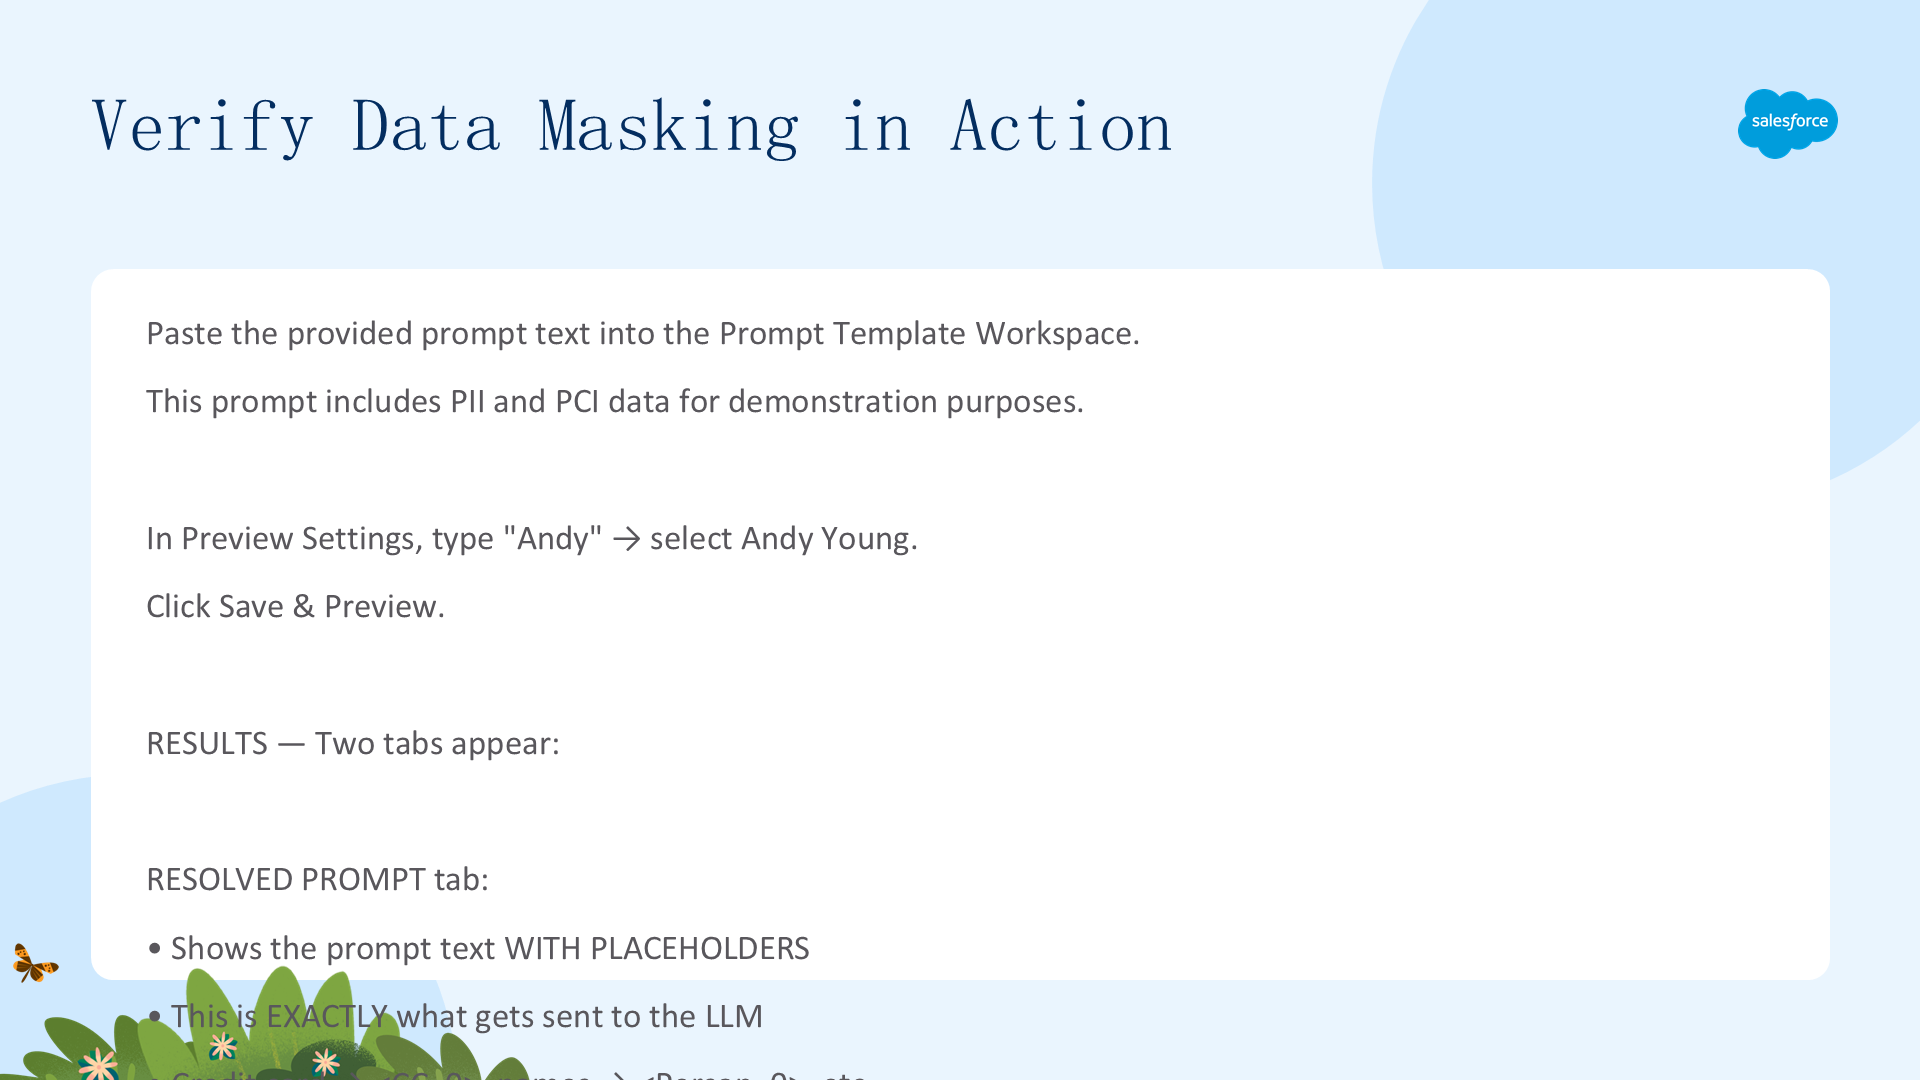
把提供的提示文本粘贴到 Prompt Template Workspace(提示文本包含多个 PII 与 PCI 信息,仅用于演示掩码如何保护数据)。在 Preview Settings 的 Inputs 输入 Andy 并选择 Andy Young,点击 Save & Preview。出现两个标签页:

Resolved Prompt 标签显示带占位符的提示文本——这正是发送给 LLM 的内容,让你预览掩码后的数据;Generated Response 标签显示去掩码后、含真实信息的生成邮件。在 Generated Response 标签点击盾牌图标查看数据掩码详情——你会看到信用卡号、邮箱、人名、两个电话号与 SSN 都被掩码,但公司名当前未掩码。

点击 OK 关闭详情窗口。
更新掩码——启用公司名
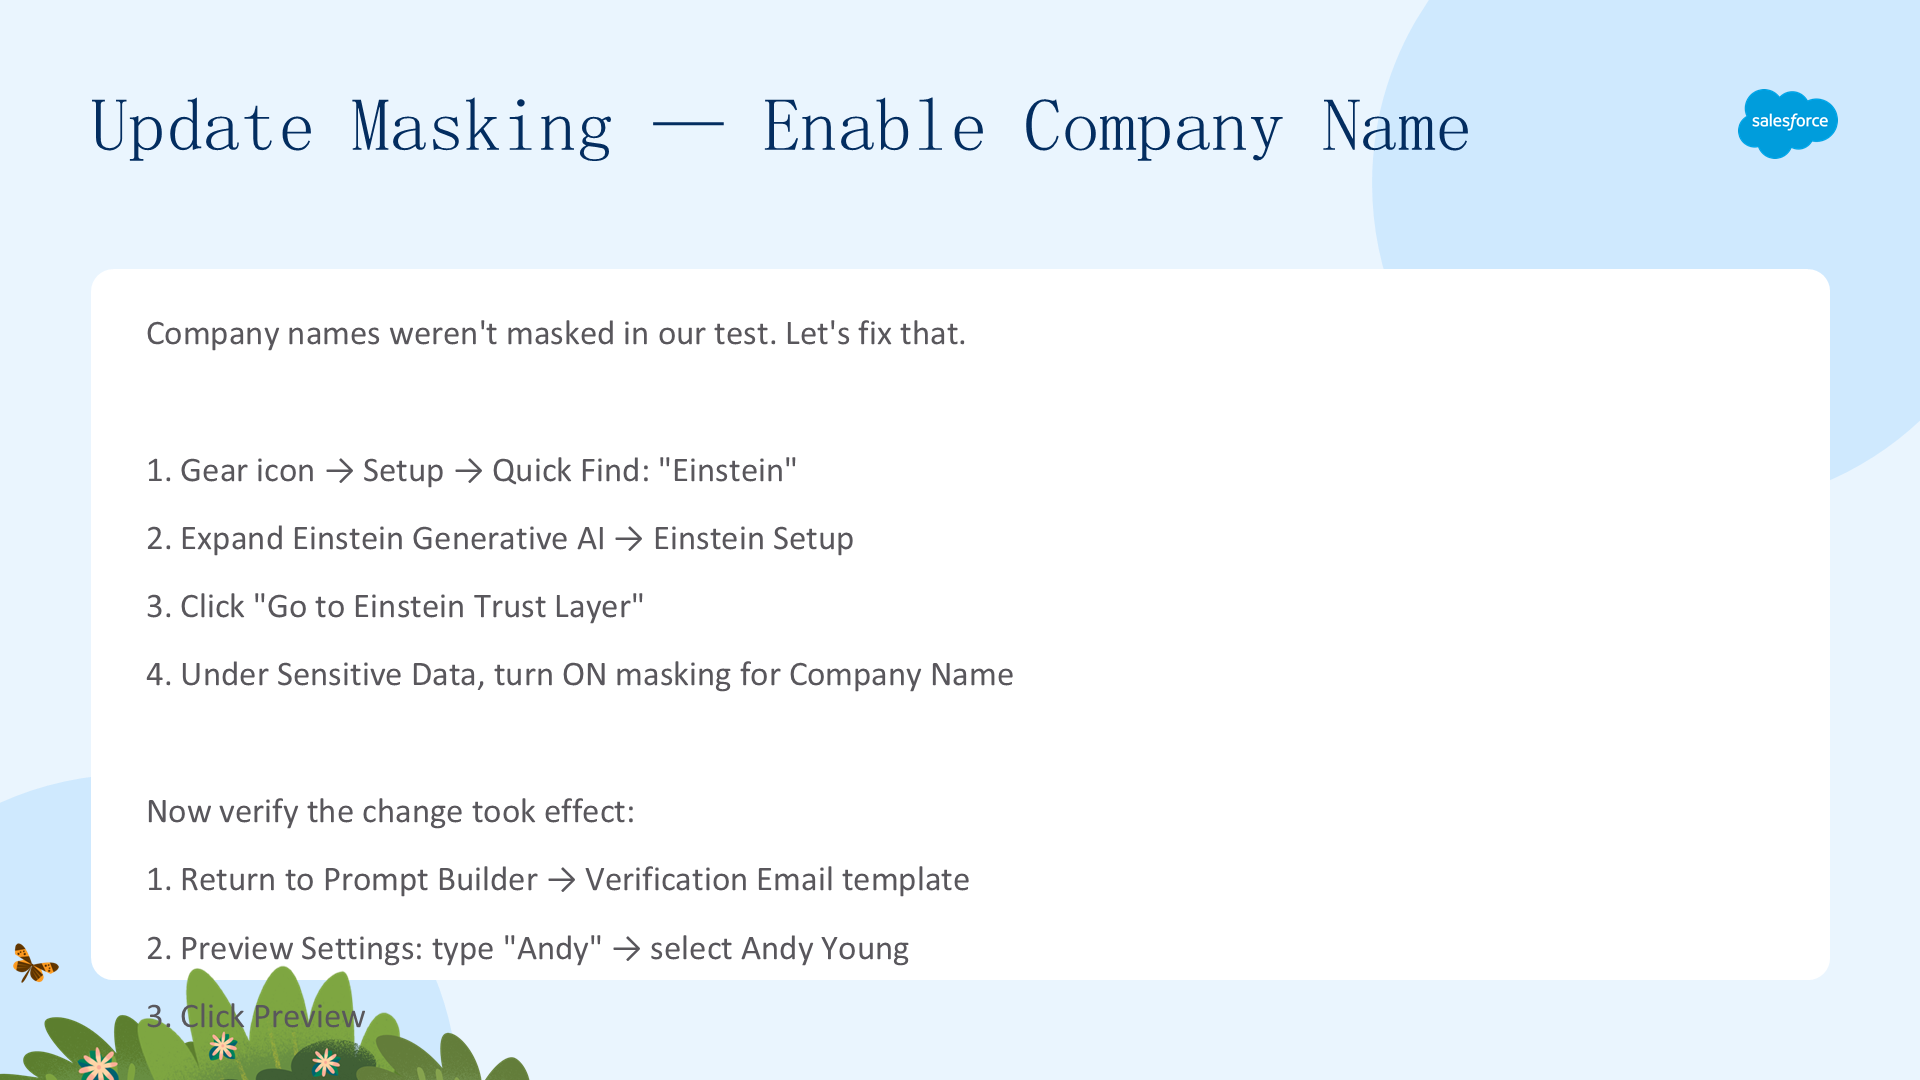
公司名在我们的测试中未被掩码,现在修复它。点击齿轮进入 Setup,Quick Find 输入 Einstein,展开 Einstein Generative AI 菜单点击 Einstein Setup,点击 Go to Einstein Trust Layer,在 Sensitive Data 下打开 Company Name 的掩码。然后验证更改生效:返回 Prompt Builder 打开 Verification Email 模板,Preview Settings 输入 Andy 选择 Andy Young,点击 Preview。注意:LLM 数据掩码更新可能需要几分钟才生效,请耐心等待。在 Generated Response 标签点击盾牌图标,公司名现在应该出现在掩码数据表中。

现在你的掩码策略覆盖了全部六种敏感数据类型。
测试边界情况——无效数据
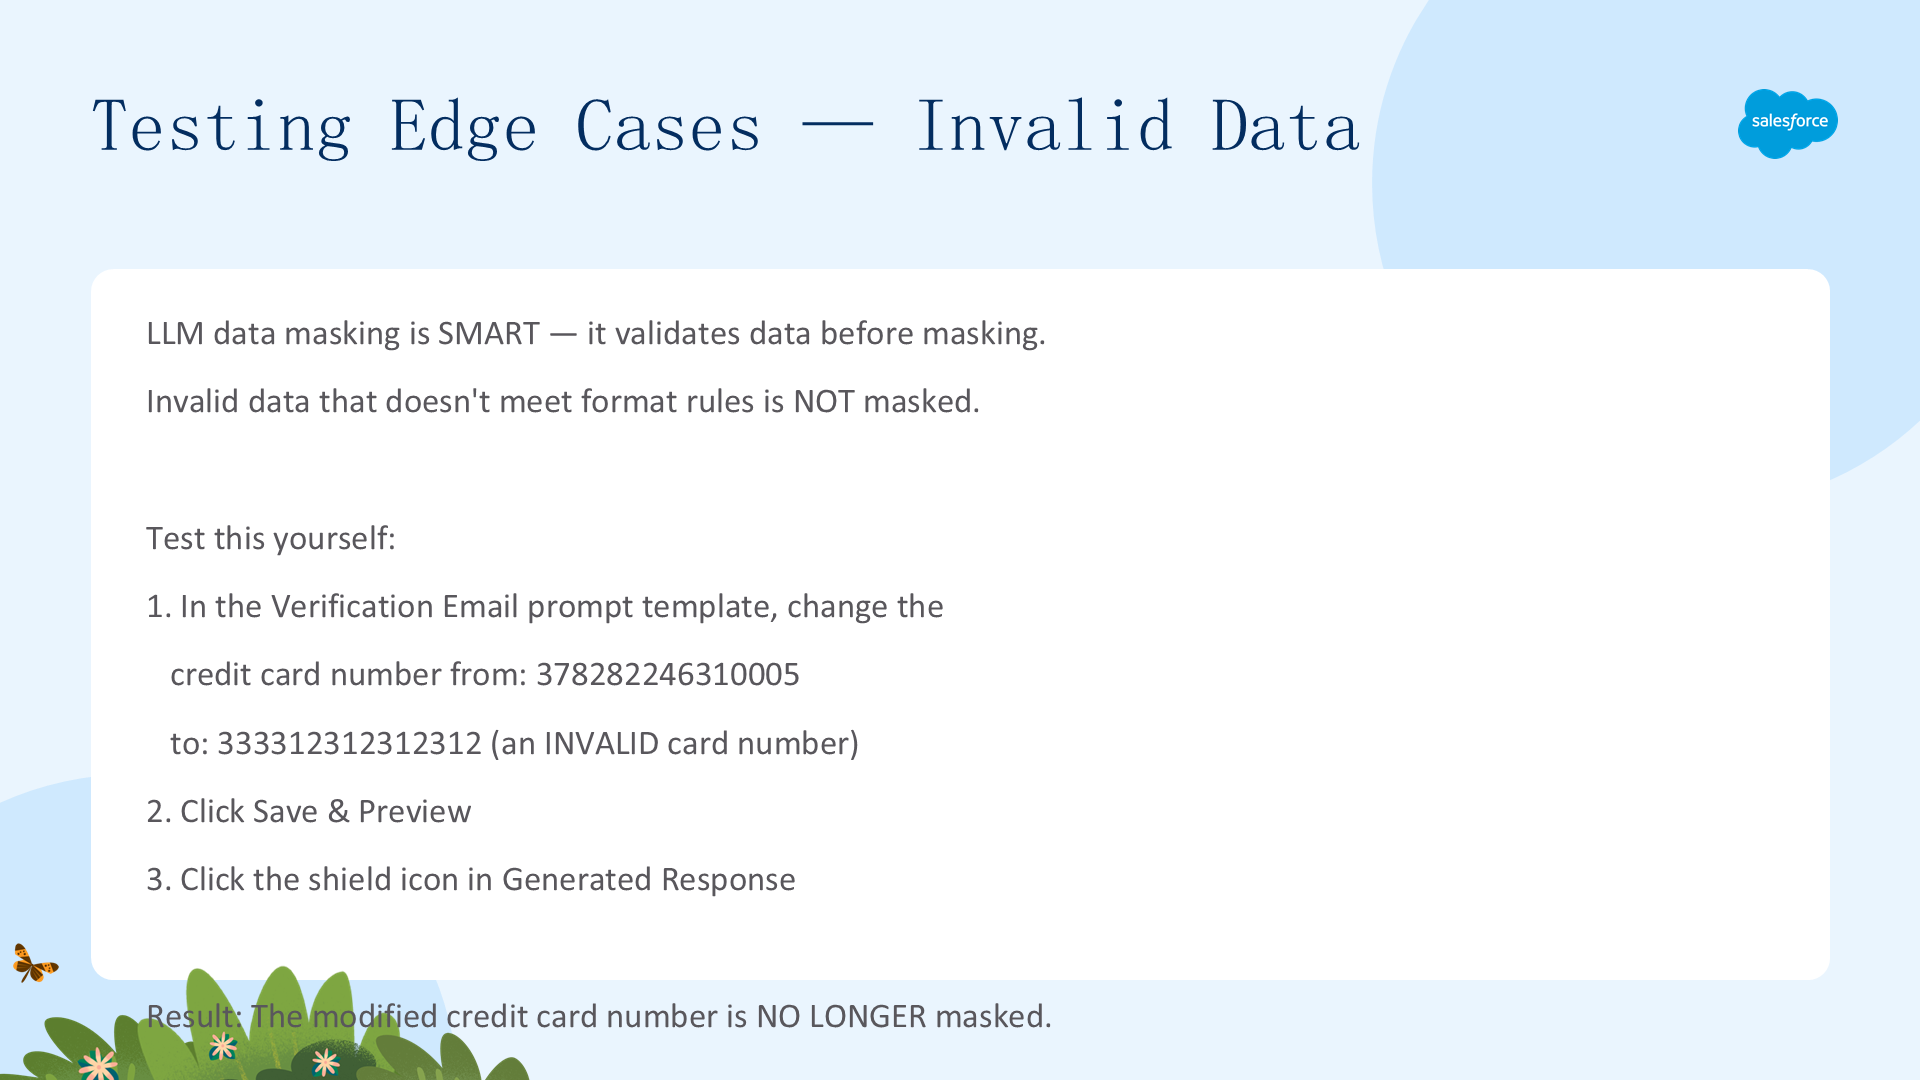
LLM 数据掩码是"聪明"的——它先校验数据再掩码,不符合格式规则的无效数据不会被掩码。自己测试:在 Verification Email 提示模板中,把信用卡号从 378282246310005 改为 333312312312312(一个无效卡号),点击 Save & Preview,在 Generated Response 标签点击盾牌图标——修改后的信用卡号不再被掩码。原因:信用卡号有特定的格式与校验规则(Luhn 算法),LLM 数据掩码先检查有效性,未通过校验的号码被视为非敏感数据而不掩码。这防止了误报——掩码那些看起来像敏感数据、但实际并非有效敏感数据的内容。
LLM 数据掩码——最佳实践与持续管理
实施 LLM 数据掩码后,遵循这些实践:定期测试(掩码策略应定期测试,而非只在初始设置时);评估对响应质量的影响(针对每个用例评估掩码特定数据类型是否影响 LLM 响应的有用性);周期性重新评估(LLM 会随时间变化改进,定期重新评估掩码配置,确保安全与质量的平衡仍然正确);监控审计线索(用 Data 360 仪表盘跟踪掩码活动、验证合规);保持更新(Einstein Trust Layer 会随时间新增数据类型与语言,及时审查新选项)。数据掩码不是"设置后就忘",它是生成式 AI 演进世界中的一项持续实践。
文章来源:Trailhead - Large Language Model Data Masking in the Agentforce Trust Layer