一、Data 360 打包与可扩展性
为您的用例扩展 Data 360
Salesforce Data 360 天生为可扩展性(extensibility)而设计——也就是说,它的构建方式允许您开发并共享其关键能力和功能。本徽章介绍如何用数据包(data kits)和托管包(managed packages)来开发、封装和部署 Data 360 功能。
可扩展性让您能够:
- 为特定行业定制数据模型;
- 为多个客户构建可复用配置;
- 为 AppExchange 创建打包解决方案;
- 跨 org 和数据空间标准化部署。
本模块覆盖从开发到分发的完整打包生命周期——毕竟「分享就是关爱」。
跟随 Get Cloudy Consulting
Get Cloudy Consulting 是一家 Salesforce 合作伙伴和独立软件供应商(ISV),他们有个想法——为鞋类供应商创建一套 Data 360 的自定义实现。完成后,团队希望把这个 Data 360 应用放到 Salesforce 的应用市场 AgentExchange 上销售。
在接下来的单元中,您将跟随 Get Cloudy Consulting 创建并打包 Data 360 应用的旅程。为简单起见,我们会略过一些步骤,重点放在创建数据包和包上。
这个真实场景展示了完整的 Data 360 打包工作流——「构建一次、到处部署」正是 ISV 和咨询合作伙伴的典型诉求。
术语与概念
开始之前,先了解与扩展 Data 360 相关的几个重要术语和概念:
- 元数据(Metadata) → Data 360 配置的「蓝图」;
- Salesforce 包(Package) → 可分发元数据的容器;
- 第二代托管打包(2GP) → 现代打包技术;
- 数据包(Data Kit) → Data 360 特有元数据的可移植捆绑包。
理解这些概念是在构建和分发 Data 360 解决方案之前必不可少的基础。
元数据(Metadata)
元数据是「描述数据的数据」。在 Data 360 中,元数据包括构成您 Data 360 环境的字段、配置、流程定义和代码。具体来说,Data 360 元数据包括:
- 数据模型对象(DMO)及其字段;
- 数据流与映射;
- 计算洞察;
- 身份解析规则集;
- 细分与激活。
元数据描述的是您的 org 包含什么、如何配置,与实际的客户数据相分离。包和数据包打包的就是元数据,用于在 org 之间迁移配置。
Salesforce 包(Package)
一个包是自定义对象和元数据的容器,可安装到一个或多个 org,并可与其他 Salesforce 用户共享。如果您想开发一个业务应用并销售给 Salesforce 客户,托管包就是 Salesforce 合作伙伴用来创建业务应用并通过 AgentExchange 分发的工具。
包的类型:
- 非托管包(Unmanaged):一次性部署,无法升级;
- 托管包(Managed):可升级、源代码隐藏、支持许可管理。
托管包支持版本管理和推送升级以实现自动化,非托管包则无法升级。托管包提供的整套能力可帮助您分发、许可、试用、排障并变现您的产品。
第二代托管打包(2GP)
Salesforce 有第一代托管打包(1GP)和第二代托管打包(2GP)。今后,我们建议所有新包都用 managed 2GP 创建。
2GP 相较 1GP 的优势:
- 基于源代码驱动的开发,配合 scratch org;
- 模块化的包设计;
- 与自动化 CI/CD 管线集成;
- 更细粒度的版本控制。
2GP 是新的 Data 360 打包项目的推荐方式,它使用 Salesforce CLI 和源代码控制,与现代开发工作流集成。
数据包(Data Kit)
数据包是在 Data 360 内创建的可移植、可自定义的可打包元数据捆绑包。数据包以模板形式组织 Data 360 元数据,可直接从 UI 完成,无需编写任何代码。
数据包包含:数据流与映射、数据模型对象(DMO)、计算洞察、细分,以及其他 Data 360 特有元数据。
流程是:Data 360 功能和元数据必须先加入数据包;创建数据包后,再把它加入包(package)。当用户想在他们的 org 中使用数据包时,必须先安装包,然后在 org 中部署数据包组件——部署会激活并启用数据包中的组件,确保数据流、数据模型等元素在 org 中正常运行并集成。
开发生命周期
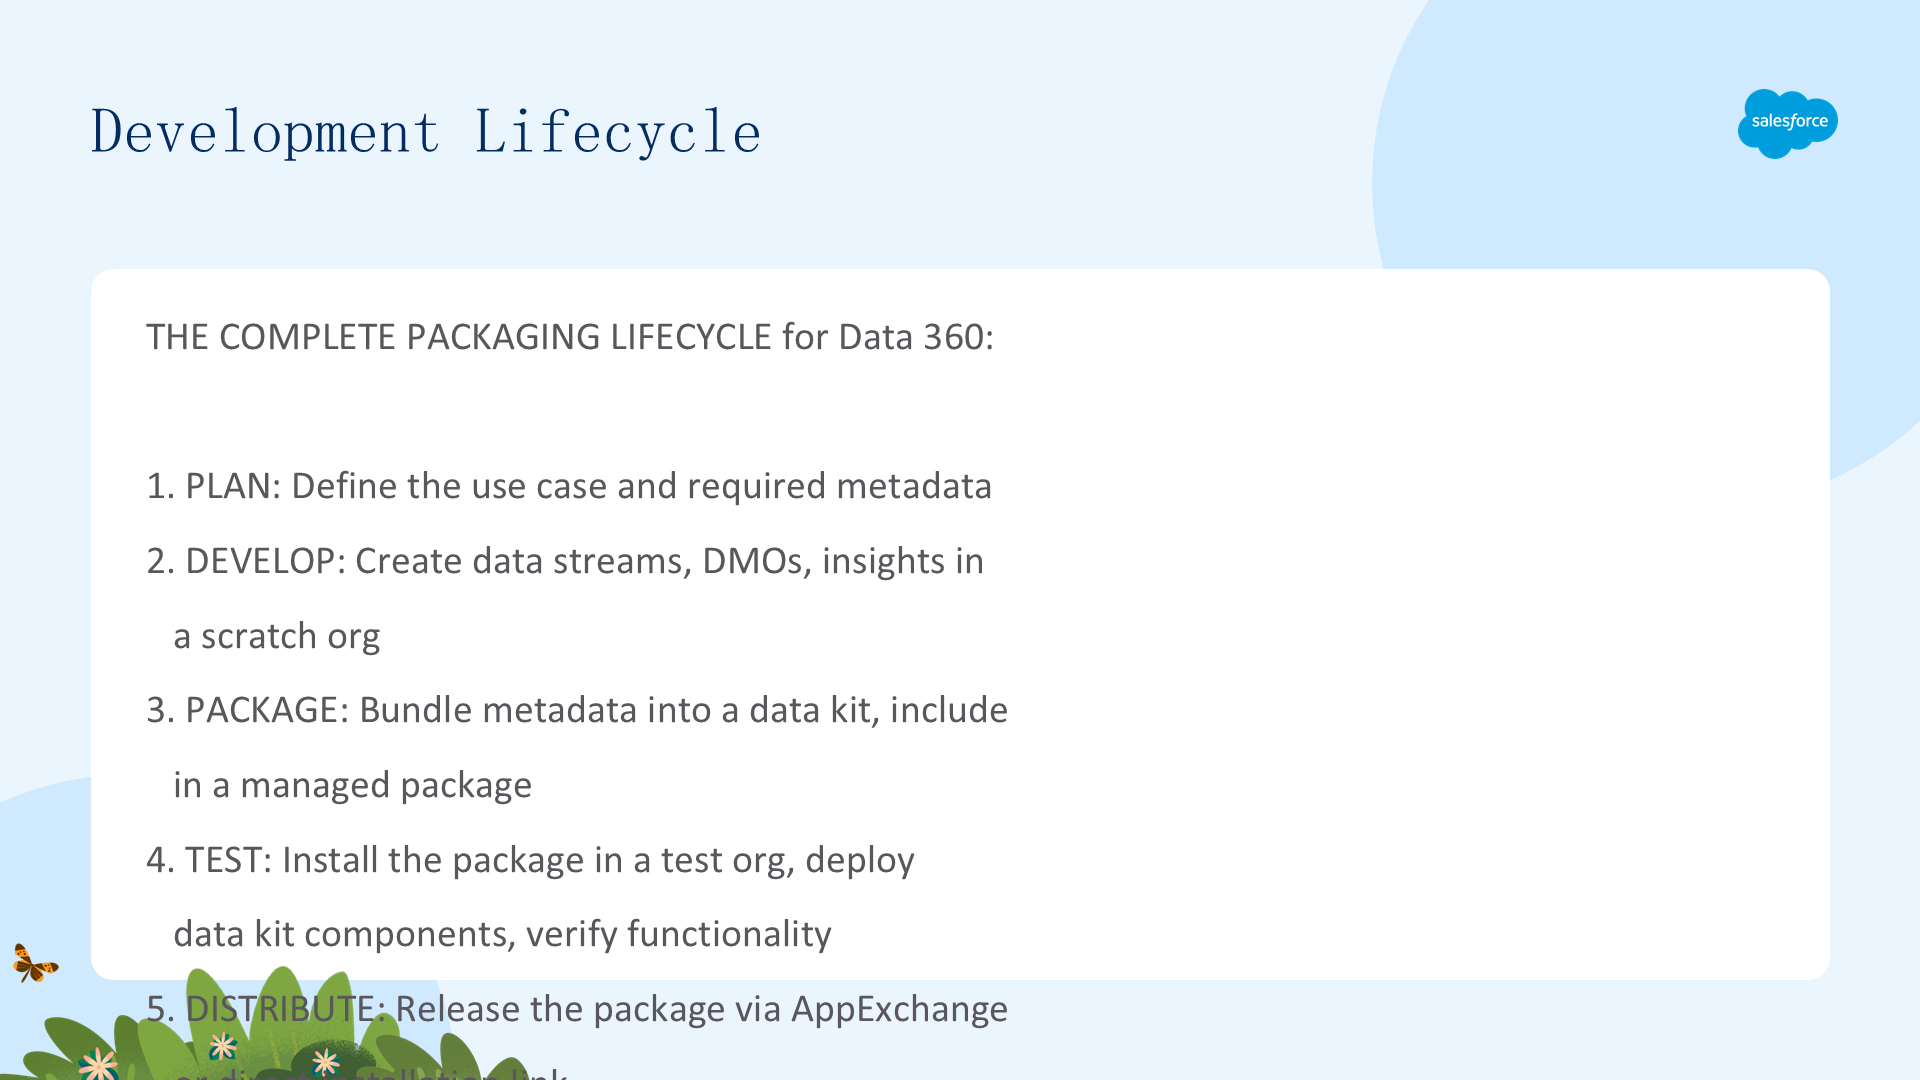
Get Cloudy Consulting 团队列出了创建这个应用要做的所有事情,即应用开发生命周期:
- 规划并收集需求——与相关干系人沟通,定义应用要做什么、时间表、成功标准;
- 创建包——通过 UI 或 CLI 在 scratch org 中构建 Data 360 组件,把功能加入数据包,再打包;
- 测试包——在另一个 org 安装包并部署组件,验证功能;
- 迭代修改修复问题——修复发现的问题再测试;充分测试后,同一(或更新后的)打包数据包可安装到生产 org;
- 执行用户验收测试(UAT)——做用户测试、收集初步反馈并打磨;
- 通过 AgentExchange 分发应用——客户可以试用演示、查看评论、购买应用。
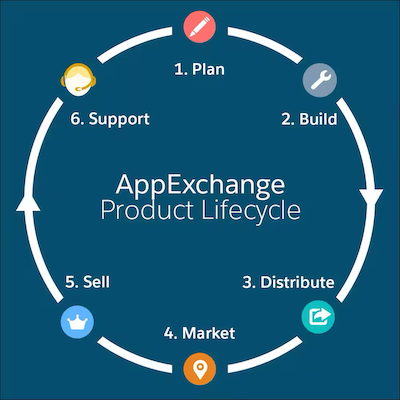
六个阶段完整对应了从规划到分发的打包全流程,是接下来三个单元的结构。
二、打包 Data 360 功能
为 Data 360 设置托管打包
在构建包之前,需要先把基础设施就位。本单元讲解托管打包的前提条件:
- 为 scratch org 启用 Data 360;
- 创建 Dev Hub 和命名空间 org;
- 设置开发环境;
- 创建项目和 scratch org。
请按顺序完成——每一步都建立在前一步之上。
为 Scratch Org 启用 Data 360
Scratch org 是源代码驱动、可丢弃的 Salesforce 代码和元数据部署环境。
Get Cloudy 团队的第一步是在其 Partner Business Org 中为 scratch org 启用 Data 360,这样他们就能在 scratch org 中使用 Data 360 元数据或打包数据包。如果您的 org 未启用「Data Cloud for Scratch Orgs」,请向 Salesforce Partner Support 提交案例,请求在 Partner Business Org 上启用它(该功能仅适用于与 Dev Hub 关联的 scratch org)。
在 scratch org 定义文件中启用 Data 360,可确保开发环境与目标生产环境一致。
创建 Dev Hub 和命名空间 Org
Get Cloudy 需要一个 Dev Hub 和一个命名空间 org(namespace org):
- Dev Hub org:管理开发与测试中使用的 scratch org 的中央 org;
- 命名空间 org:一个 Developer Edition org,用于指定您包的命名空间。
步骤:
- 在 Partner Business Org 中启用 Dev Hub 和第二代托管打包;
- 创建命名空间 org,并在其中指定命名空间;
- 在 Dev Hub org 中注册该命名空间。
命名空间一经注册就永久不变——请谨慎选择,它会作为前缀出现在所有已打包组件的 API 名称上。
设置开发环境
Get Cloudy 确认已具备必要的开发工具:
- Salesforce CLI——用于 org 管理和包操作的命令行界面;
- Visual Studio Code + Salesforce Extension Pack——元数据开发的 IDE;
- Git——包源代码的版本控制。
用 Dev Hub org 对 CLI 做鉴权,这就在本地开发环境与打包基础设施之间建立了连接。
创建项目
Get Cloudy 在本地目录创建一个 Salesforce DX 项目:
- 在 VS Code 中打开项目,修改
sfdx-project.json、config/project-scratch-def.json和.forceignore文件,设置正确的命名空间、登录 URL、orgName 及ssot行; - 在
proj-scratch-def.json文件中指定CustomerDataPlatform功能。
项目结构包括:force-app/(元数据源目录)、config/(scratch org 定义文件)、sfdx-project.json(包配置)。它是您的本地开发工作区,所有元数据、数据包定义和包配置都在版本控制下存放于此。
创建 Scratch Org
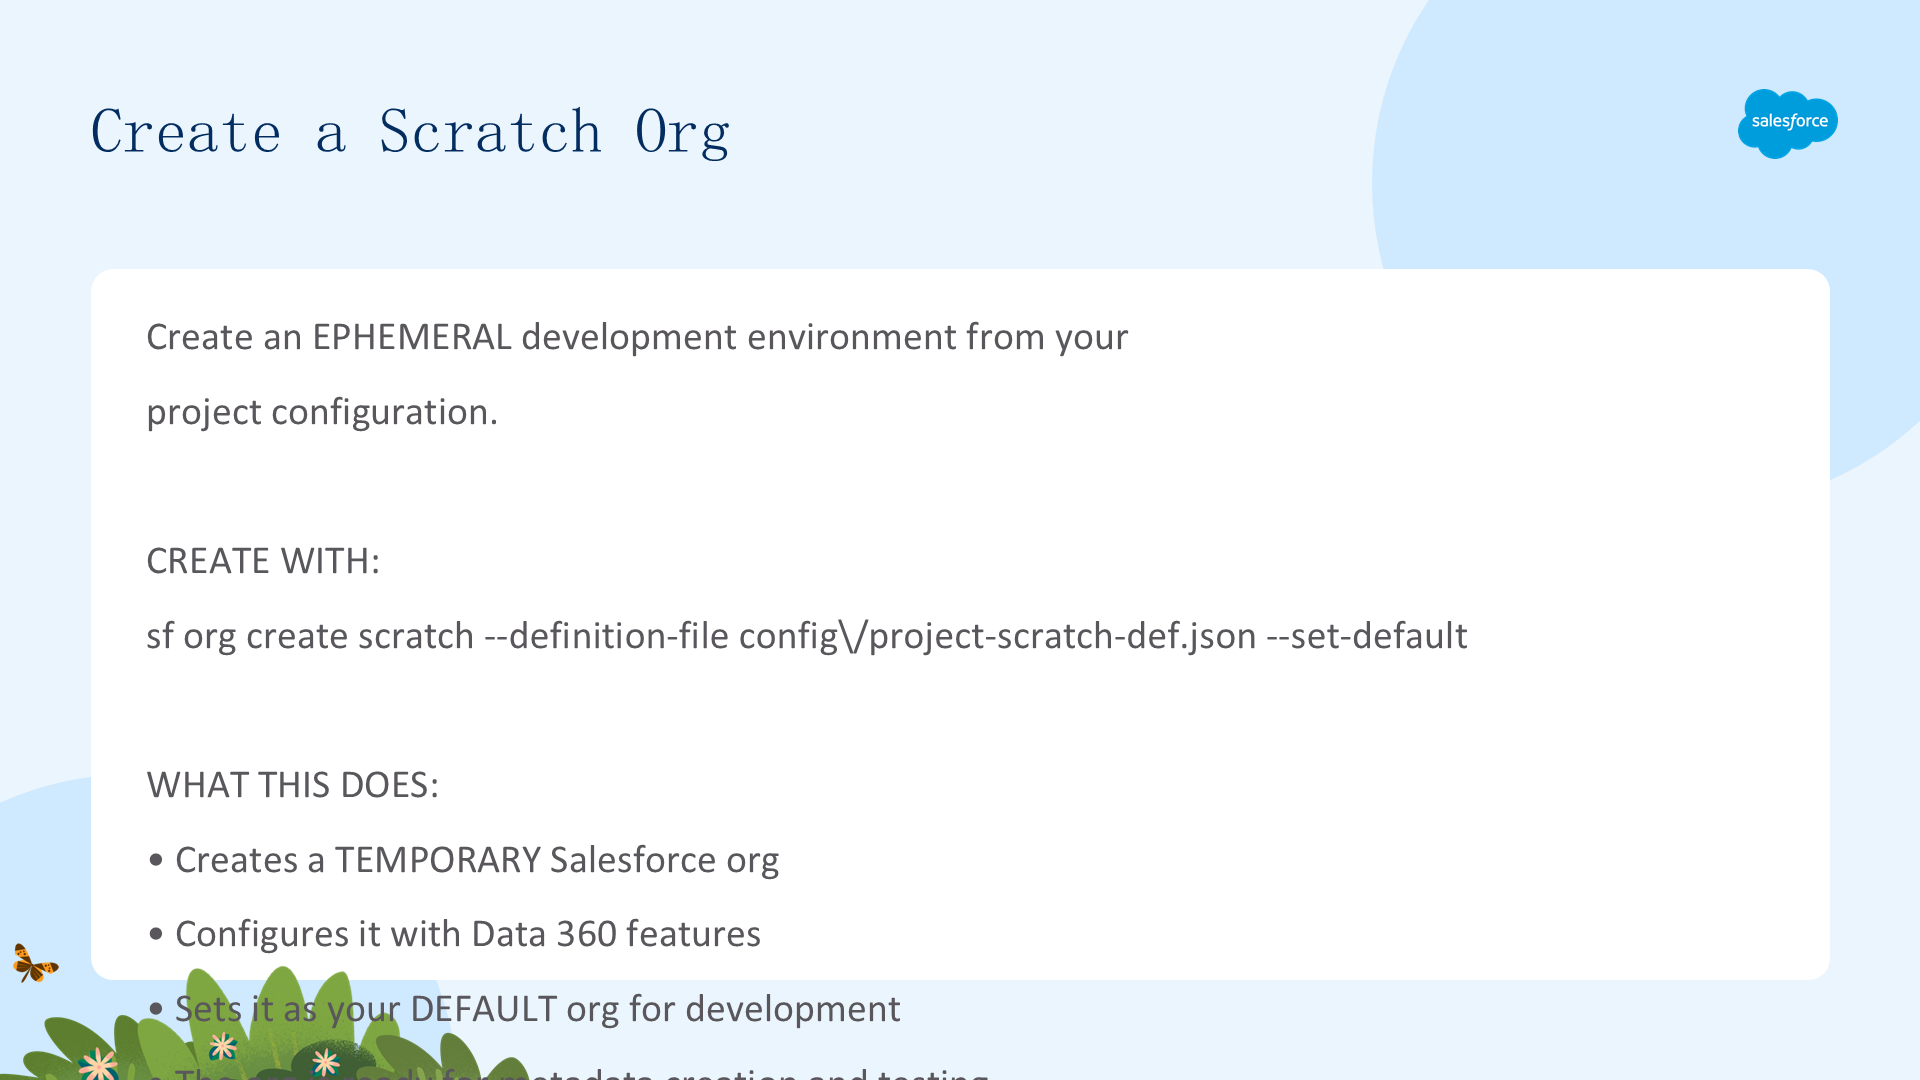
创建 scratch org 时,Get Cloudy 在命令行中输入以下命令,并指定 scratch org 定义文件:
sf org create scratch --definition-file config/project-scratch-def.json --set-default这会创建一个临时的 Salesforce org,配置了 Data 360 功能,并设为开发的默认 org。Scratch org 是可丢弃的——创建、用于某个任务、用完即删,为每次开发会话提供干净一致的环境。
三、创建并打包数据包
为什么使用数据包?
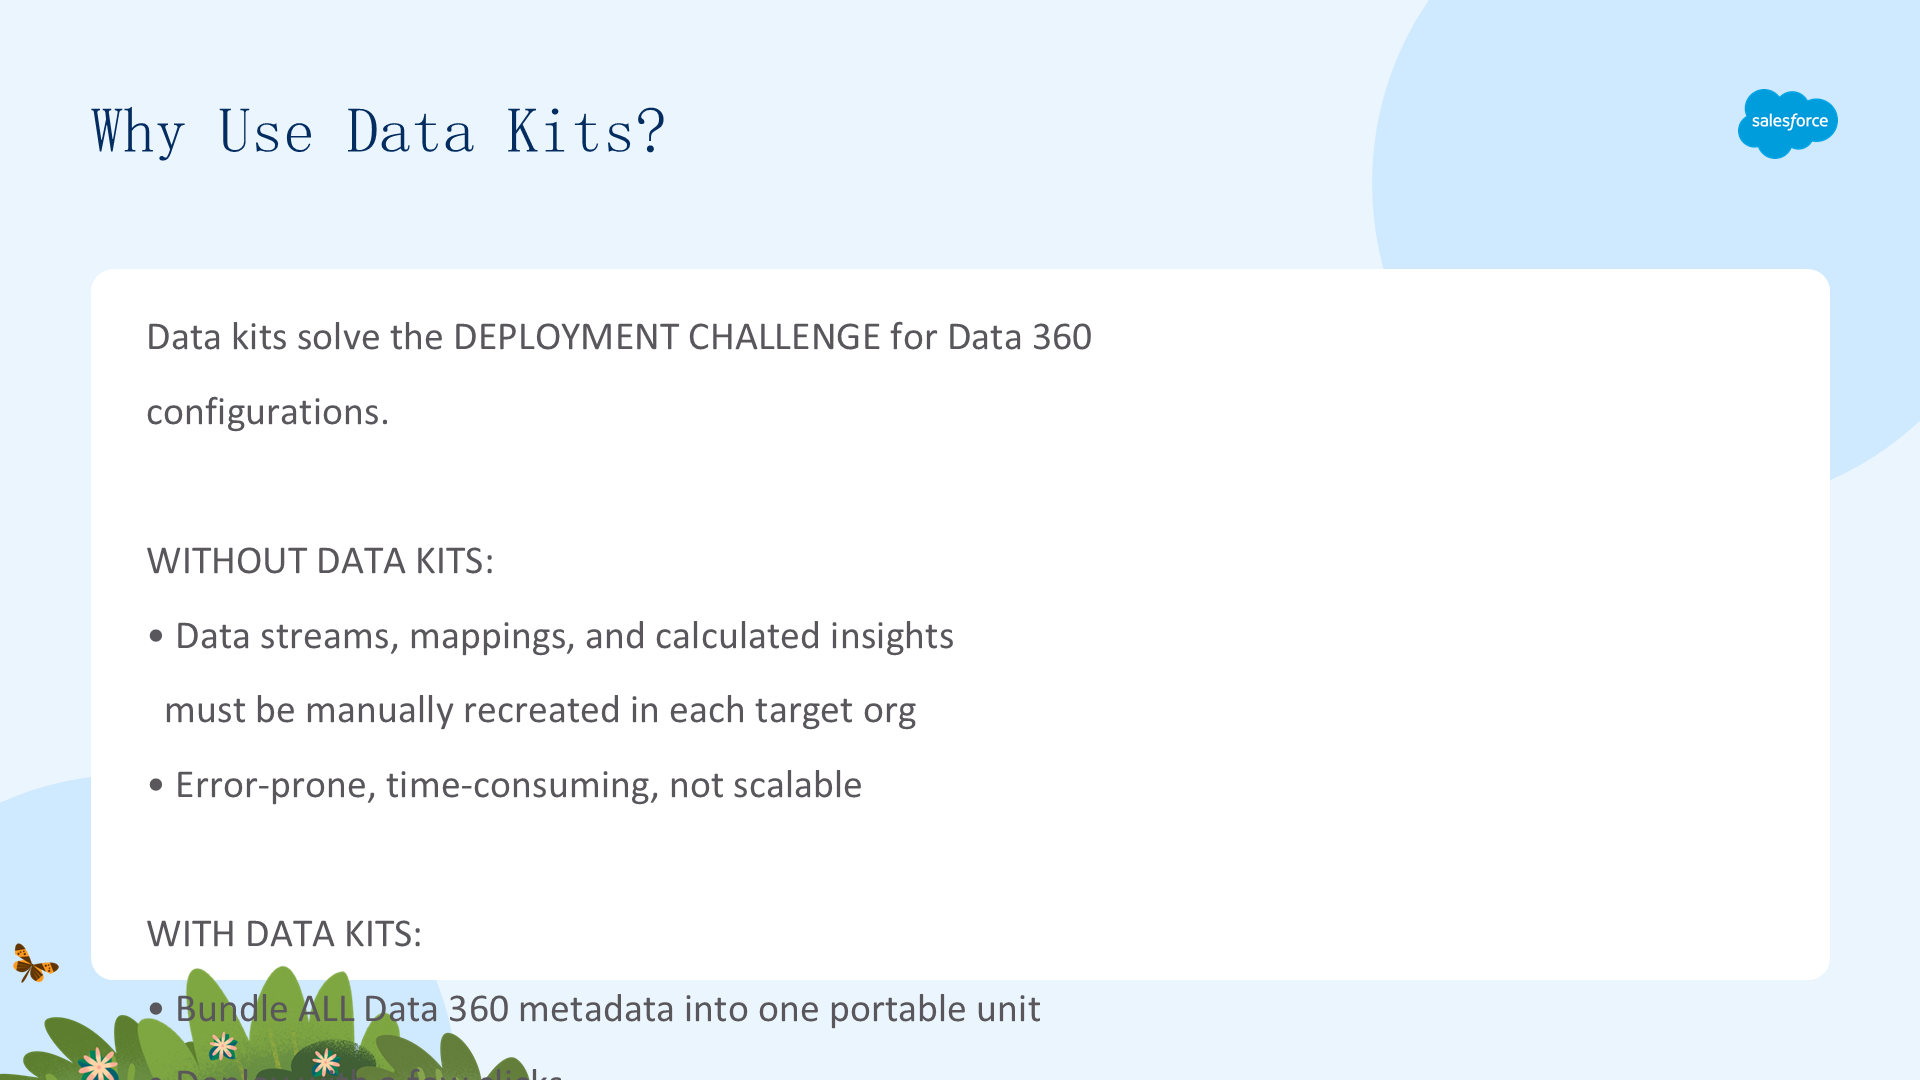
数据包解决了 Data 360 配置的部署难题。
没有数据包时:数据流、映射和计算洞察必须在每个目标 org 中手动重建——容易出错、耗时、不可扩展。
有了数据包,您可以:
- 通过模板复用 schema——把配置放入数据包,协作者可轻松在自己的 org 部署复用;
- 部署到同一 org 的多个数据空间——安装后选择部署到哪个数据空间;
- 增强灵活性——包升级更新的是模板,允许包用户保留未立即需要改动的元素。
需要注意:从数据包部署的元数据无法编辑或删除。要确认哪些组件可以放入数据包,请查阅 Data 360 Extensibility Readiness Matrix。
创建数据包
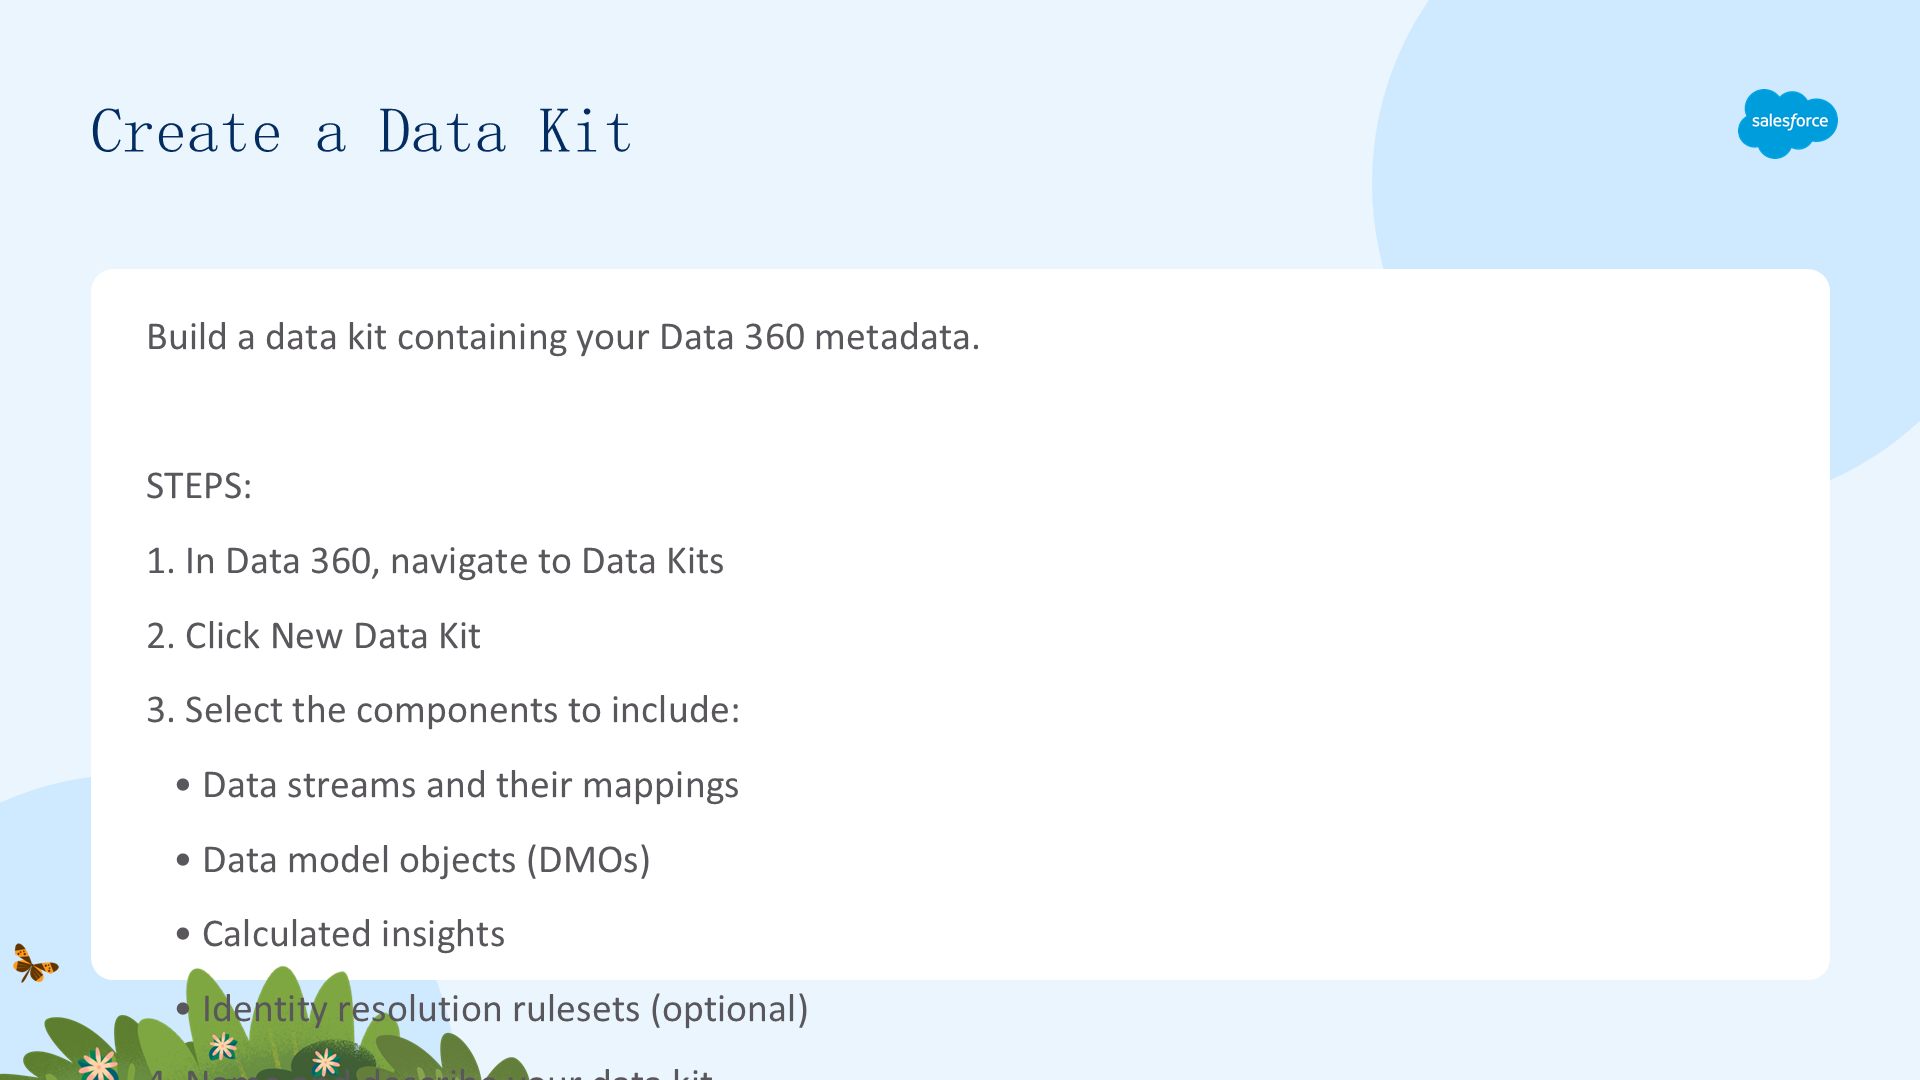
Get Cloudy 已设置好 Dev Hub org、命名空间 org 和 scratch org,现在是创建数据包的时候。在 scratch org 中,团队创建 Data 360 元素并加入数据包:
- 进入 scratch org 的 Data Cloud Setup;
- 在 Quick Find 框搜索并点击 Data Kits;
- 点击 New;
- 命名数据包(可加描述),点击 Save;
- 在 Data Stream Bundles 部分点击 Add;
- 根据支持的数据源选择连接器类型;

- 添加 bundle 名称(不含空格)和可选描述;
- 选择要打包的数据流,点击 Next;
- 如需要,添加数据模型,点击 Save;
- 如需要,添加计算洞察,点击 Save;
- 按需添加其他组件。
接着,团队需要查看组件部署的顺序,即发布顺序(Publishing Sequence):进入该标签页,查看自动生成的发布顺序(基于各组件在数据包中的创建时间)。数据包组件之间保留关系——源 org 中数据流与 DMO 的映射在部署时依然保留。
用数据包创建托管包
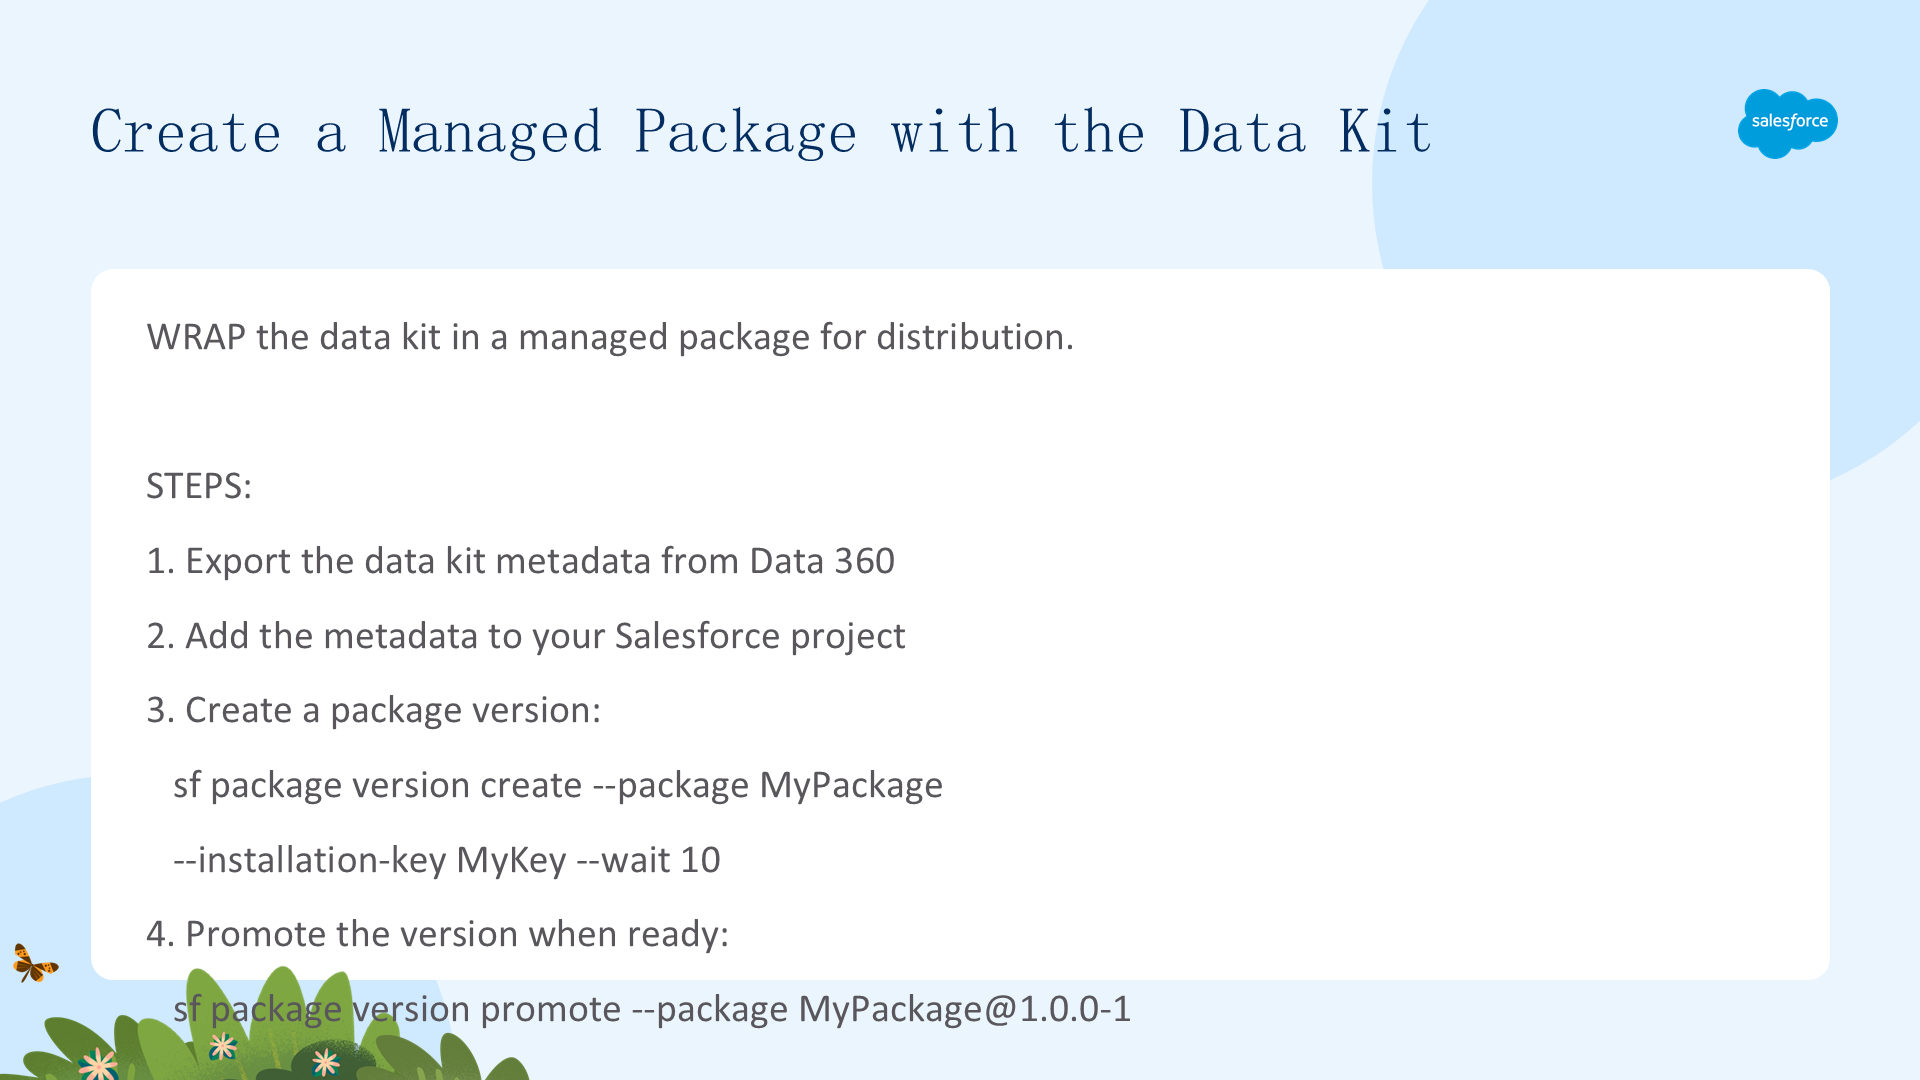
数据包创建成功后,就该打包了。在 Salesforce DX 项目中,Get Cloudy 团队通过引用从 UI 下载的 package.xml 文件来检索数据包元数据。数据包元数据应放在一个独立于权限集、自定义对象和 Apex 等项目文件夹的位置。
接着确定是否需要依赖 Data 360 SSOT 包——SSOT 包含驱动 Data 360 的核心数据模型对象。如果包中的 DMO 与 Unified Individual 或其他 API 名称带 ssot__ 前缀的 DMO 有关系,项目就存在依赖,需在 sfdx-project.json 中添加相应配置。
然后创建一个指向数据包元数据文件夹的 Salesforce 托管包。创建后会产生一个 0ho ID,复制它并据此创建托管包版本;该过程可能需要几分钟,返回表示包版本的 04t ID。初始版本是 beta 版,只能安装到 scratch org;验证后运行 sf package version promote 创建可安装到 Developer Edition 和生产 org 的版本。
协作
Get Cloudy 团队创建并打包了数据包,然后把改动提交到版本控制系统并推送到 GitHub 以与其他开发者协作。
协作模式:
- 多个开发者通过源代码控制(Git)在同一个项目上工作;
- 每个开发者创建自己的 scratch org做隔离开发;
- 改动通过 pull request 合并;
- CI/CD 管线在每次提交时自动化测试。
版本控制中的数据包定义支持变更追踪、回滚和代码评审——这与标准 Salesforce 开发使用相同的协作模型,意味着 Data 360 配置可以像 Apex 代码一样严谨地开发。
四、安装并测试 Data 360 包
测试您的包
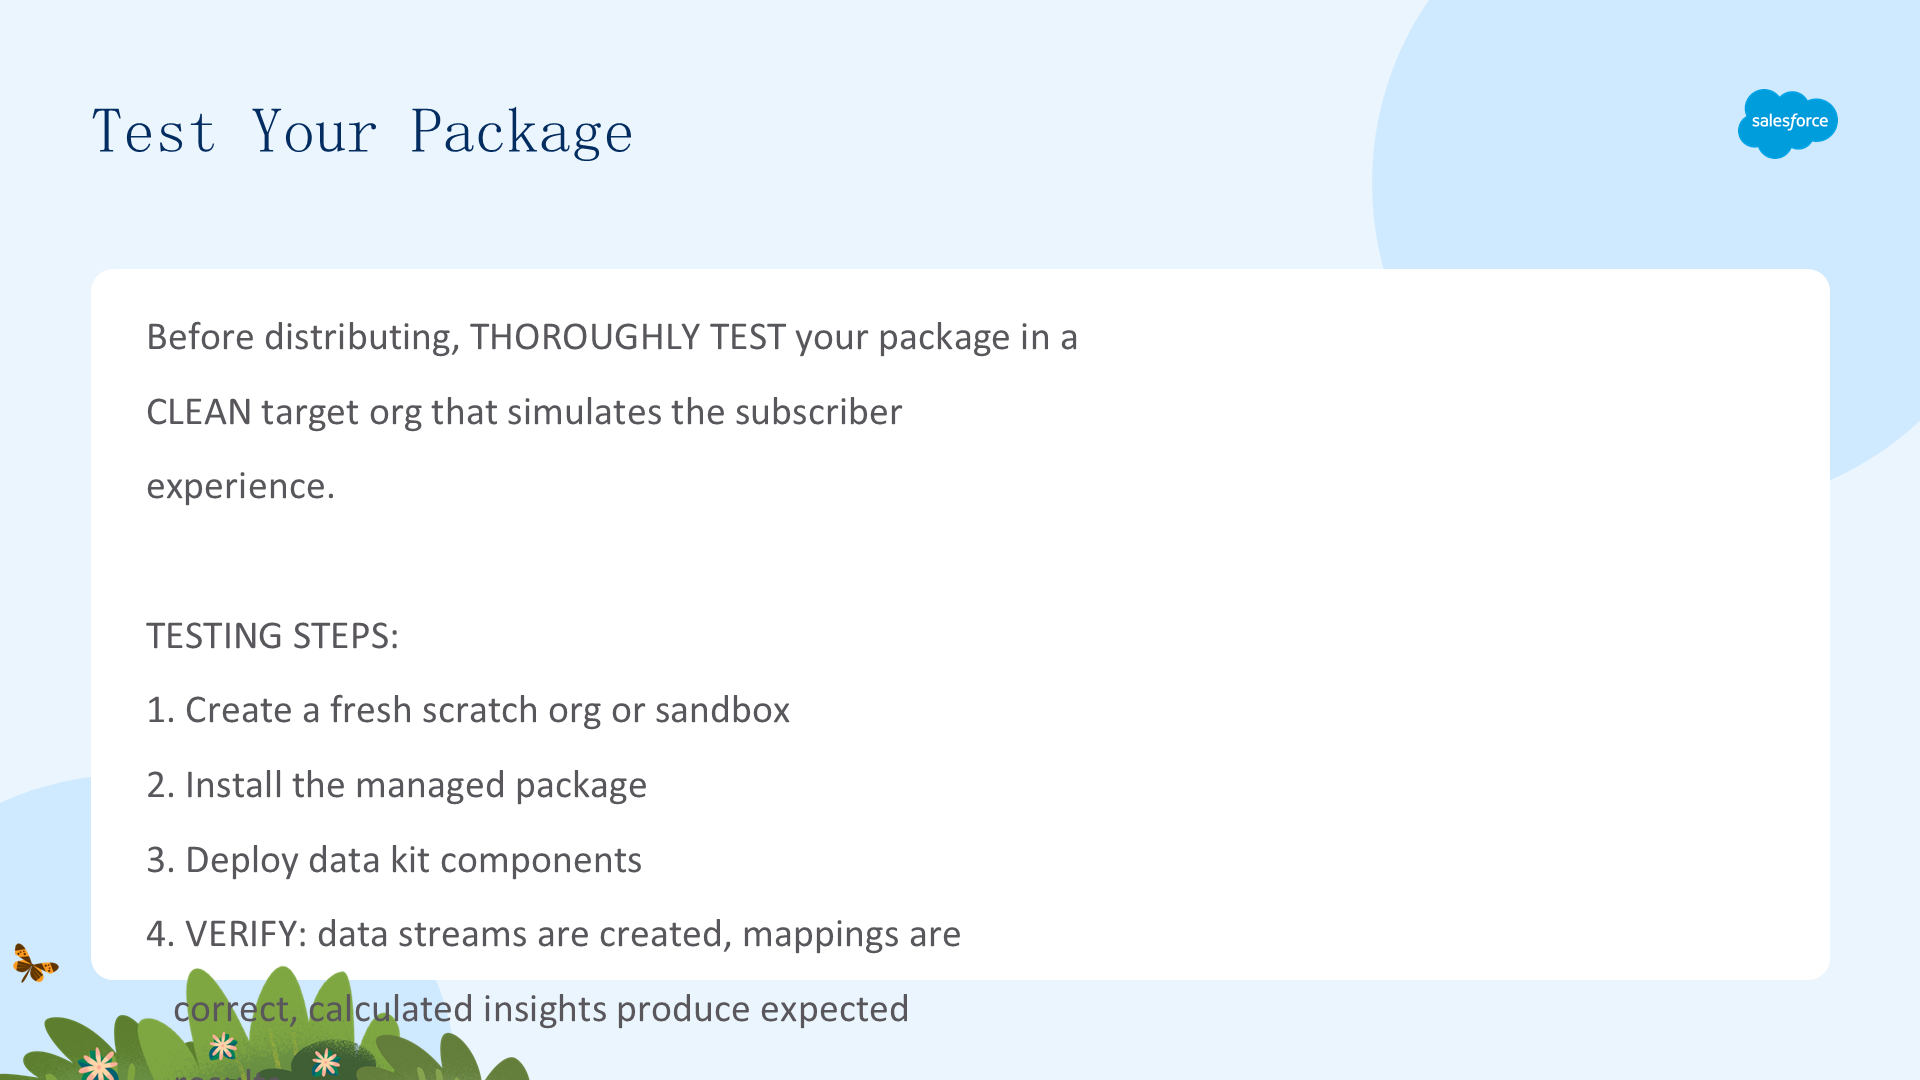
分发之前,务必在一个干净的目标 org中彻底测试包,以模拟订阅者体验。测试步骤:
- 创建一个全新的 scratch org 或 sandbox;
- 安装托管包;
- 部署数据包组件;
- 验证:数据流已创建、映射正确、计算洞察产出预期结果;
- 测试任何自定义逻辑或自动化。
在干净 org 中测试能发现那些在开发环境中不会出现的问题——因为开发环境里可能已经存在一些前置配置。
安装包含数据包的包
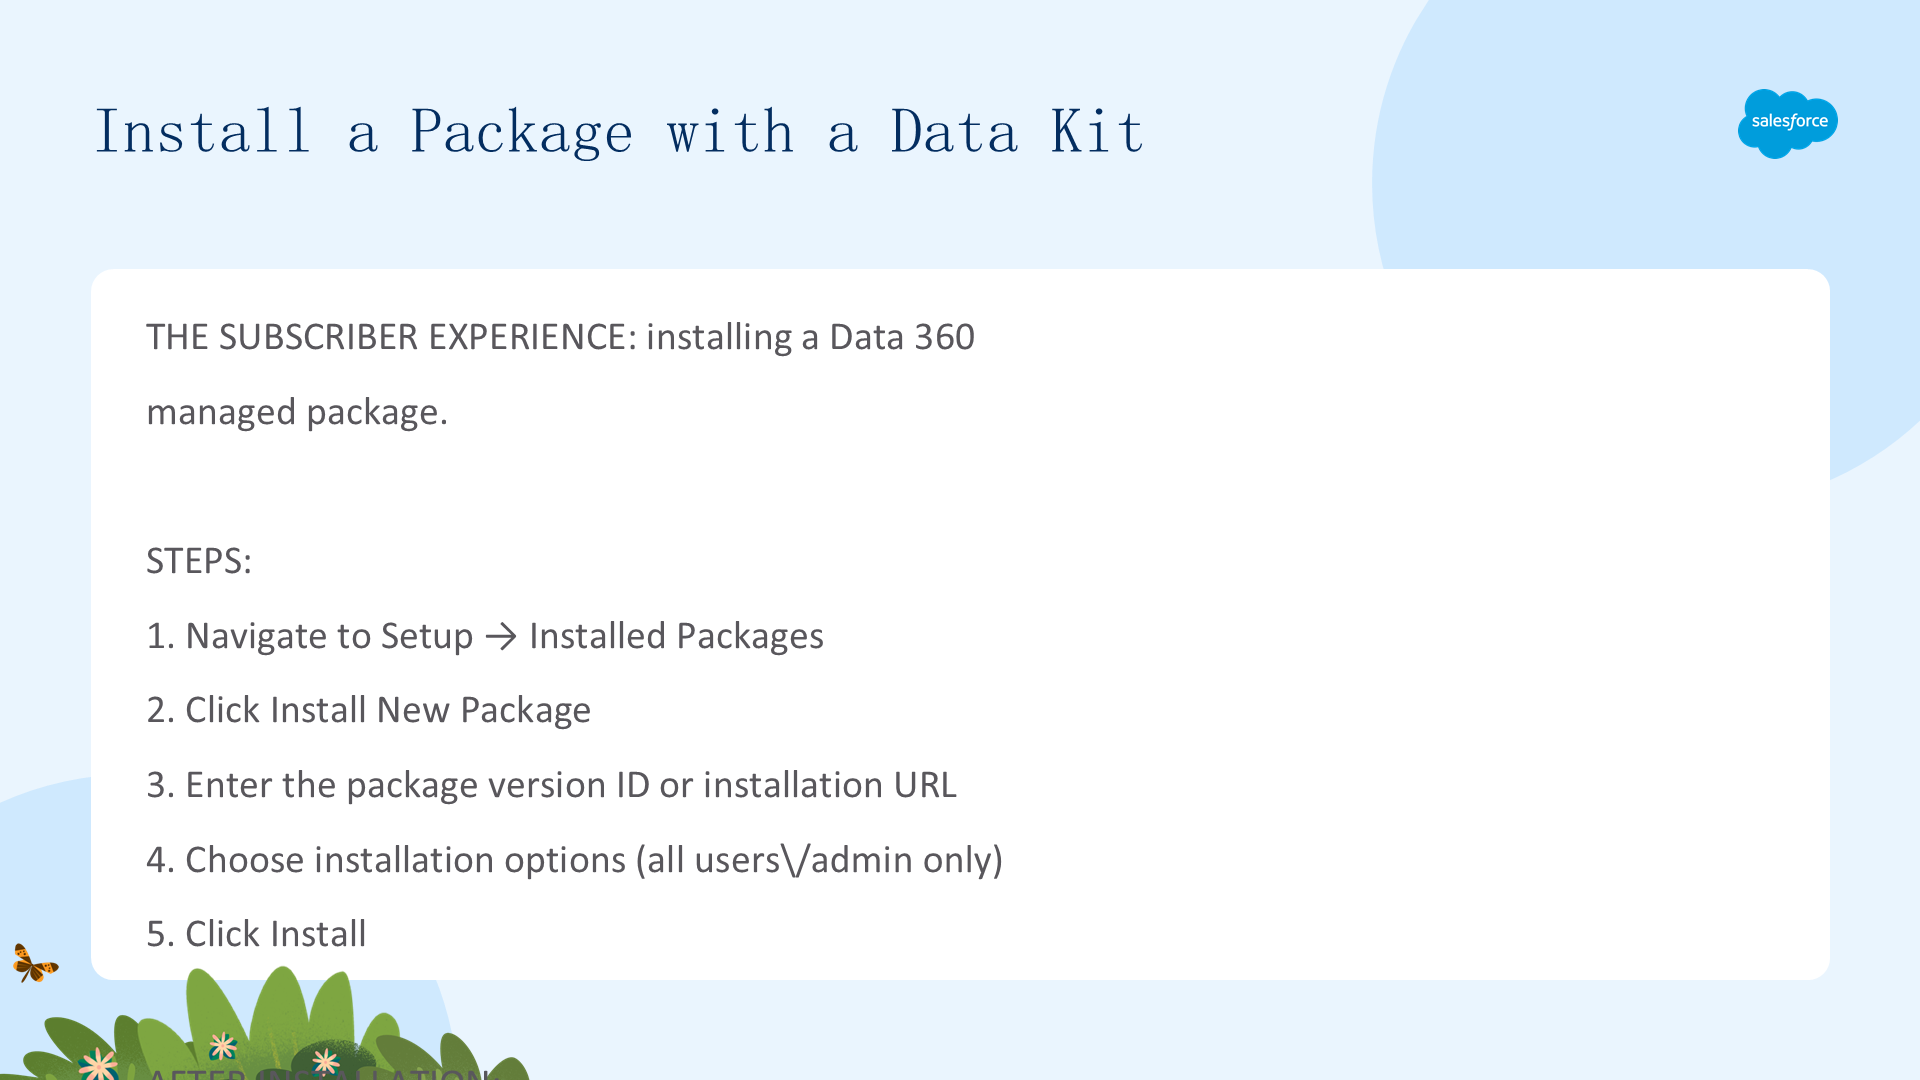
测试之前,Get Cloudy 需要把带数据包的 Data 360 包安装到测试 scratch org。多数 Data 360 任务要求用户拥有 Data Cloud Architect 权限集。
- 在要安装的 Data 360 org 的单独标签页/窗口输入提供的 URL;
- 选择 Install for Admins Only,点击 Install;
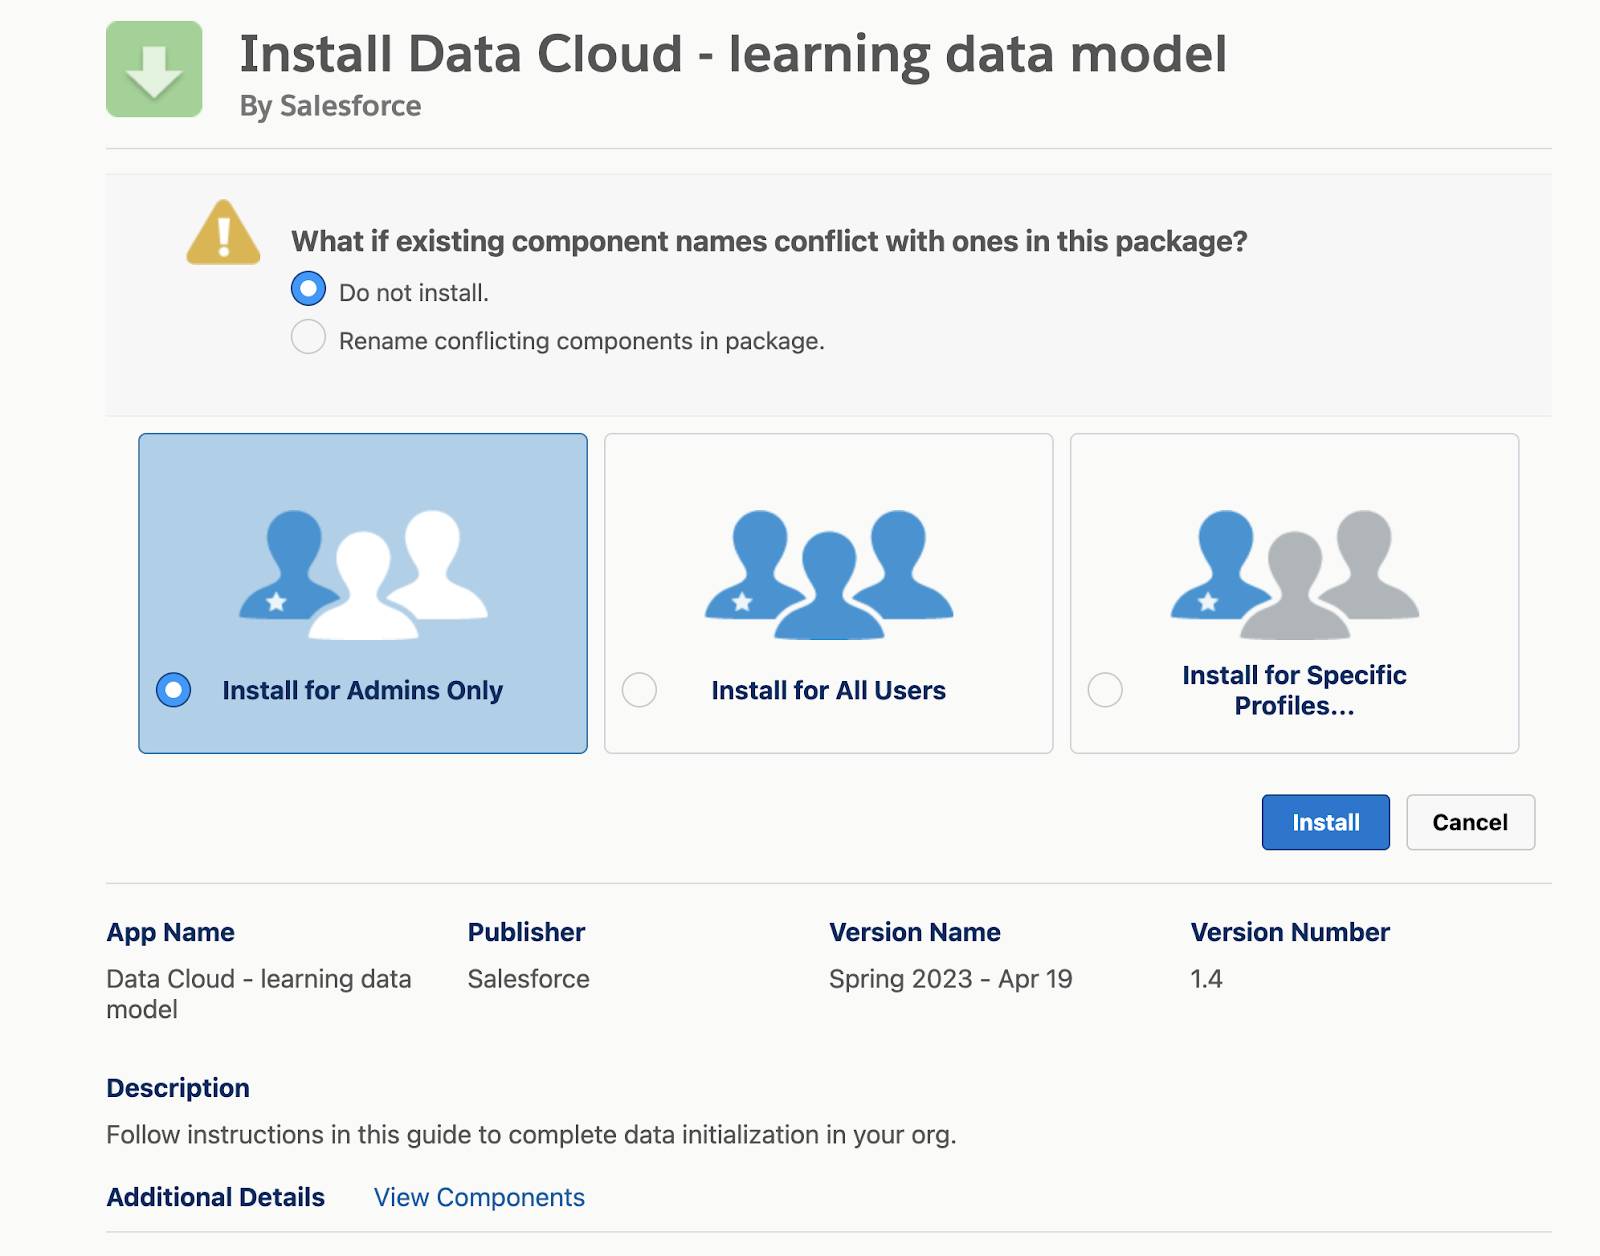
- 安装完成后点击 Done。
安装提供的是元数据;部署才是激活它。安装后,托管包出现在 Installed Packages,数据包出现在 Data 360 的 Data Kits 标签页,但组件尚未部署。
部署数据包的组件
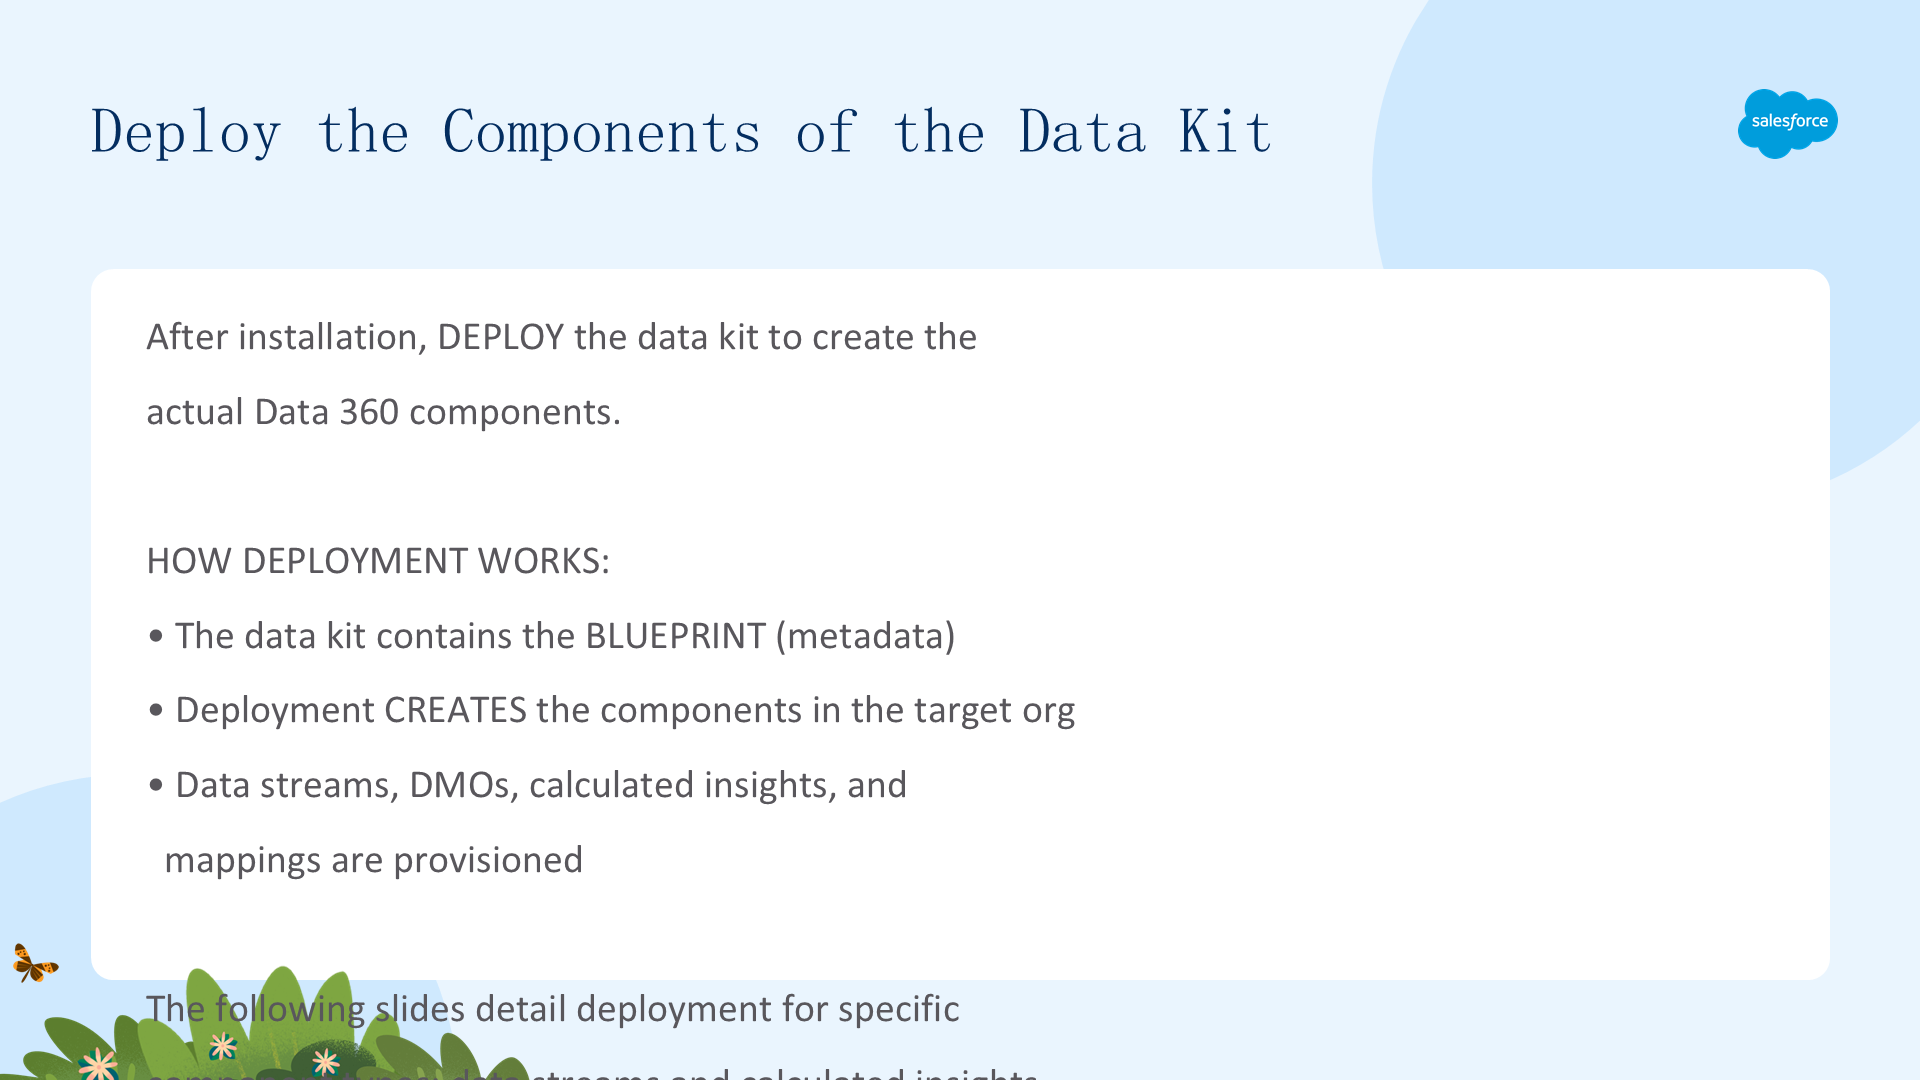
安装包和数据包后,就可以把数据包中的功能部署到 org 中。部署方式有多种,本模块使用 UI;也可通过 Deploy Data Kit Components flow 以编程方式安装。
部署的工作原理:数据包包含蓝图(元数据),部署在目标 org 中创建这些组件——数据流、DMO、计算洞察和映射被实际供应出来。
部署可以分阶段进行:先部署数据流、验证摄取,再部署依赖这些数据的计算洞察,从而降低排障复杂度。
从数据包部署数据流
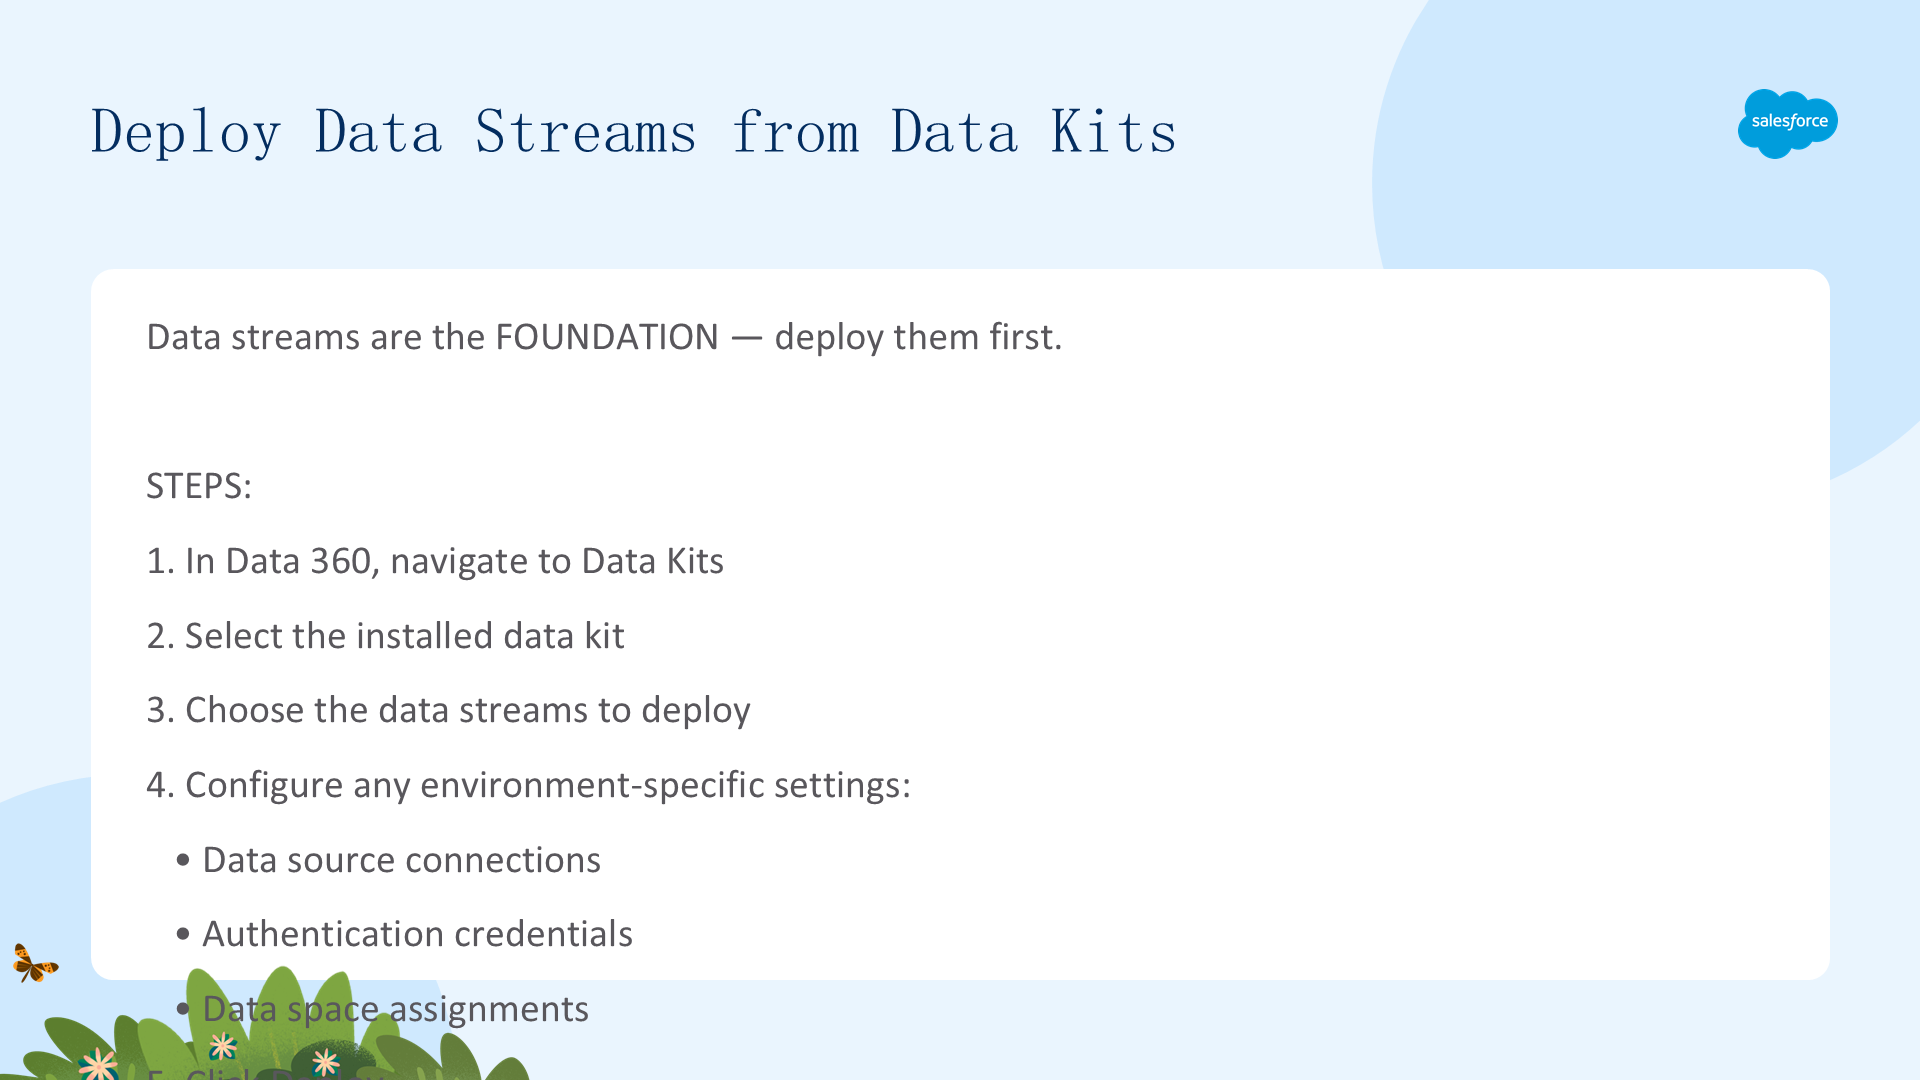
数据流是基础,应先部署。登录到安装了数据包的 org,执行以下步骤:
- 进入 Data Cloud 的 Data Stream 标签页;
- 点击 New 创建数据流;
- 若是 CRM 流,选择 CRM 流并点击 Next;否则选择 Installed Data Kits & Packages 并点击 Next;
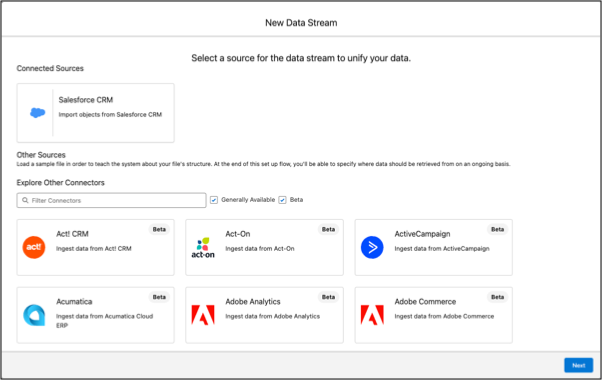
- 若是 Salesforce CRM,选择适当的 Salesforce org;否则在 Installed Data Kits and Packages 下选择包;
- 在 Custom Data Bundles 下找到您的数据包;
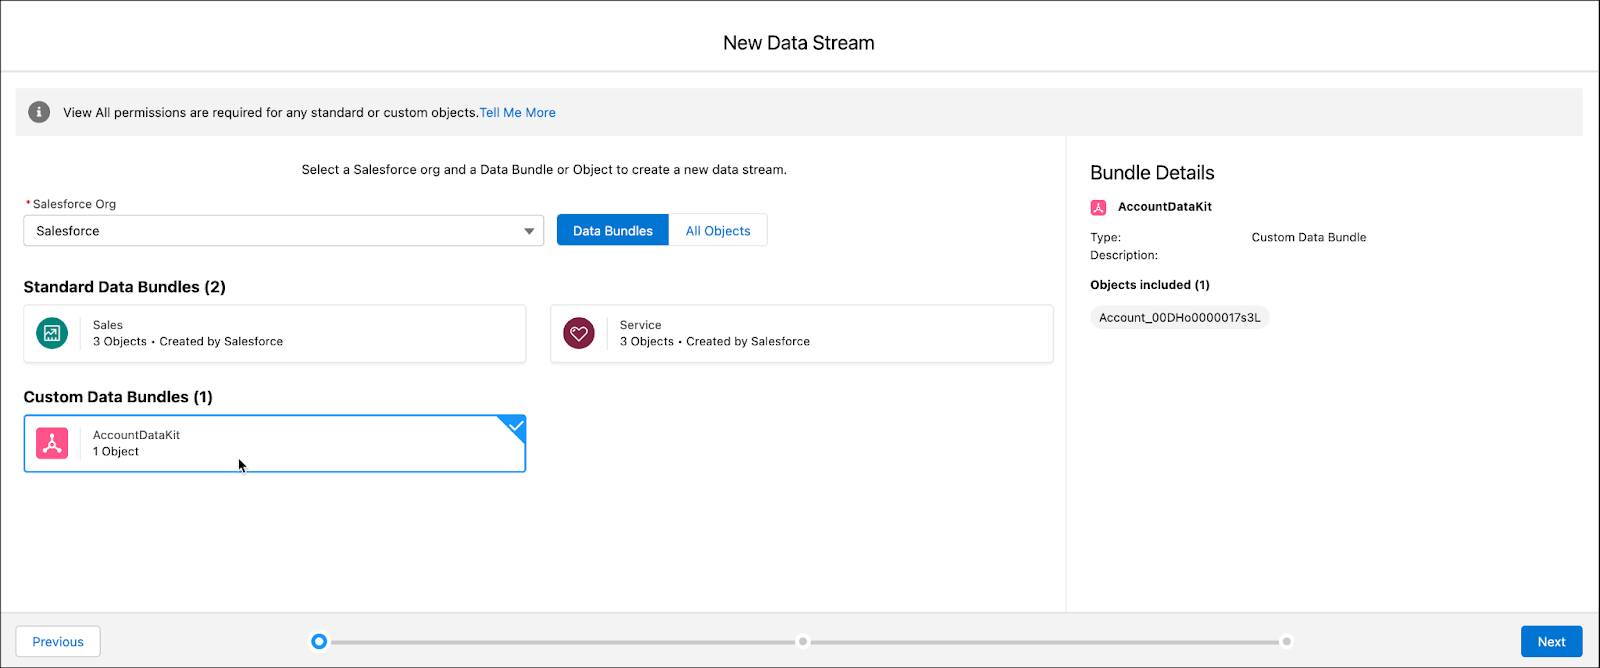
- 点击 Next;
- 选择数据空间、查看字段,点击 Next;
- 查看详情并点击 Deploy。
新的数据流会以与开发环境相同的模型和映射创建。环境相关的设置(凭据、端点)在部署时配置,而非写入数据包,从而保证数据包跨 org 可移植。
从数据包部署计算洞察
如果数据包包含计算洞察,可从数据包部署:
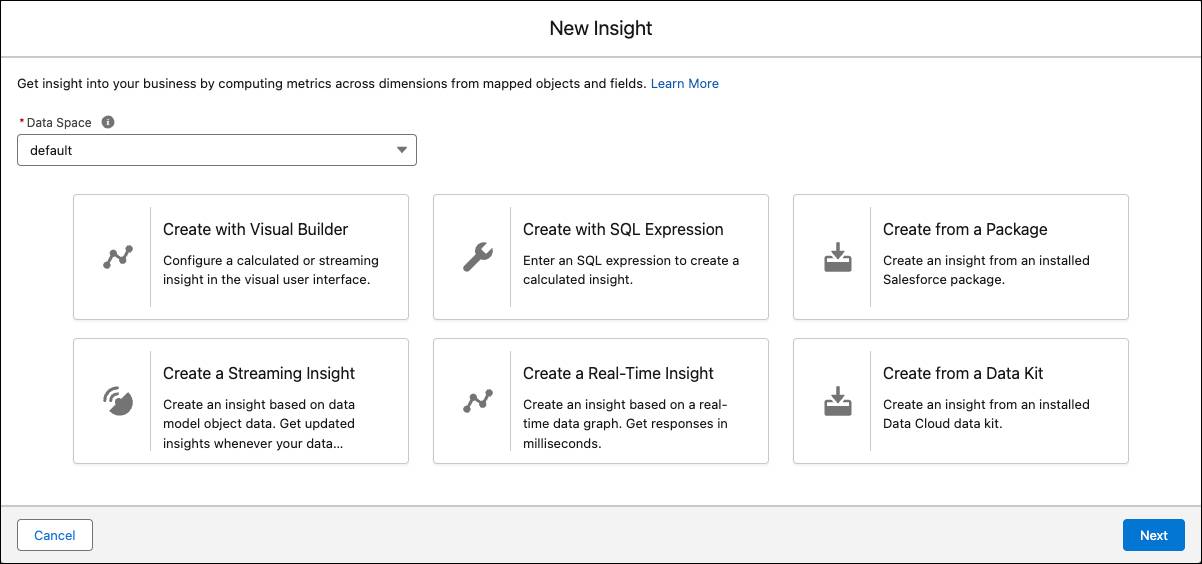
- 进入 Calculated Insights 标签页,点击 New;
- 选择 Create from a Data Kit,点击 Next;
- 选择包和数据包,点击 Next;
- 点击 Deploy。
计算洞察依赖数据流已激活——先部署数据流、等待 Success 状态,再部署洞察。数据包保留了这些依赖关系,但不会强制部署顺序,这需要由部署者负责。
更新数据包
随着解决方案演进,需要更新数据包并发布新的包版本。更新工作流:
- 在开发 scratch org 中做出改动;
- 用新增/修改的组件更新数据包;
- 用更新后的数据包创建新的包版本;
- 把升级推送给订阅者。
订阅者体验:在 Setup 中收到包升级通知;升级后更新后的数据包可用;按需部署新增/修改的组件;现有组件不会被自动覆盖——订阅者掌控部署时机。这在保留订阅者自定义的同时交付新功能。
注意:此更新功能仅适用于 CRM 数据流。更新数据包时,在 Data Cloud Setup → Data Kits 中打开数据包,点击 Update,选择更新后的数据流,再选相关对象和关系并保存。
技巧与最佳实践
构建数据包时,以下排障技巧和最佳实践很有帮助:
- 若报错「包无法安装」,先确认环境设置——您不能在创建包的同名 org 中安装标准包;
- 若需定期升级或更新,请创建托管包版本——新版本需安装到目标 org 才能反映最新更新;
- CRM 和 Commerce 数据包可在 org 中打包并复用多次,并可映射到多个 org;
- 计算洞察应在已建立并映射了相应数据模型的 org 中打包使用——缺少所需数据模型就无法部署;
- 新增数据模型关系时,务必在新版本包中包含这些关系。
遵循这些实践能确保顺畅的订阅者体验,并减少支持负担。
分发 Data 360 应用
测试和打包完成后,就可以分发解决方案了。分发渠道包括:
- AppExchange:在 Salesforce AppExchange 公开上架,需通过安全审查,触达所有 Salesforce 客户(覆盖面最大);
- 私密上架(Private Listing):通过邀请分享给特定客户,不公开上架、无需安全审查;
- 直接安装:直接分享包安装 URL,适合内部团队或小客户群。
托管包分发的收益:可升级(推送修复和新功能)、许可管理(控制谁可用)、IP 保护(源代码对订阅者隐藏)。
Get Cloudy 满意后,把包版本提升为已发布版本,然后在 AgentExchange 发布应用的剩余步骤包括:提交 AgentExchange 安全审查、起草发布说明和安装后说明、以及在 AgentExchange 发布应用。祝打包愉快,AgentExchange 见!