一、设置你的 Data 360 沙盒(Set Up Your Data 360 Sandbox)
本单元涵盖沙盒的创建。我们先介绍 Cloud Kicks 场景以及为什么在真实环境测试有风险,定义什么是 Data 360 沙盒,对比沙盒类型,设计沙盒策略,然后逐步讲解创建与启用沙盒、保护连接链路、摄取测试数据。这是整个沙盒生命周期的基础。
学习目标(Learning Objectives)
完成本单元后,你将能够:
- 解释 Data 360 沙盒在 Data 360 生态中的作用。
- 识别可用于开发与测试的不同沙盒类型。
- 从生产环境创建一个 Data 360 沙盒实例。
创新架构(The Architecture of Innovation)
在真实环境测试 Data 360 配置风险极高,尤其当你管理着数百万客户数据点时。一条配置错误的身份解析规则或数据流错误,都可能扰乱真实客户的体验。
Cloud Kicks 是一家定制运动鞋零售商。系统架构师 Jamal Cooks 为 Cloud Kicks 搭建了 Data 360,他的营销团队因能轻松管理数百万客户数据点、统一客户画像而取得了惊人成功。

最近,Cloud Kicks 上线了一个超个性化忠诚度计划,把门店购买历史与实时网页浏览行为结合,即时发送风格推荐。为应对这种大规模数据整合,Jamal 与 DevOps 开发人员 Vijay Lahiri 一起加班加点。
Jamal 尤其担心保护生产数据完整性——他担心在真实环境中直接测试身份解析规则、计算洞察等大量新配置,一个错误就可能扰乱真实客户体验。是时候升级技能,确保新计划尽可能安全、高效地构建与测试。
什么是 Data 360 沙盒(What Is a Data 360 Sandbox?)
Data 360 沙盒是你生产 Data 360 元数据的一份副本。标准 Salesforce 沙盒用于测试核心平台功能,而 Data 360 沙盒专为让你在不影响真实客户画像的情况下测试数据摄取、建模与身份解析而设计。使用 Data 360 沙盒会占用你的生产 org 额度。
如果你不熟悉元数据,可以把它理解为对数据的描述。例如,计算洞察的配置是元数据,会被复制到沙盒;但该计算洞察在生产中产生的输出数据不会被复制。Data 360 沙盒复制数据流、数据模型对象、计算洞察和细分,但它们不包含任何数据。
Jamal 用 Data 360 沙盒来隔离定制与开发工作、测试数据映射与转换逻辑、提供培训环境,并把各项变更批量打包成一次生产部署。
选择你的 Data 360 沙盒类型(Choose Your Data 360 Sandbox Type)
所有标准 Salesforce 沙盒类型都支持 Data 360。虽然这些沙盒在核心 Salesforce 层面有所不同(如数据存储限制不同),但一旦创建完成,Data 360 沙盒的行为完全一致。Jamal 根据 Cloud Kicks 的架构需求评估各选项:
- Developer 与 Developer Pro:非常适合初始 Data 360 设置和基础测试,存储有限,但很适合概念验证。
- Partial Copy:适合用生产数据模型的样本进行测试。
- Full:生产环境的镜像,对性能测试和全规模用户验收测试(UAT)至关重要。
对于新忠诚度计划的初始概念验证,Jamal 决定 Developer 沙盒是最合适的。
设计你的 Data 360 沙盒策略(Design Your Data 360 Sandbox Strategy)
在点击 New Sandbox 之前,你需要一个计划。高级架构师不会随便创建环境,他们会设计全面的 Data 360 生命周期策略。规划沙盒策略时考虑这些关键因素:
- 记录生产基线指标:记录真实环境的当前性能,作为测试前的对比基准。
- 确定数据量需求:确保所选沙盒层级能承载准确测试所需的数据样本量。
- 评估身份解析测试需求:统一画像不会被复制,必须从零构建,据此规划时间。
- 规划连接器验证:记录需要在隔离环境中安全重新认证的外部连接。
- 建立性能基准:在推广到生产前,明确新配置的「成功」标准。
提前规划这些,Jamal 就能保证新的 Developer 沙盒与忠诚度计划概念验证的规模完美匹配。
创建 Data 360 沙盒(Create a Data 360 Sandbox)
策略就绪后,Jamal 在 Cloud Kicks 生产 org 中开始创建。创建沙盒前,确保 Data 360 已在生产 org 中配置完成。本模块假设你是具备相应权限的开发人员,这些步骤无法在 Trailhead Playground 中执行(Playground 不提供沙盒)。
- 在生产 Setup 中,在 Quick Find 框输入
Sandboxes。 - 选择 New Sandbox,输入详细信息,选择偏好的层级。
- 点击 Create。
在沙盒中启用 Data 360(Enable Data 360 in a Sandbox)
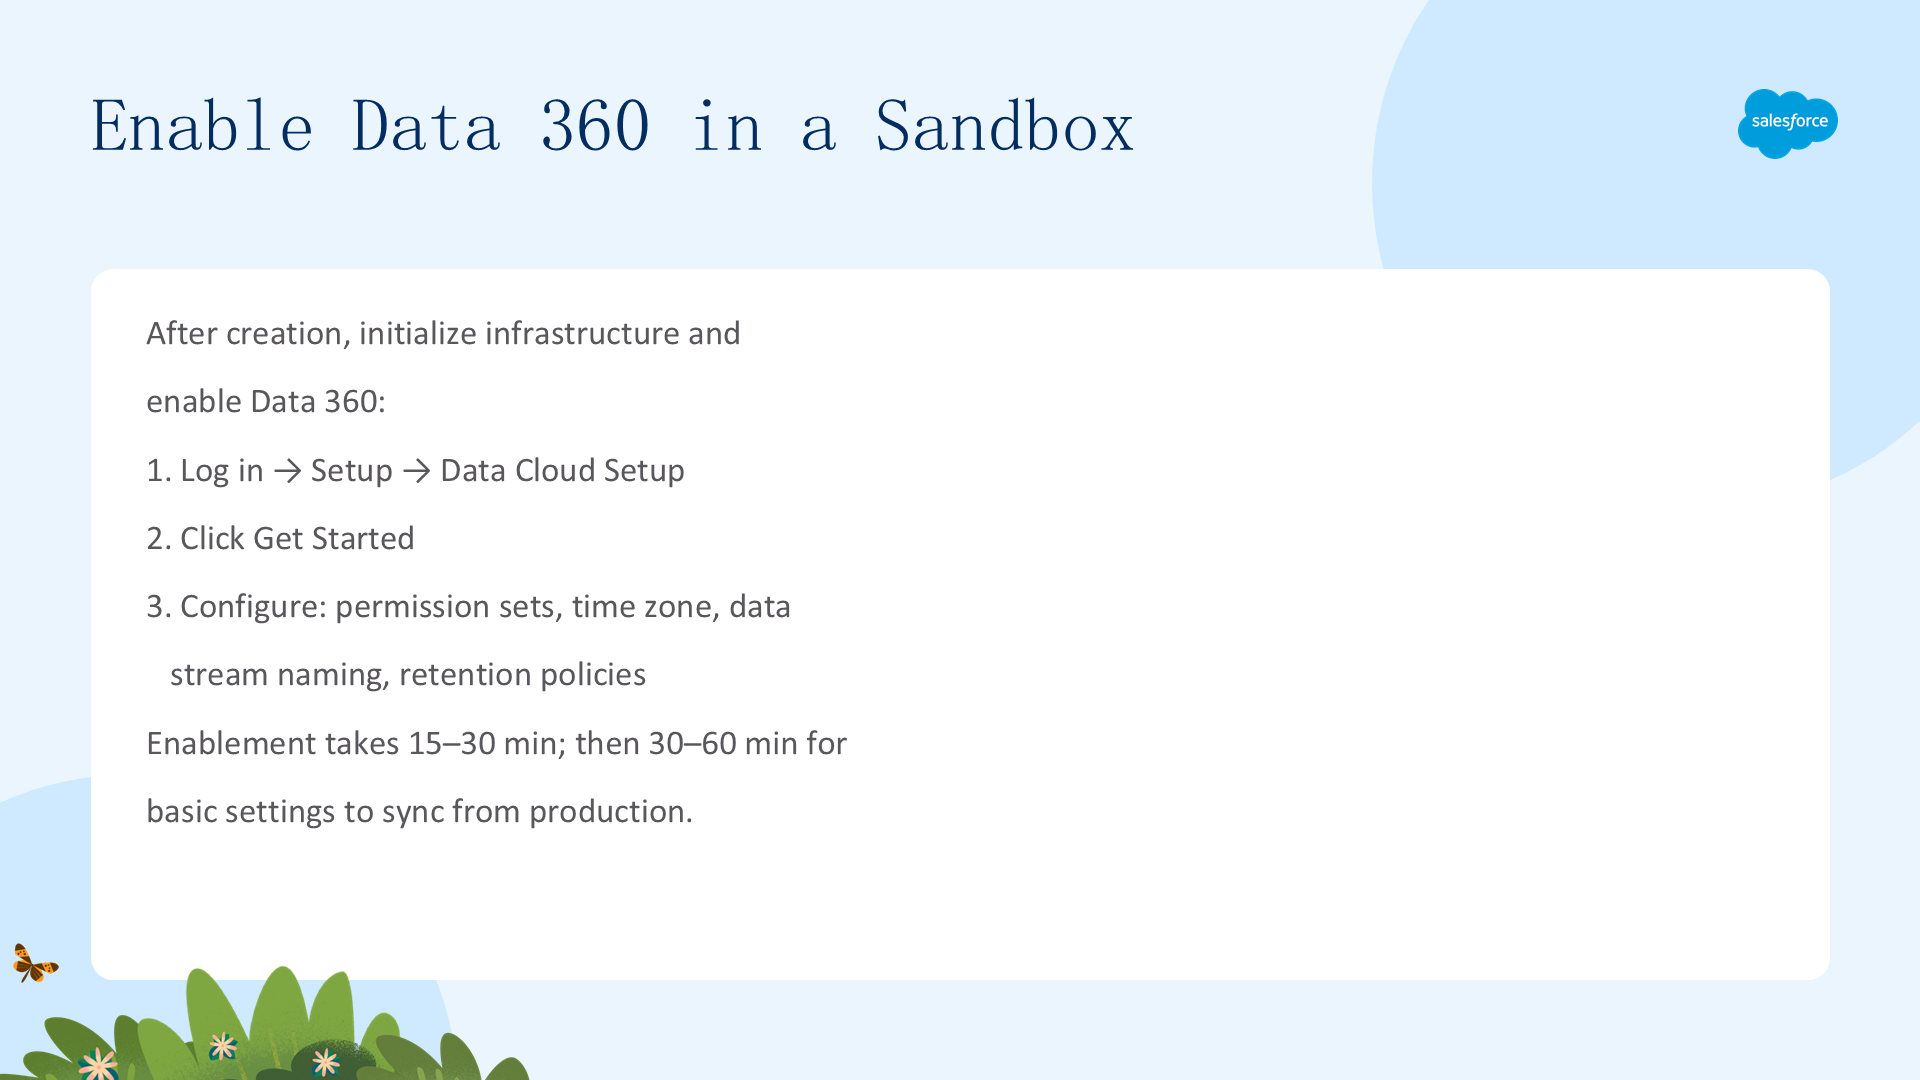
沙盒创建后,Jamal 必须初始化基础设施并启用 Data 360:
- 登录新沙盒,进入 Setup,选择 Data Cloud Setup。
- 点击 Get Started。
- 配置基本设置,如 Data Cloud 权限集、时区、数据流命名约定和数据保留策略。
启用过程通常需要 15 到 30 分钟,取决于沙盒大小。之后还需再等 30 到 60 分钟,让基本设置从生产 org 同步进来。
保护连接链路(Secure the Connection Links)
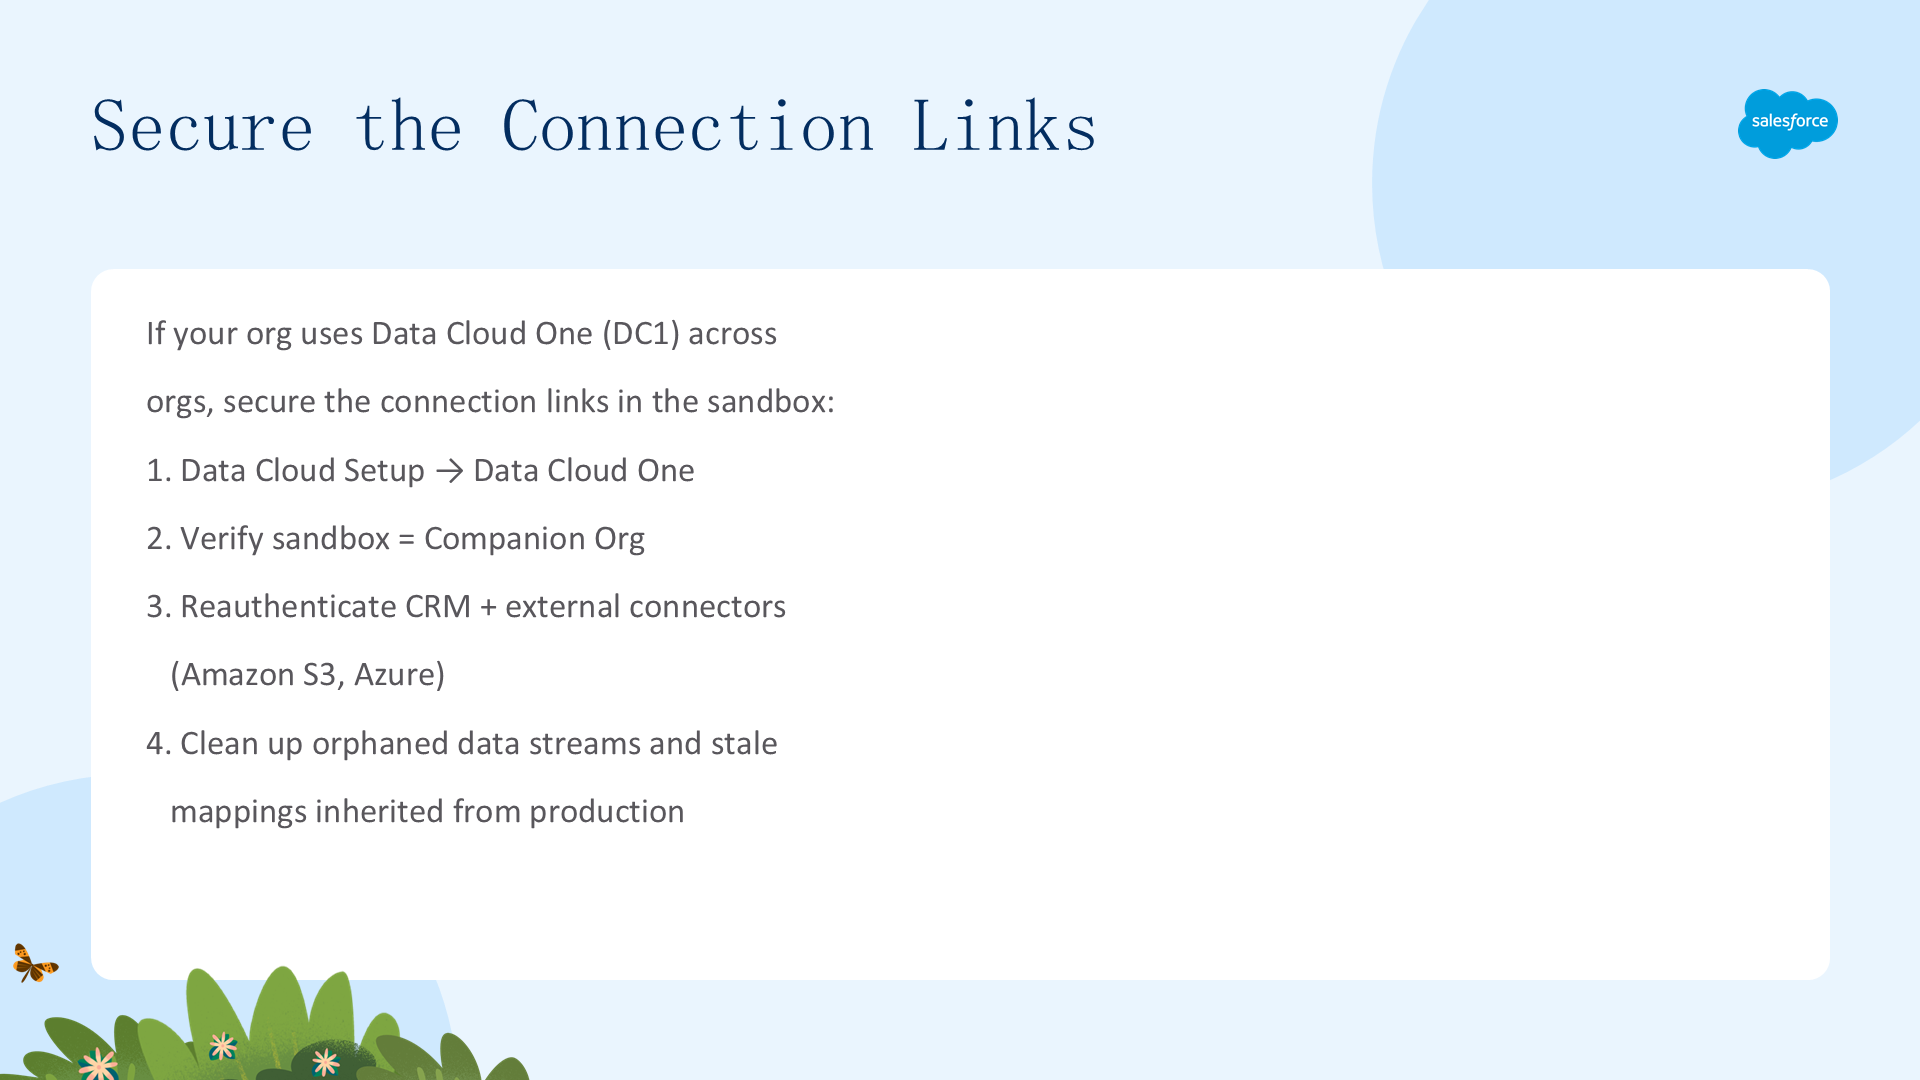
许多企业用 Data Cloud One(DC1)在多个核心 org 间扩展 Data 360 能力。如果你的公司使用这种架构,必须在沙盒中保护这些连接链路。
Data 360 沙盒就绪后,Jamal 把 Cloud Kicks 的 DC1 org 连接到沙盒 org。由于沙盒是生产的副本,它常需要明确指示:应该与真实生产 org 通信,还是与其沙盒版本通信。Jamal 保护链路的方式:
- 在 Data Cloud Setup 的 Quick Find 框中搜索并选择 Data Cloud One。
- 验证沙盒 org 已作为 Companion Org 连接。
- 重新认证 CRM 连接器和 Amazon S3、Microsoft Azure 等外部存储连接器。
- 用元数据清理流程,移除从生产继承但沙盒环境不需要的孤立数据流或过期数据映射。
摄取并测试数据(Ingest and Test Data)
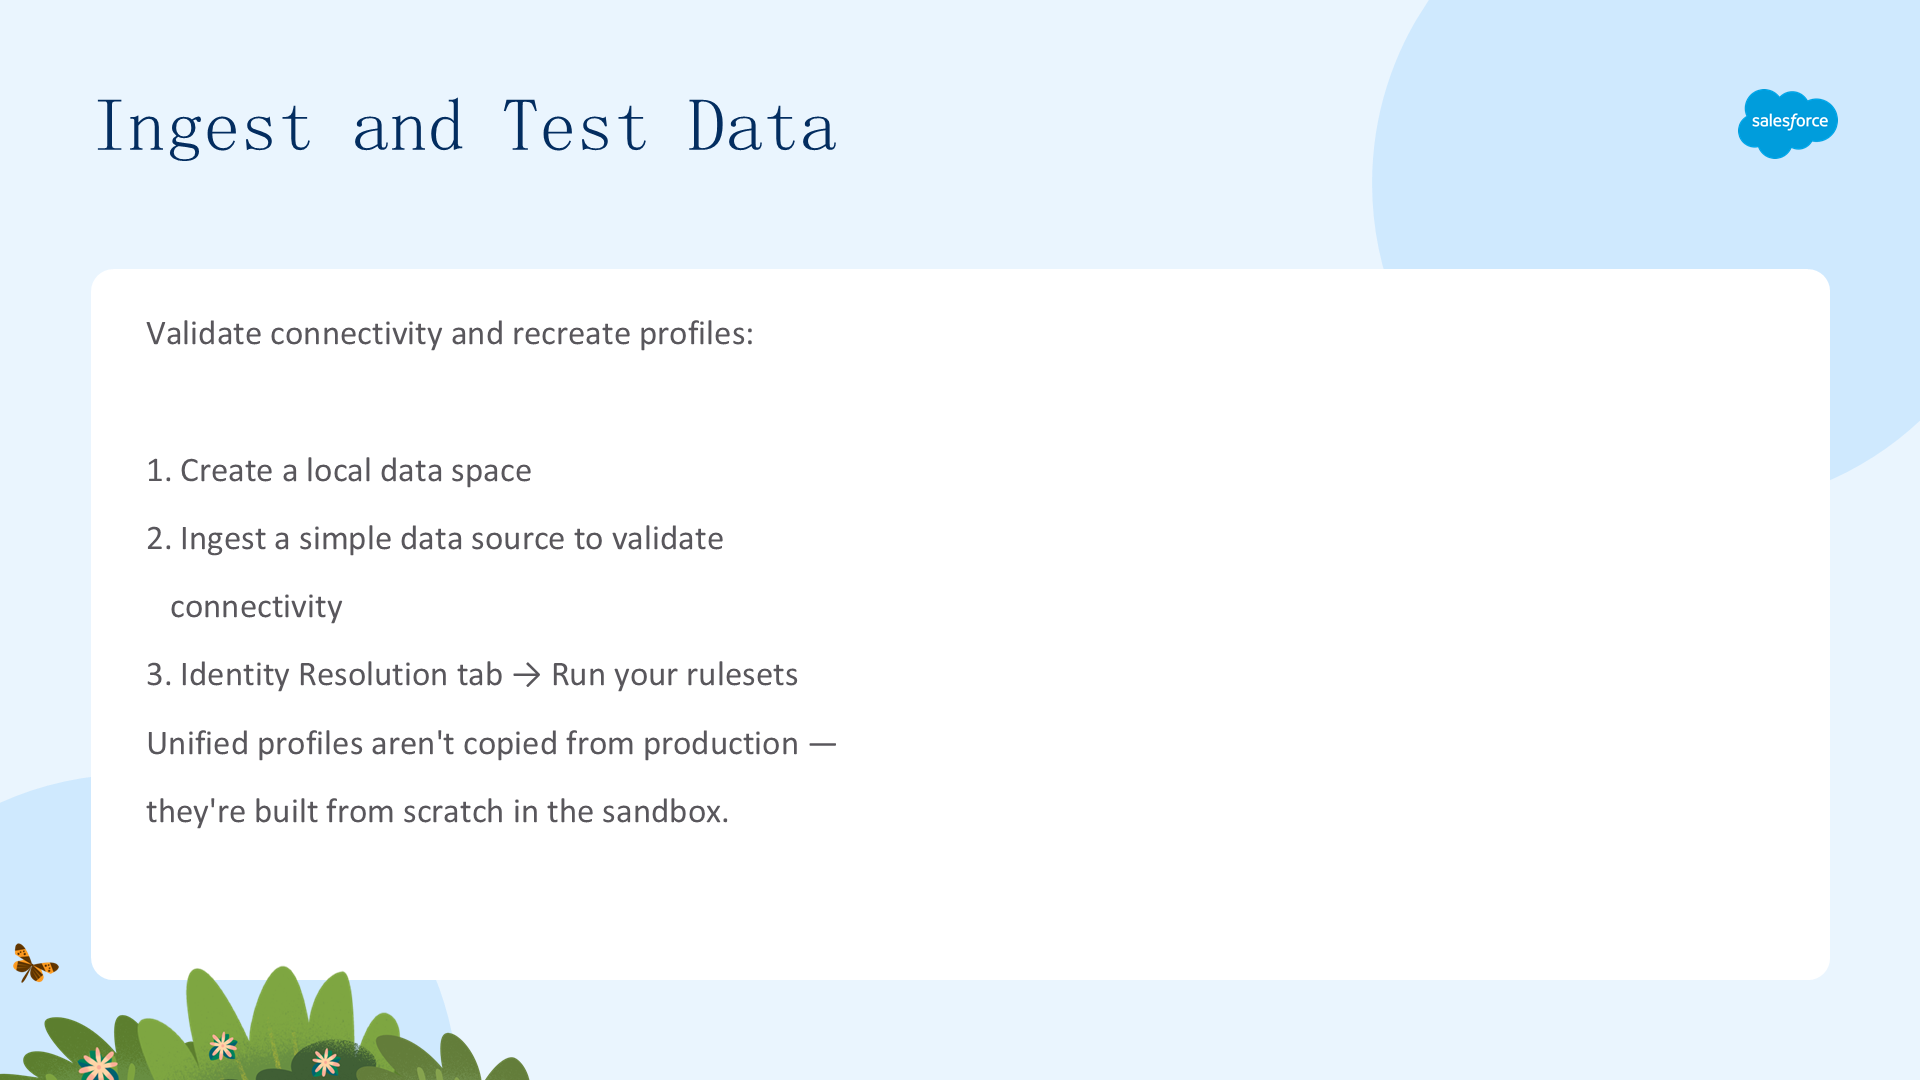
为测试新的超个性化忠诚度计划,Jamal 必须验证沙盒连接性并重建客户画像。做法是摄取一个简单的数据源并运行身份解析规则:
- 创建本地数据空间(data space)。
- 摄取数据流,从一个简单数据源开始验证连接性。
- 数据摄取后,进入 Identity Resolution 标签页,点击 Run 运行规则集。
因为统一画像不从生产复制,必须在 Data 360 沙盒中从零构建。
二、刷新并同步你的 Data 360 沙盒(Refresh and Synchronize Your Data 360 Sandbox)
本单元讲保持同步。元数据漂移很快,过期的沙盒会产生有缺陷的测试结果。我们通过一个具体的 Rule Set 场景讲清元数据漂移问题、如何为 CRM 沙盒刷新做准备、如何刷新 Data 360 沙盒,以及刷新后重建连接与身份解析的检查清单。
学习目标(Learning Objectives)
完成本单元后,你将能够:
- 描述在 Data 360 生产与沙盒环境间同步元数据的过程。
- 在刷新后的 Data 360 沙盒中配置安全的数据连接。
- 实施清理流程以移除过期的元数据。
避免元数据漂移(Avoid Metadata Drift)
元数据不断变化。如果你的沙盒落后于生产,任何测试都可能无效。因为刷新只复制元数据(配置)而非实际数据,一个六个月前的沙盒只是过去的快照,在这种状态下测试会导致有缺陷的结果,在生产中失败。
Cloud Kicks 场景:生产 org 中,Jamal 更新了身份解析规则集(Rule Set 2.0),新增了更严格的匹配标准以确保高质量的统一画像。六个月后,Vijay 在自 Jamal 改动后就没刷新过的 Developer 沙盒中工作,基于现有统一画像构建了一个针对高价值客户的复杂细分,成功测试返回 10000 个统一画像,以为可以部署。
元数据漂移的发生是因为 Vijay 的沙盒还是较宽松的 Rule Set 1.0 元数据。当他部署到生产时,细分立刻失败。为什么?
- 依赖失败:细分逻辑依赖较旧的宽松身份解析结果。
- 意外行为:在生产的 Rule Set 2.0 下只找到 8500 个画像,突然排除了 1500 个目标客户,破坏了忠诚度计划上线。
避免这种生产失败的唯一方法,是确保你构建所基于的沙盒配置是生产最新元数据的镜像。这让及时的沙盒刷新和刷新后检查清单成为架构师工作流的关键部分。
准备 CRM 沙盒刷新(Prepare for a CRM Sandbox Refresh)
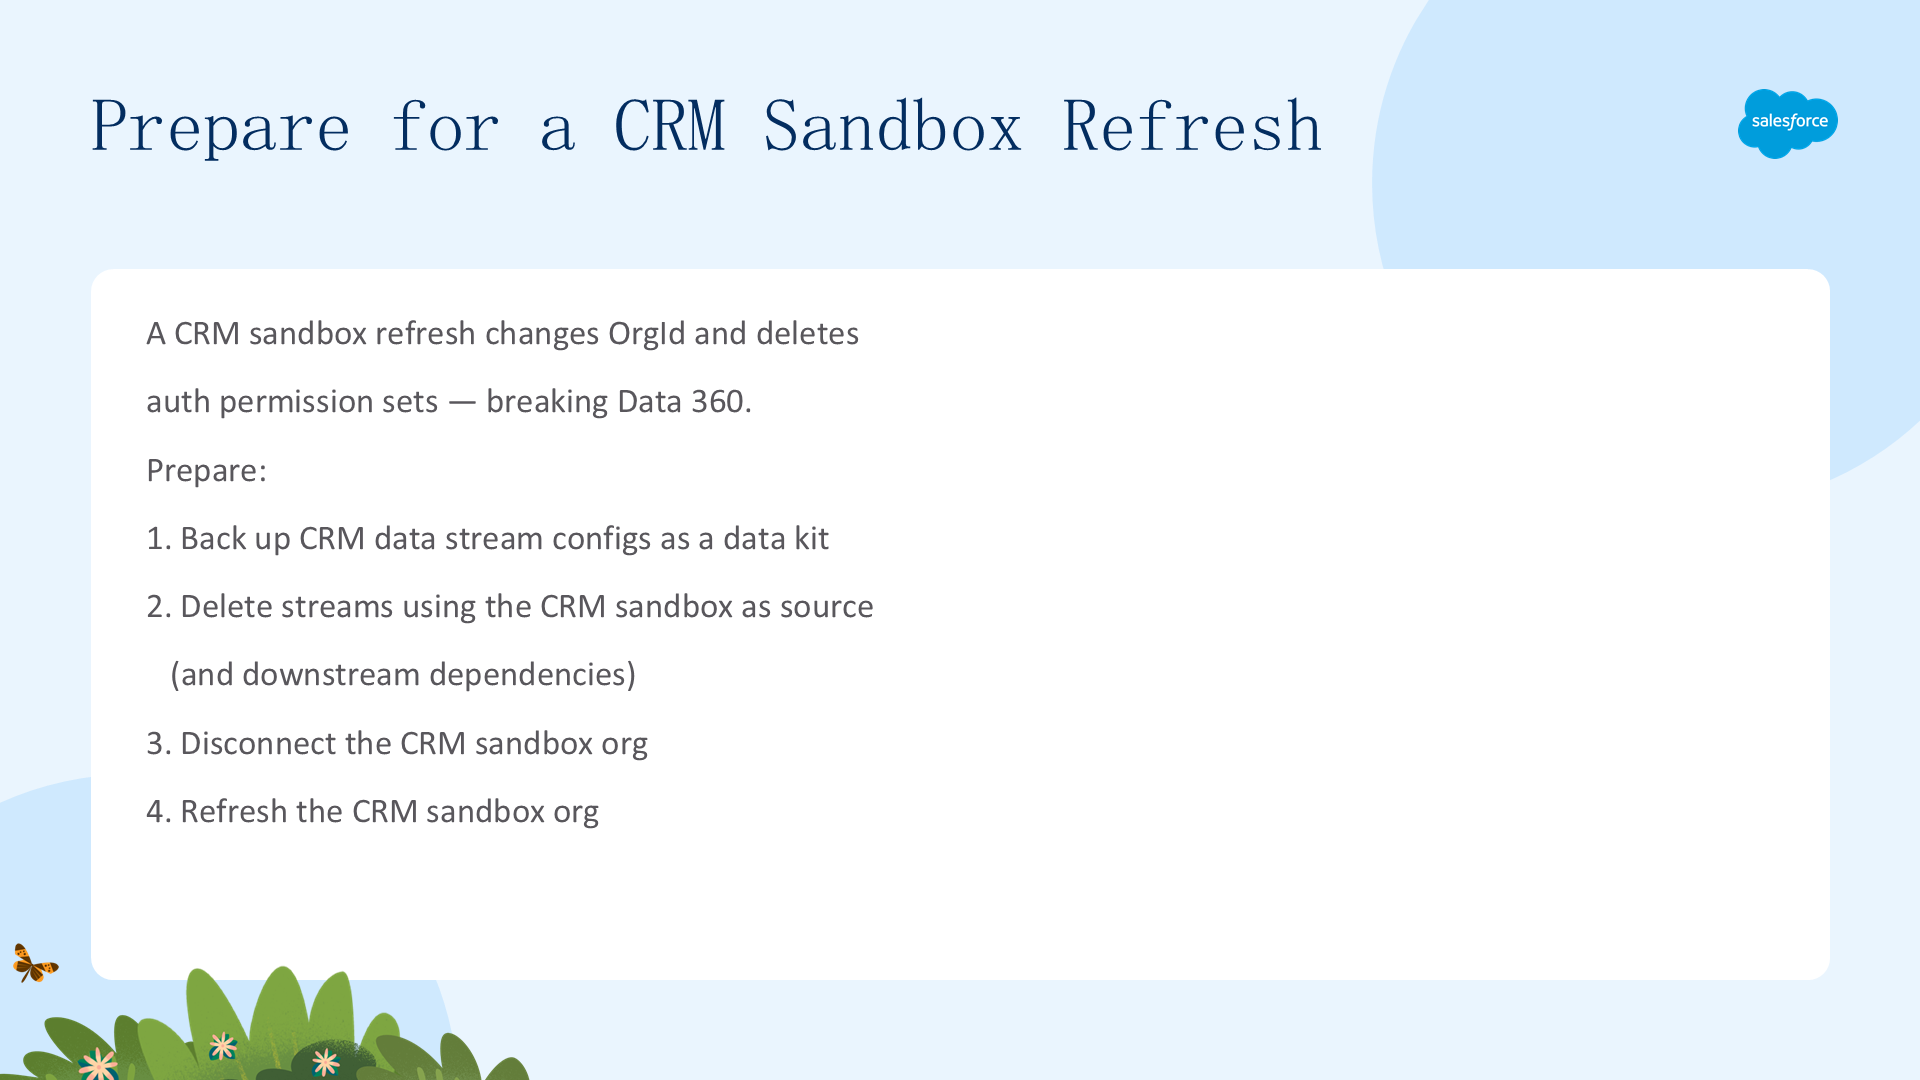
刷新前,Vijay 梳理环境依赖。因为 Cloud Kicks 从 Salesforce CRM 沙盒拉取客户忠诚度数据,刷新该 CRM 沙盒前必须采取特定操作。CRM 沙盒刷新时,其 OrgId 会改变、认证权限集会被删除,这会永久破坏与 Data 360 的连接。若不准备,所有以该 CRM 沙盒为源的数据流都会进入错误状态,系统也会阻止你直接断开该 org。
按以下步骤安全准备 CRM 沙盒刷新:
- 创建 DevOps 数据工具包备份 CRM 数据流配置。
- 删除以该 CRM 沙盒 org 为源的数据流,可能还需删除数据映射、细分属性等下游依赖。
- 进入 Data Cloud Setup,选择 Salesforce CRM Connector,断开 CRM 沙盒 org。
- 刷新 CRM 沙盒 org。
刷新你的沙盒(Refresh Your Sandbox)
准备完成后,Vijay 可以刷新 Cloud Kicks Data 360 沙盒了。沙盒刷新从源 org 更新沙盒的元数据,但不更新数据。
- 元数据同步:刷新会复制所有 Data 360 配置,包括数据流、计算洞察和细分。
- 影响:刷新会覆盖沙盒中任何已有工作。
警告:刷新前务必用 DevOps 数据工具包备份沙盒元数据。
- 进入 Setup,在 Quick Find 框输入
Sandboxes。 - 点击沙盒名称旁的 Refresh 链接。
- 查看并编辑名称和描述。
- 选择沙盒许可证类型(Developer、Developer Pro、Partial Copy 或 Full)。
- 点击 Create。
完成刷新后检查清单(Complete the Post-Refresh Checklist)
刷新只是第一步。Vijay 必须重建「管道」,让 Cloud Kicks 的数据重新流动。按以下刷新后检查清单恢复环境:
- 重建 CRM 连接:若刷新了连接的 CRM 沙盒,必须重建外部 org 用户权限集、重新连接 CRM 沙盒 org 到 Data 360、重建对象与字段权限,最后安装数据工具包重新部署数据流。
- 重新认证连接器:为安全起见,Marketing Cloud Engagement 等外部系统连接需在沙盒中重新授权。
- 初始化身份解析:刷新复制了身份规则,但必须手动触发首次运行以在沙盒中生成统一画像。
- 管理 DC1 连接:若企业使用 DC1,刷新作为 DC1 companion org 的沙盒时,与主 Data 360 org 的连接会断开,刷新完成后必须重建 DC1 连接。
- 清理过期元数据:用 Data Cloud Setup 菜单识别并删除同步过程中产生的孤立数据流或映射错误。
三、将 Data 360 配置打包进 DevOps 数据工具包(Bundle Data 360 Configurations into a DevOps Data Kit)
本单元讲打包。DevOps 数据工具包把 Data 360 组件打包成单一单元,用于可重复、可审计的推广。我们讲什么是数据工具包、对比标准与 DevOps 数据工具包、讲解打包配置,并管理依赖层级让部署不因缺少依赖而失败。
学习目标(Learning Objectives)
完成本单元后,你将能够:
- 解释数据工具包在 DevOps 生命周期中的目的。
- 创建 DevOps 数据工具包打包 Data 360 组件。
- 识别支持的组件与依赖。
高效管理部署(Manage Deployments Efficiently)
Vijay 需要一种高效方式把新忠诚度计划配置移到生产,而不是手动重建 50 个不同的数据映射。DevOps 数据工具包把 Data 360 组件打包成单一单元,用于跨环境的可重复、可审计、安全的推广。
对企业团队而言,数据工具包不仅是传输机制,更是发布工件(release artifacts)。它们打包相关配置、确保依赖顺序被遵守、为部署创建审计轨迹。作为最佳实践,Vijay 创建数据工具包时遵循:使用发布命名约定(如 v1.2-loyalty-enhancement)、审查组件发布顺序、若在沙盒新建数据空间需确保目标 org 存在同名空间、给发布打上对应生产部署日期的标签。
对比标准与 DevOps 数据工具包(Compare Standard and DevOps Data Kits)
打包忠诚度计划配置前,Vijay 必须选择适合架构的数据工具包类型。两种类型面向不同受众:
- 标准(Standard)数据工具包:面向 Salesforce 合作伙伴,用于 AgentExchange 解决方案包,聚焦解决方案交付。
- DevOps 数据工具包:面向企业架构师与 DevOps,用于内部环境迁移,促进自有环境间配置变更的可控、可重复推广(如从 Developer 沙盒到 UAT 再到生产)。
选择 DevOps 数据工具包,意味着打包的组件属于结构化、可审计的部署管道,而非外部解决方案。
打包你的配置(Bundle Your Configurations)
为安全移动新忠诚度计划元数据,Vijay 创建 DevOps 数据工具包。在 Data 360 沙盒中,你可以把多个核心元数据组件打包进数据工具包,支持的组件包括:
- 数据流(data streams):摄取数据的模式与源详情。
- 数据模型对象(DMOs):流映射到的标准与自定义数据模型。
- 计算洞察(calculated insights):用于忠诚度评分等的 SQL 逻辑。
- 身份解析规则(identity resolution rules):统一画像的匹配与协调逻辑。
- 细分(segments):目标营销的受众标准。
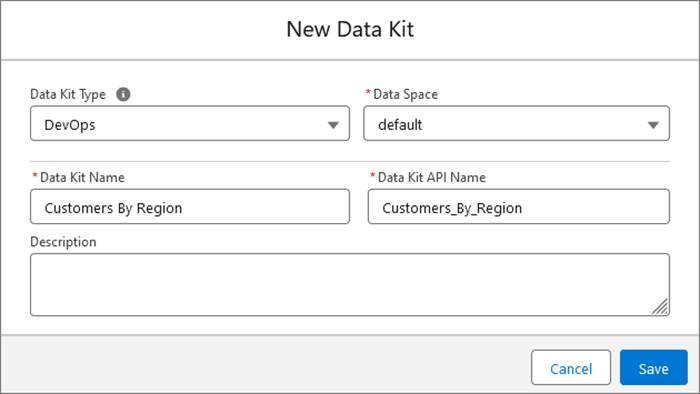
Vijay 按以下步骤打包配置:在沙盒 org 进入 Setup,选择 Data Cloud Setup;在 Developer Tools 下选择 Data Kits;点击 New,选择 DevOps Data Kit;选择数据空间,输入数据工具包名称,点击 Save。
管理依赖层级(Manage the Dependency Hierarchy)
依赖层级对部署成功至关重要。Vijay 构建数据工具包时按严格顺序管理依赖:
- 从 Data Kit 页面选择数据工具包并添加支持的组件。(注意:添加数据流时 Data 360 会自动包含数据映射等依赖。)
- 先用数据流打好基础:先添加 Amazon S3 或 CRM 数据流,选择数据流时 Data 360 会智能拉入关联的数据湖对象(DLOs)。
- 用映射连接管道:添加数据模型对象(DMOs)时,务必勾选 Include Mappings,确保原始数据落到目标 org 时知道属于统一数据模型的哪个部分。
- 审查发布顺序:在 Data Kit 页面审查发布顺序以防缺少依赖错误——若细分依赖某个计算洞察,确保该计算洞察先于细分部署。
- 确认组件与依赖后点击 Save。
提示:每个数据工具包使用语义化版本(如 v1.3-loyalty-update),并把导出的 manifest 存到源代码控制。
四、部署并验证你的 Data 360 配置(Deploy and Validate Your Data 360 Configurations)
本单元是最后冲刺。部署只是故事的一半,激活与验证才能确认配置在生产规模下正确运行。我们审查部署前检查清单、对比部署工具、讲解变更集与 Salesforce CLI、应对 CLI 局限与排查、完成部署后检查清单,并用身份解析与测试画像验证管道。
学习目标(Learning Objectives)
完成本单元后,你将能够:
- 对比部署方法(变更集、Salesforce CLI、DevOps 工具)。
- 应用部署前检查清单确保目标 org 就绪。
- 在生产中激活数据流并验证摄取。
- 验证数据映射与身份解析过程。
审查部署前检查清单(Review the Pre-Deployment Checklist)
大规模部署 DevOps 数据工具包需要企业级治理。Vijay 移动任何元数据到生产前,Jamal 先做就绪检查。为避免部署失败,按以下部署前检查清单确保目标环境已准备:
- 数据空间一致性:确保沙盒与生产 org 对数据空间的处理一致,若沙盒中存在生产没有的数据空间,部署前必须手动在生产中创建。
- 功能对等:验证沙盒启用的所有 Data 360 功能在生产中也都激活。
- 跨 org 部署策略:跨不同生产 org 移动元数据需遵循严格路径。
- 部署发布顺序:在 Data Kit 页面审查发布顺序以防缺少依赖错误。
- 重新部署规则:组件部署后若更新并想重新部署,务必创建新的数据工具包。
- 变更集依赖:若使用变更集,上传前执行预检查,确保已手动添加所有必要的组件依赖。
选择正确的部署工具(Choose the Right Deployment Tool)
迁移并非一刀切。根据复杂度,Vijay 可能用不同工具把配置移到生产。三种工具:
- 变更集(Change Sets):适合简单迁移,只适用于已连接的 org,无版本控制,不能部署所有元数据类型。
- Salesforce CLI / Metadata API:版本化部署的黄金标准,把 Data 360 配置当代码存到 Git,但需要 CLI 知识与管道设置。
- 外部 DevOps 工具(Copado、Gearset、GitLab):企业 CI/CD 管道,在 CLI 之上提供可视化抽象,管理版本控制、自动化测试与顺序推广,但引入许可成本与学习曲线。

变更从开发者沙盒流出,经集成与用户验收测试(UAT),最终到达生产。
使用变更集部署(Deploy Using Change Sets)
对简单迁移,可用标准 Salesforce 变更集。Vijay 上一单元已构建 DevOps 数据工具包,可把它打包进变更集移到生产:
- 授权连接:在生产(目标)org 创建部署连接,允许来自沙盒的入站变更集。
- 创建出站变更集:在沙盒 org 进入 Setup,创建出站变更集。
- 添加数据工具包:Component Type 字段选择 Data Package Kit Definition,添加 DevOps 数据工具包。
- 添加依赖:点击 View/Add Dependent Components 加入必要的 DMO 关系,逐页滚动确保全部捕获。(注意:删除所有 key qualifier 文件,不要为统一个体等派生对象添加关系,这些自动处理。)
- 上传并部署:上传出站变更集,登录生产 org,进入 Inbound Change Sets,点击 Deploy 部署变更集及其功能。
使用 Salesforce CLI 部署(Deploy Using the Salesforce CLI)
为管理关键忠诚度计划及其众多部件,Vijay 选择 Salesforce CLI 与 Cloud Kicks 的版本控制系统集成:
- 在沙盒 org 进入 Data Cloud Setup,点击 Data Kits。
- 选择 DevOps 数据工具包,点击 Download Manifest。下载的
package.xml包含该数据工具包相关的所有元数据实体,用于在 SFDX 项目中检索数据工具包元数据。 - 检索元数据到沙盒 org:运行
sf project retrieve start --manifest manifest/package.xml。 - 命令完成后出现新项目文件夹,考虑把整个项目上传到 GitHub 等源代码控制以利于版本控制与协作。(重要:不要跳过删除 key qualifier 文件这一步。)
- 部署到生产 org:运行
sf project deploy start --manifest manifest/package.xml。
应对 CLI 与源代码控制的局限(Navigate CLI and Source Control Limitations)
Vijay 扩展 Cloud Kicks 部署时,需仔细管理这些已知 CLI 局限:
- 新文件生成:同一底层组件加入多个数据工具包并多次检索时,命名不一致会导致每次都生成全新 XML 文件。
- 无法跟踪变更:每次生成新文件,开发人员难以跟踪单一组件随时间的变化,
git diff、git blame、git merge等标准命令失效。 - 合并冲突与冗余:多个开发人员处理相同组件或创建多个数据工具包时,不一致命名的文件激增会造成严重合并挑战和仓库杂乱。
- 模板名冲突:同一计算洞察加入多个数据工具包时,生成的模板名可能冲突(如 CI、CI1、CI2)。
- 合并失败:多个开发人员在各自沙盒创建同名数据工具包并合并时,发布顺序不会合并,组件也因对同一组件的多个模板引用冲突而合并失败。
排查部署错误(Troubleshoot Deployment Errors)
监控与排查是确保部署顺畅的重要技能。以下是 Cloud Kicks 团队可能遇到的静默失败及修复:
- 不兼容映射(Incompatible Mapping):DMO 字段类型在 org 间不同。修复:在源 org 对齐字段类型并重新打包数据工具包。
- 缺少数据空间(Missing Data Space):数据工具包引用了未创建的数据空间。修复:在目标 org 手动创建数据空间并重新部署。
- 空结果(Null Results):身份解析尚未运行。修复:在 Identity Resolution 标签页手动触发运行。
完成部署后检查清单(Complete the Post-Deployment Checklist)
元数据已到达生产!但 Vijay 的工作还没完,他必须遵循严格的部署后工作流确保数据正确流动:
- 查看部署历史:检查数据前先验证部署已成功处理。进入 Data Cloud Setup,选择 Data Kits,打开已部署的工具包,查看 Deployment History 标签页,确保所有组件按顺序成功发布。
- 管理数据流部署行为:部署的数据流以「草稿」状态到达,必须激活才能处理真实数据。激活步骤因源系统而异:CRM 数据流部署时连接器会部署,但若连接未立即激活,关联数据流可能安装失败——需先在目标 org 手动激活连接器,再重新部署数据工具包;非 CRM 数据流(如 Amazon S3)连接器与数据流都会成功部署但处于非激活状态——只需进入连接器点击激活,无需重新部署。
- 启动摄取:连接器激活后,进入 Data Streams 标签页,选择已部署的数据流,点击 Start Ingestion。
执行身份解析审计(Perform an Identity Resolution Audit)
部署后,新摄取的数据流流入环境。但系统不会在这批新元数据上自动运行身份解析,因为统一画像被视为运营数据,必须在新环境中从零构建。Jamal 的身份解析审计是关键检查点:
- 进入 Data Cloud Setup 中的 Identity Resolution 标签页。
- 点击 Run Ruleset 应用新部署的匹配与协调规则。
- 监控 Metrics 部分,确认处理的输入记录数与生成的统一画像数在预期容差内。
验证数据管道(Validate the Pipeline)
最后一步是端到端验证。Jamal 用一小批已知属性的测试画像作为忠诚度计划的验证检查:
- 进入 Data Profile 标签页,搜索已知画像,如测试客户 Cody the Bear。
- 验证数据映射:检查邮箱地址、忠诚度 ID 等核心字段是否从源数据流准确填充。
- 验证身份解析:确认 Cody the Bear 已被正确统一,所有相关数据记录都显示在单一画像下。
- 确认计算洞察:检查画像的 Calculated Insights 部分,对超个性化忠诚度计划,Jamal 验证 Cody the Bear 正确显示基于测试数据的 Gold Tier(金卡)忠诚度状态。
若验证画像通过这些检查,你的部署即成功。