一、编写简单的 Data 360 SQL 查询
注册包含 Data 360 的自定义 Playground
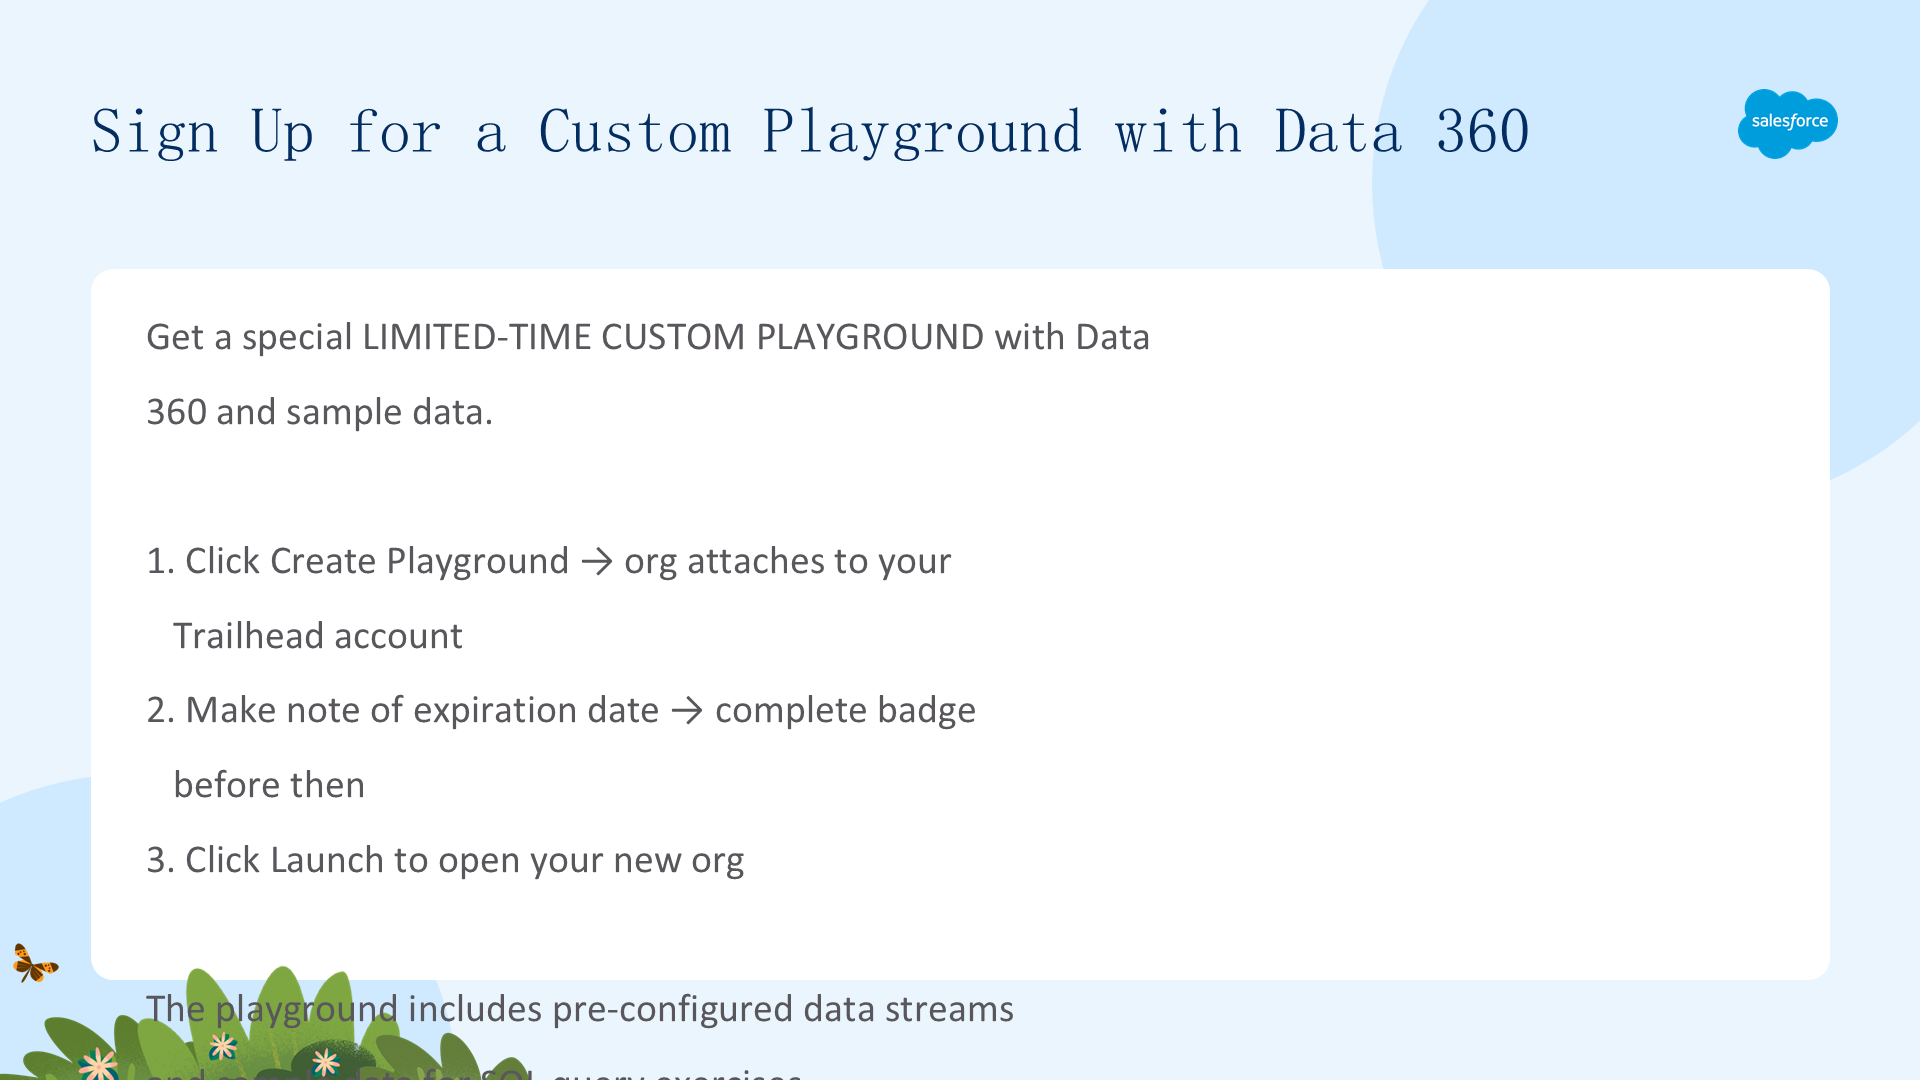
要完成本徽章,您需要一个包含 Data 360 和示例数据的、限时的自定义 Playground。
- 点击 Create Playground;
- 新的 org 会自动附加到您的 Trailhead 账户;
- 记下 org 的到期日期,并在此之前完成本徽章。
连接您的数据
Data 360 中的连接始于设置数据流(data streams)——即连接或摄取到 Data 360 的数据源。来自这些数据源的数据存储在数据湖对象(DLO)中,DLO 是数据流数据的存储容器。如果数据需要处理,可以创建公式字段来规范化数据或做基础计算。
数据源可以是其他 Salesforce org、Marketing Cloud Engagement 业务单元、外部平台以及 CSV 文件。本徽章中,我们已经把 Sales Cloud 和 Service Cloud org 连接到了您的 Developer org,因此您只需添加数据流即可。
创建数据流
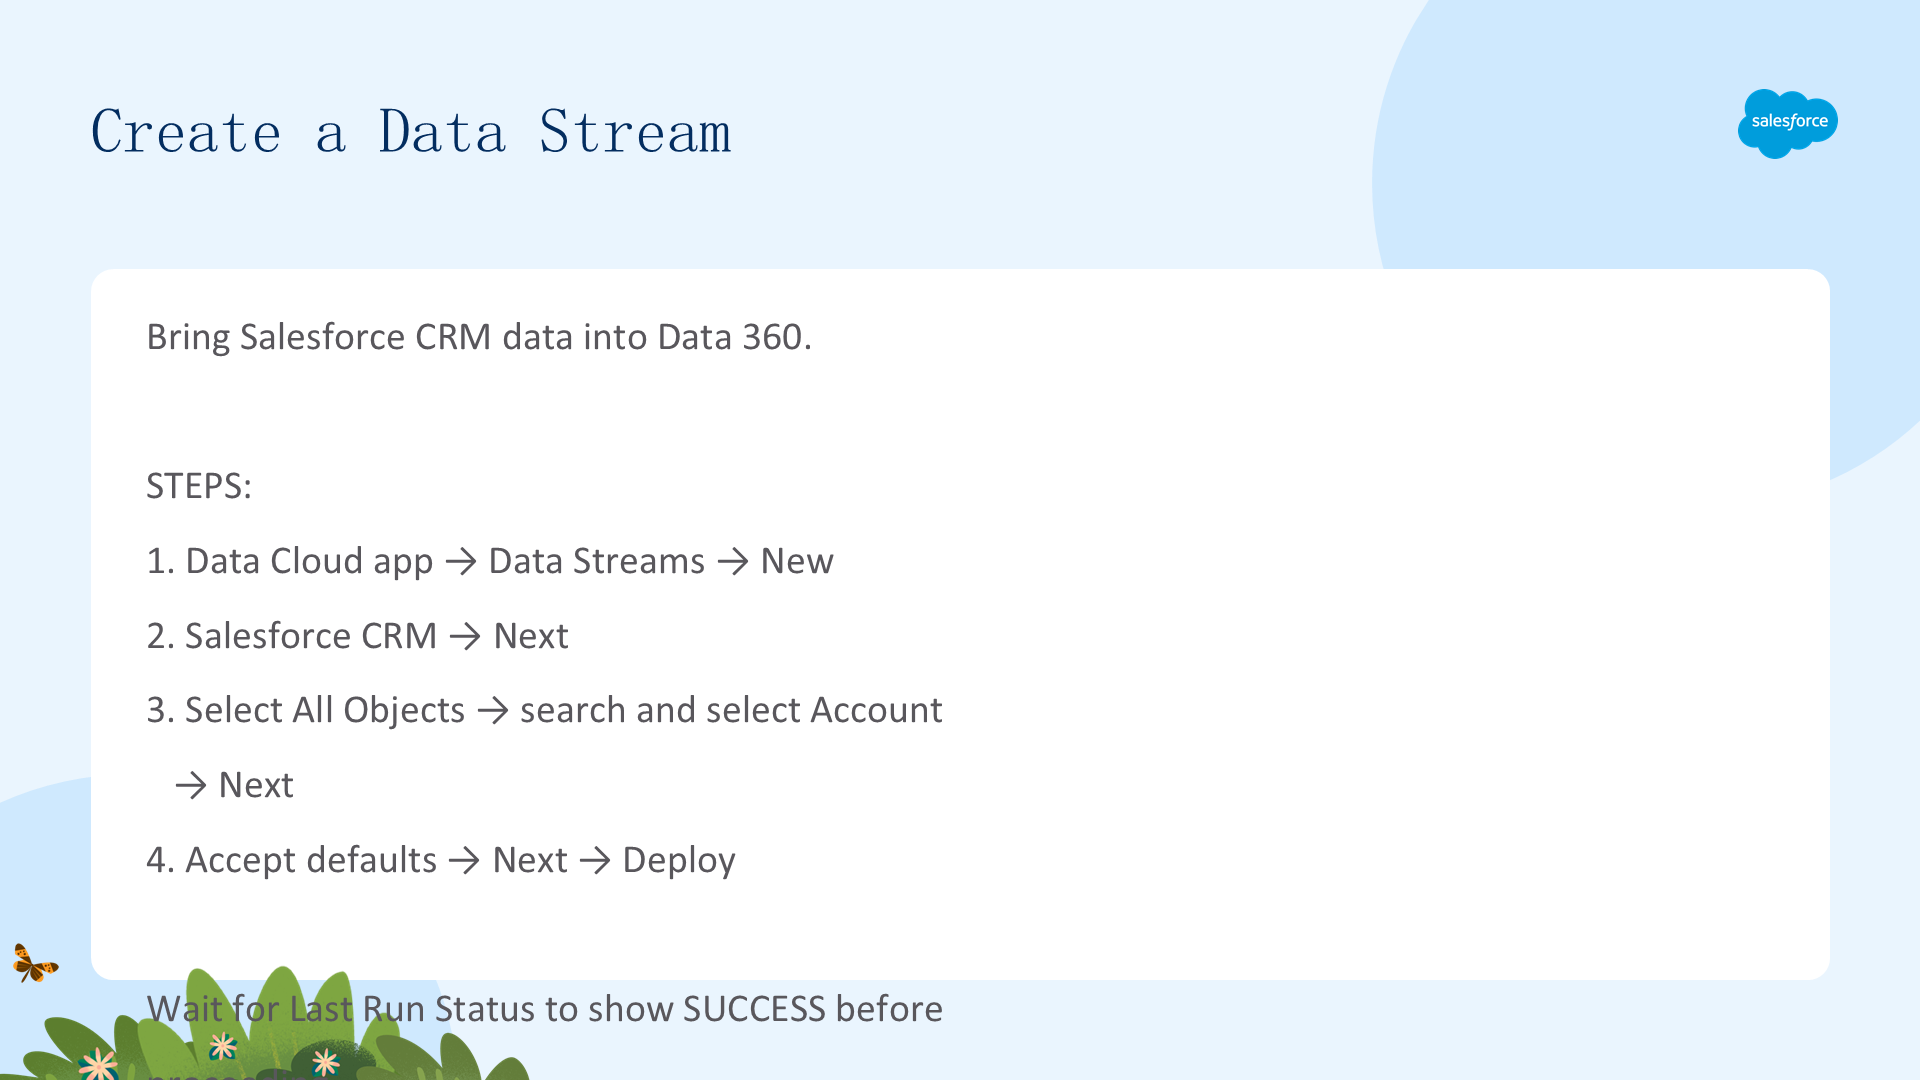
数据通过数据源摄取到 Data 360。数据源连接建立后,就可以添加数据流:
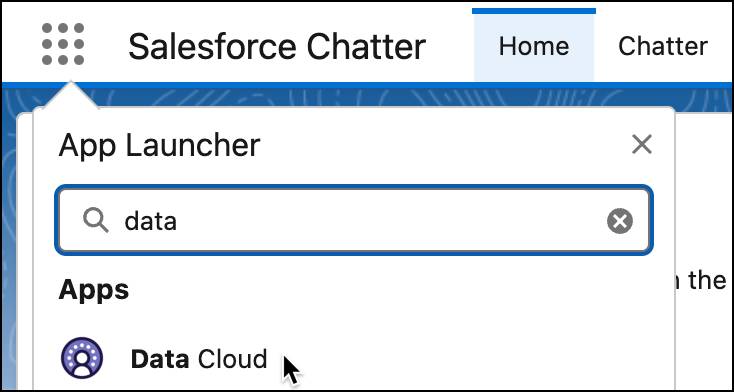
- 登录后,从 App Launcher 搜索并选择 Data Cloud;
- 在 Data Cloud 中进入 Data Streams 标签页,点击 New;
- 在 Connected Sources 下点击 Salesforce CRM,点击 Next;
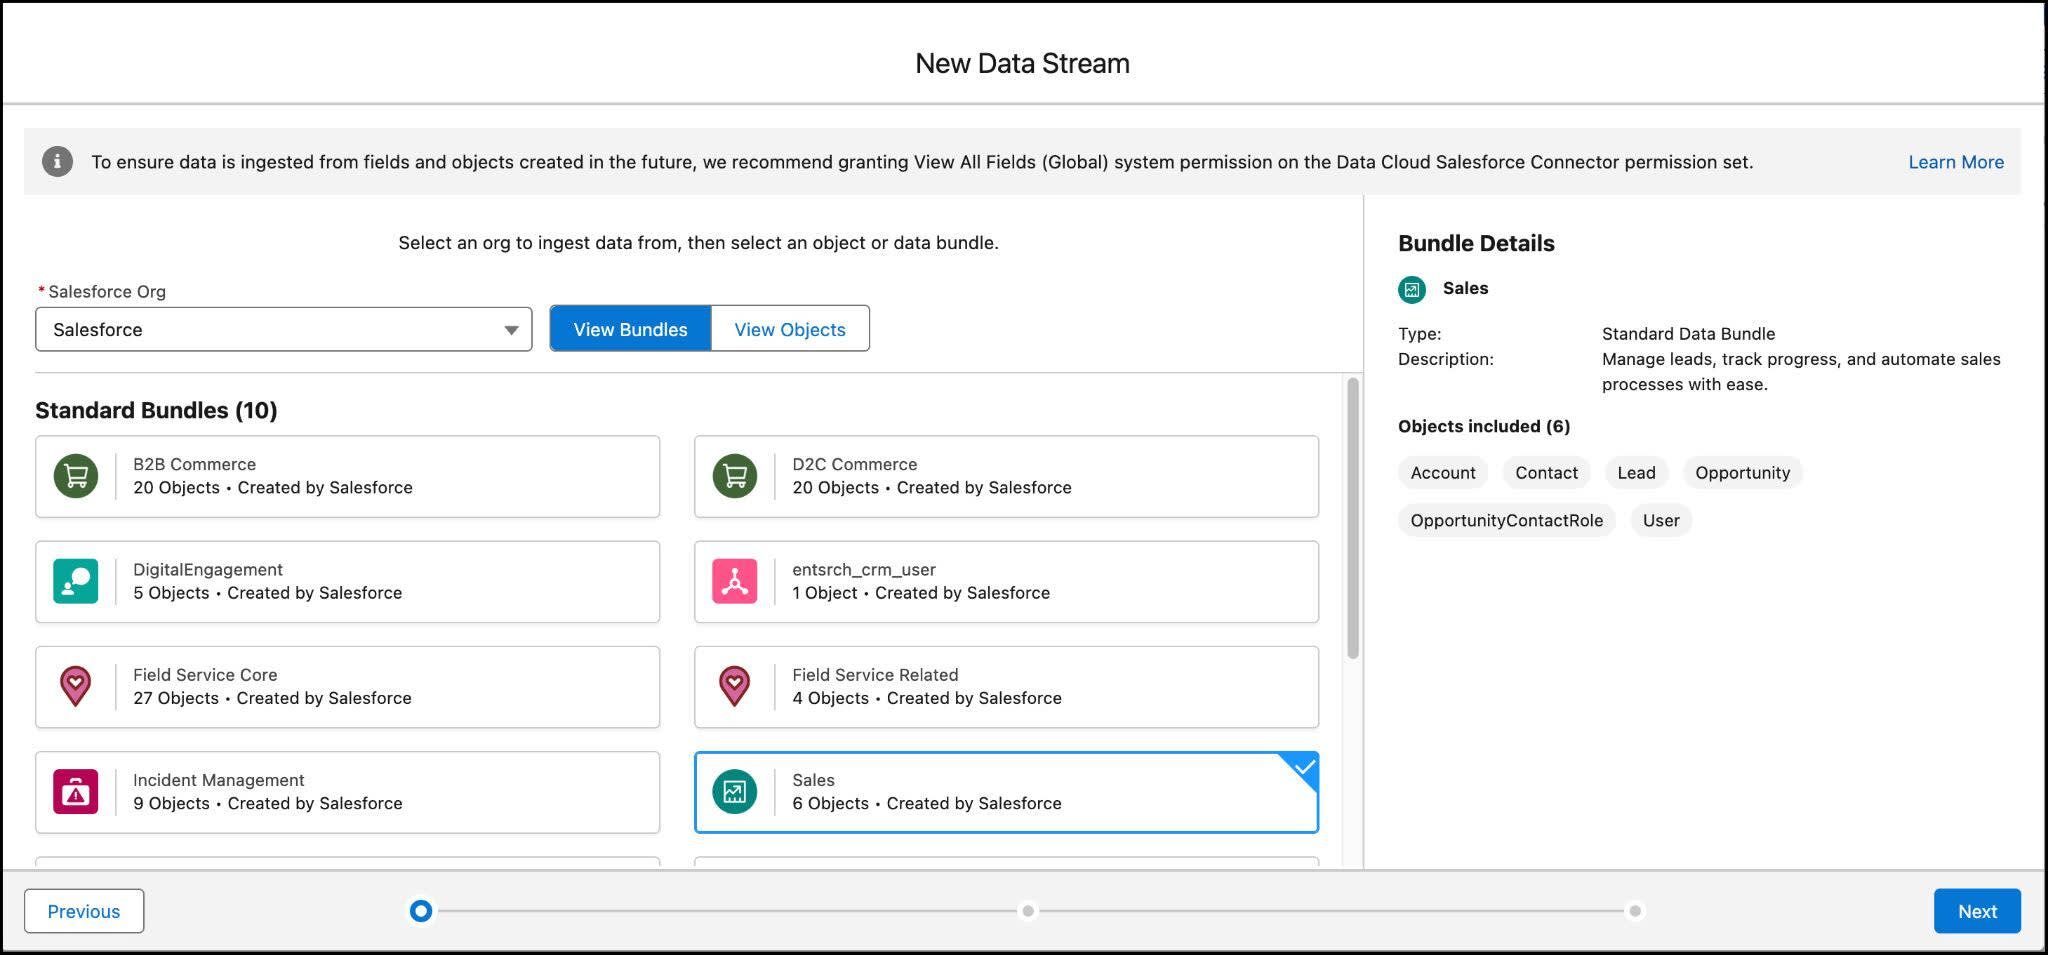
- 注意 Salesforce Org 已预先选中。从 View Bundles 选择 Sales 数据包,点击 Next;
- 查看关联字段,点击 Next(字段出现可能需要几分钟);
- 注意默认 Data Space 已预先选中,数据包中所有字段都已列出。保持选择不变,点击 Deploy。
部署可能需要几分钟。如果遇到问题,请稍等片刻后重试。这样就会创建六个新的数据流。
添加数据流
接下来添加一些数据流,把 Service Cloud 的案例数据连接到 Data 360:
- 在 Data Streams 窗口点击 New;
- 选择 Salesforce CRM,点击 Next;
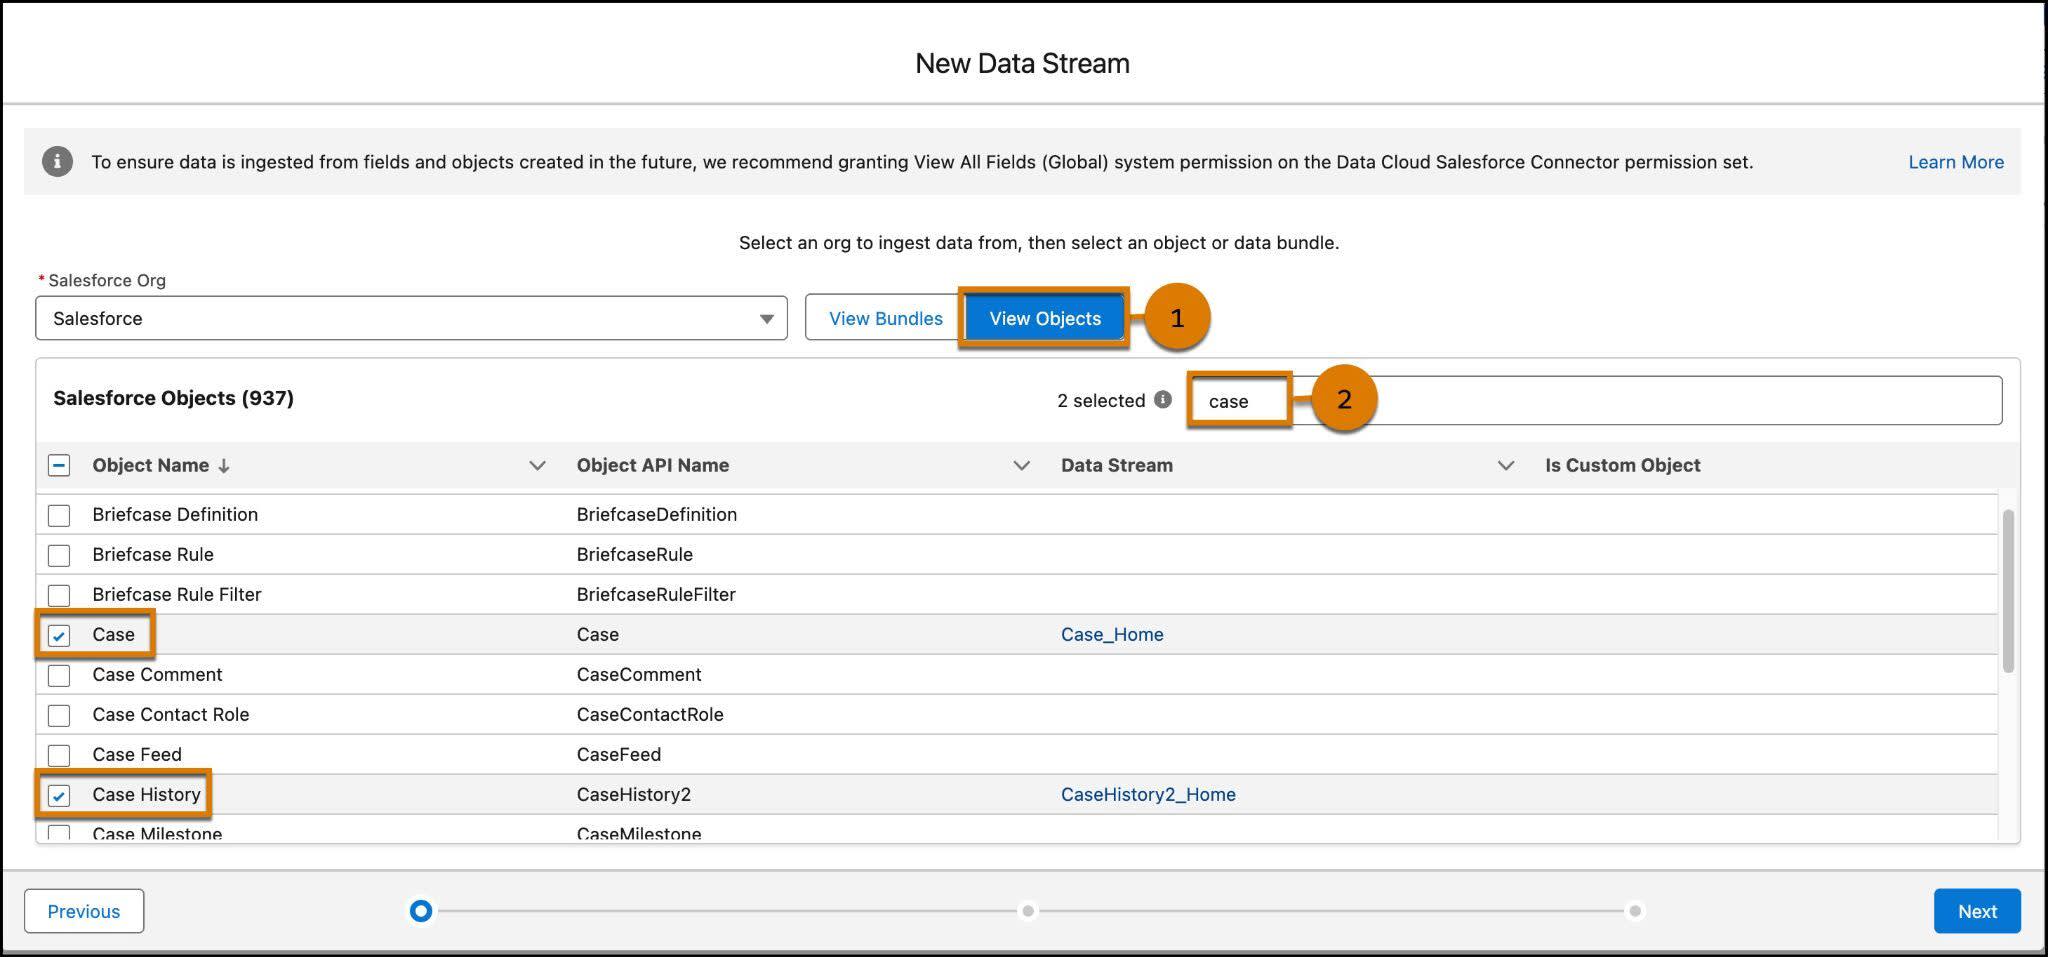
- 选择 View Objects,搜索
Case; - 同时选中 Case 和 Case History,点击 Next;
- 对以 Case 开头的对象,保持名称不变(Case_Home),从 Object Category 下拉框选择 Engagement;
- 然后从 Event Time Field 下拉框选择 Created Date;
- 点击 CaseHistory2,保持名称不变(CaseHistory2_Home),Object Category 选择 Other;
- 点击 Next;
- 确认默认数据空间已选中,点击 Deploy。
创建查询工作区
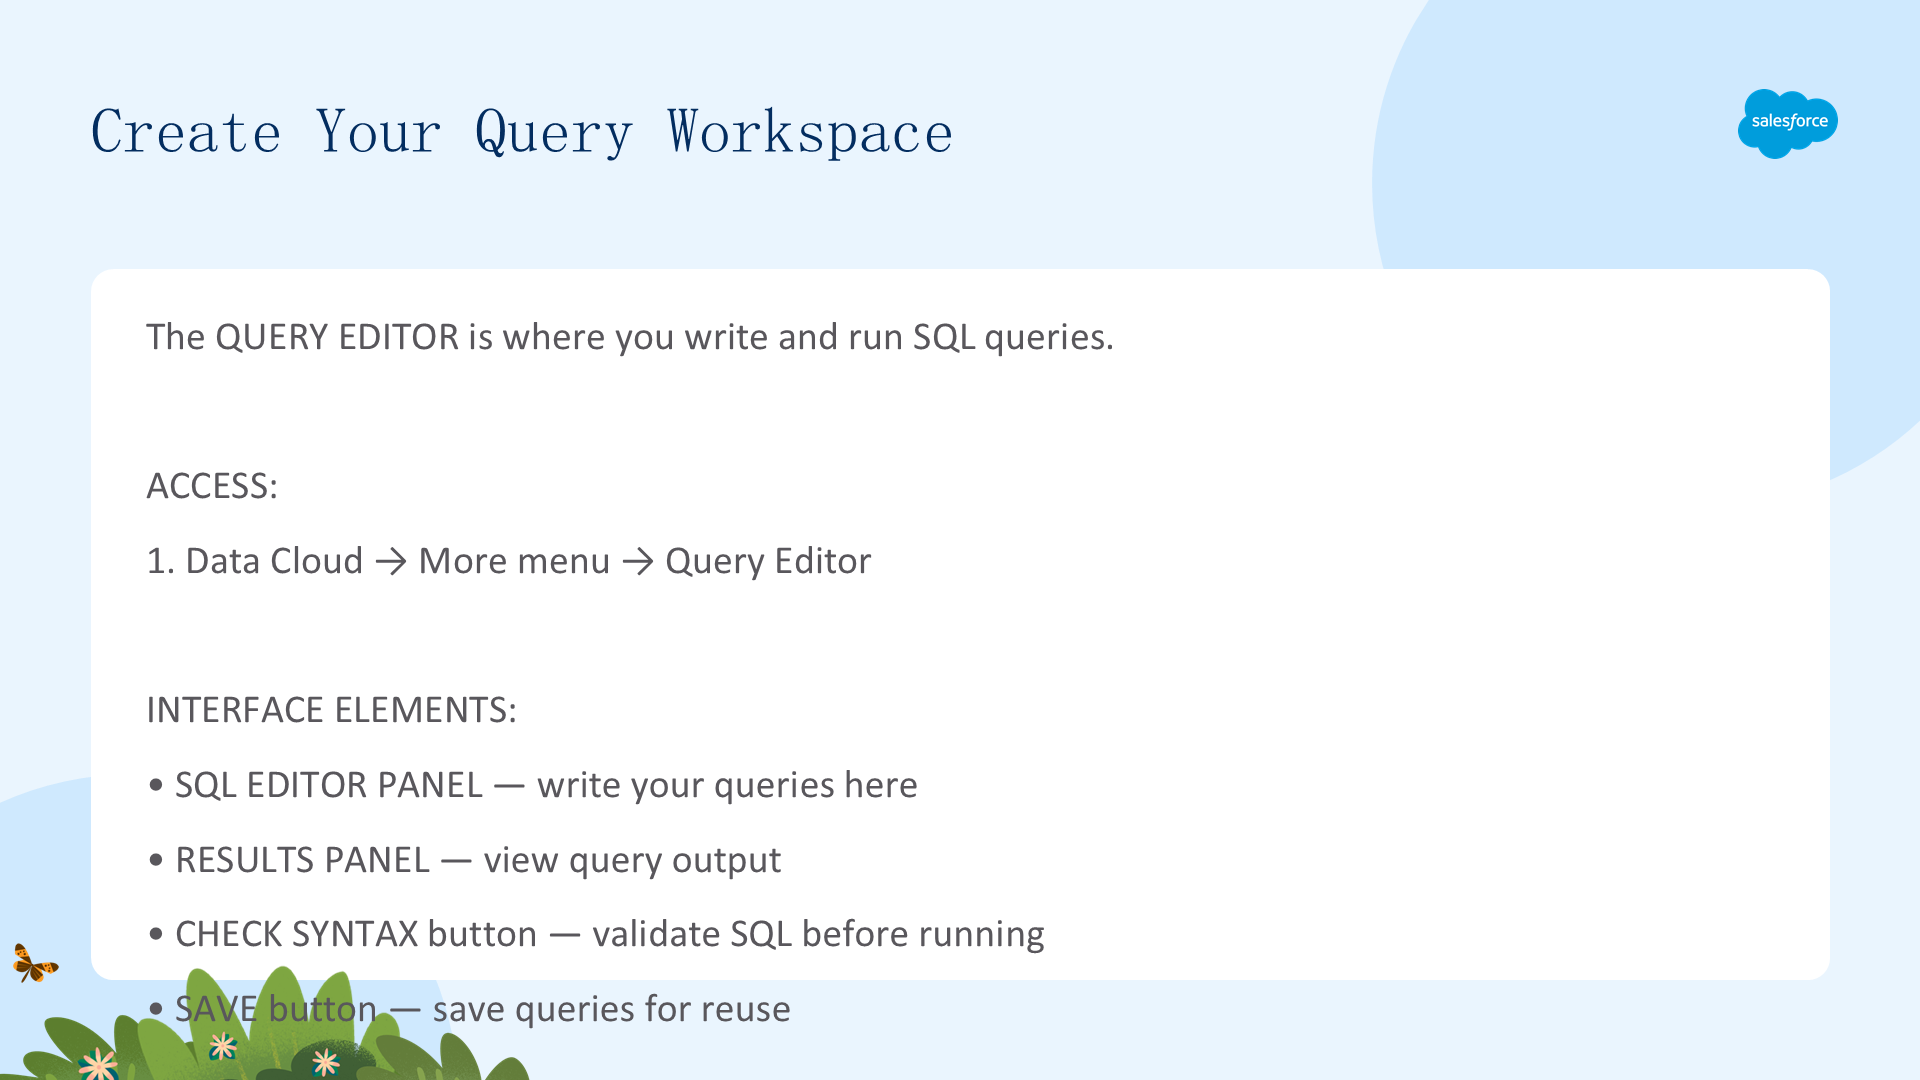
设置分析环境:
- 在 Data Cloud 中进入 Query Editor 标签页,点击 New;
- Workspace Name 输入
Customer Data Quality; - 保持 Data Space 为 Default;
- 点击 Save。
创建此工作区后,您的查询将在正确的安全与访问协议内运行,并且能找到正确的对象进行分析。
编写您的第一个查询
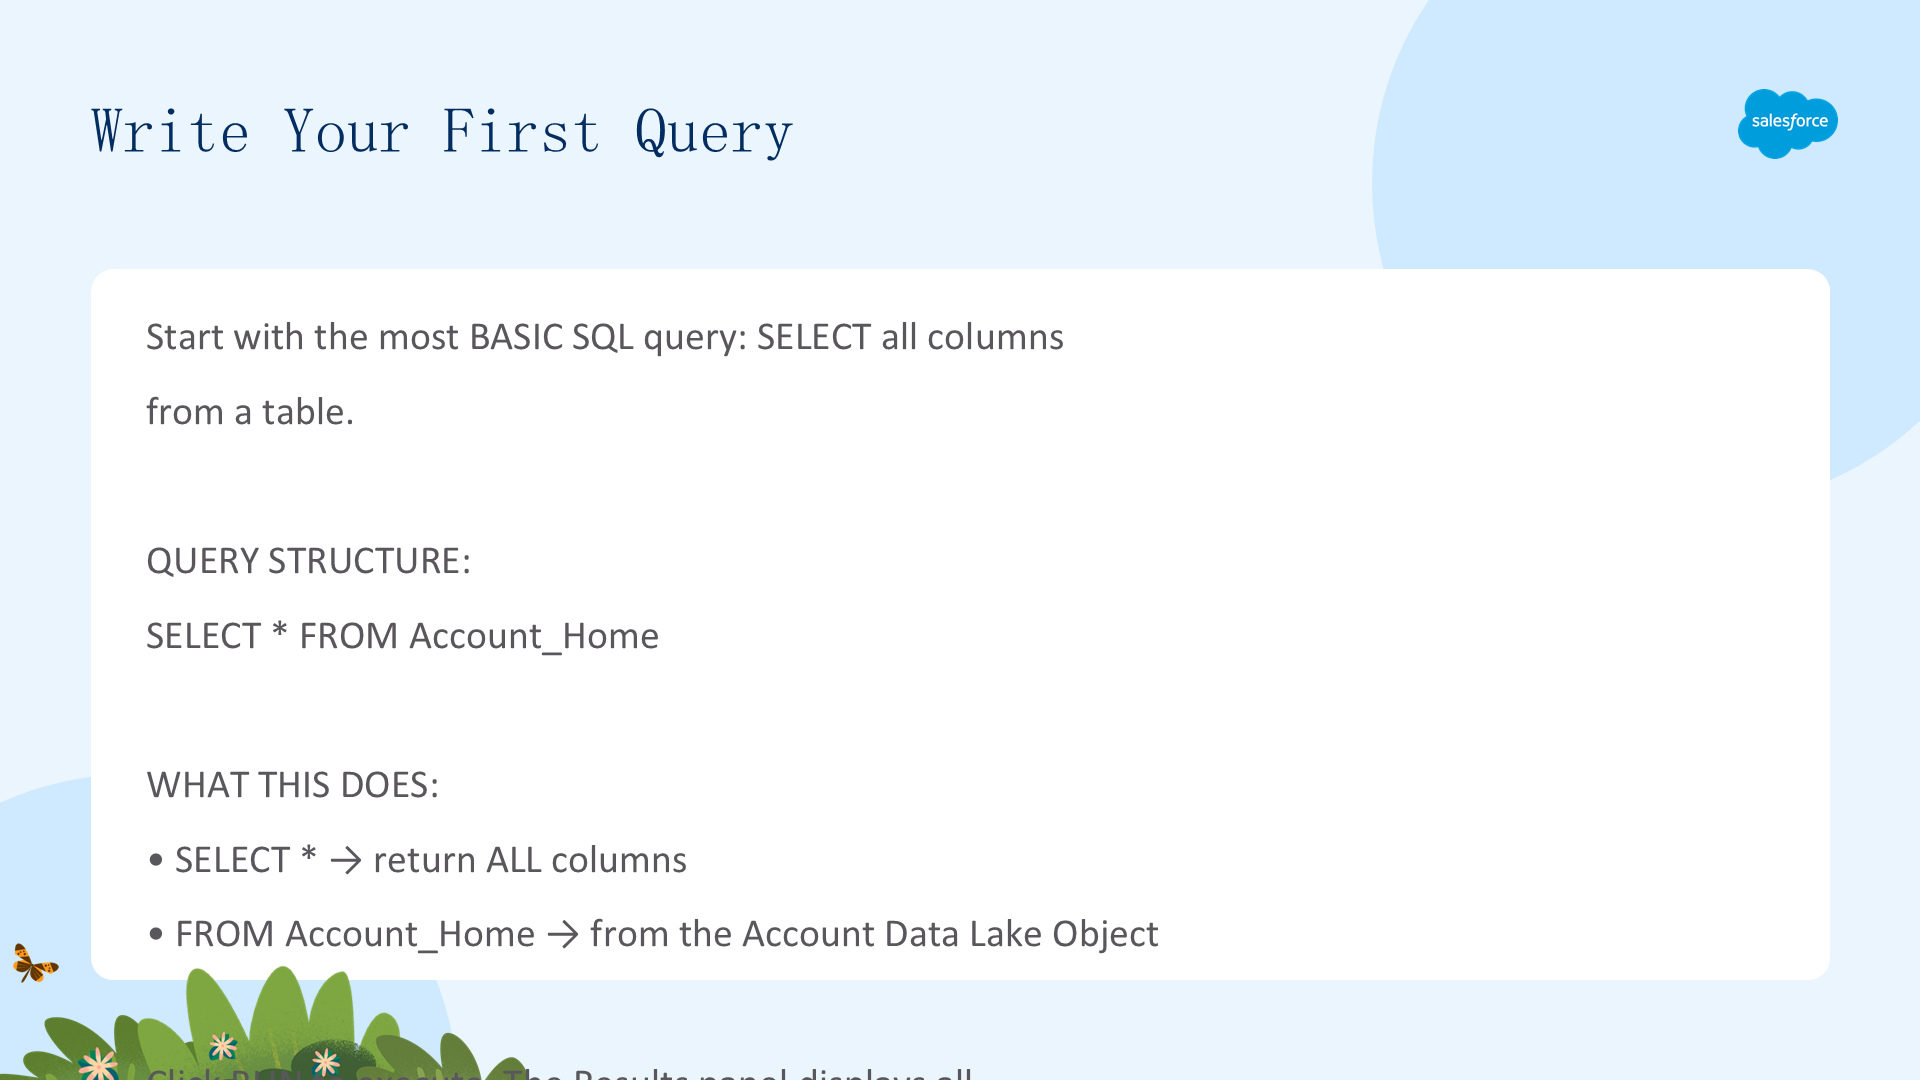
每一次数据之旅都始于提出问题。在 Data 360 SQL 中,您通过编写查询(query)来提问。一个基本查询有两个必需的子句:SELECT 和 FROM。
- SELECT 子句指定要检索哪些列(字段);
- FROM 子句指定数据来源,始终是一个数据模型对象(DMO)、数据湖对象(DLO)或计算洞察对象(CIO)。
您可以在 SELECT 子句中使用星号(*)通配符来检索 DMO 的每个字段,快速列出 Data 360 中的所有记录。虽然 SELECT * 写起来很快,但很少是最佳实践——它可能返回海量数据并拖慢查询。
选择特定字段
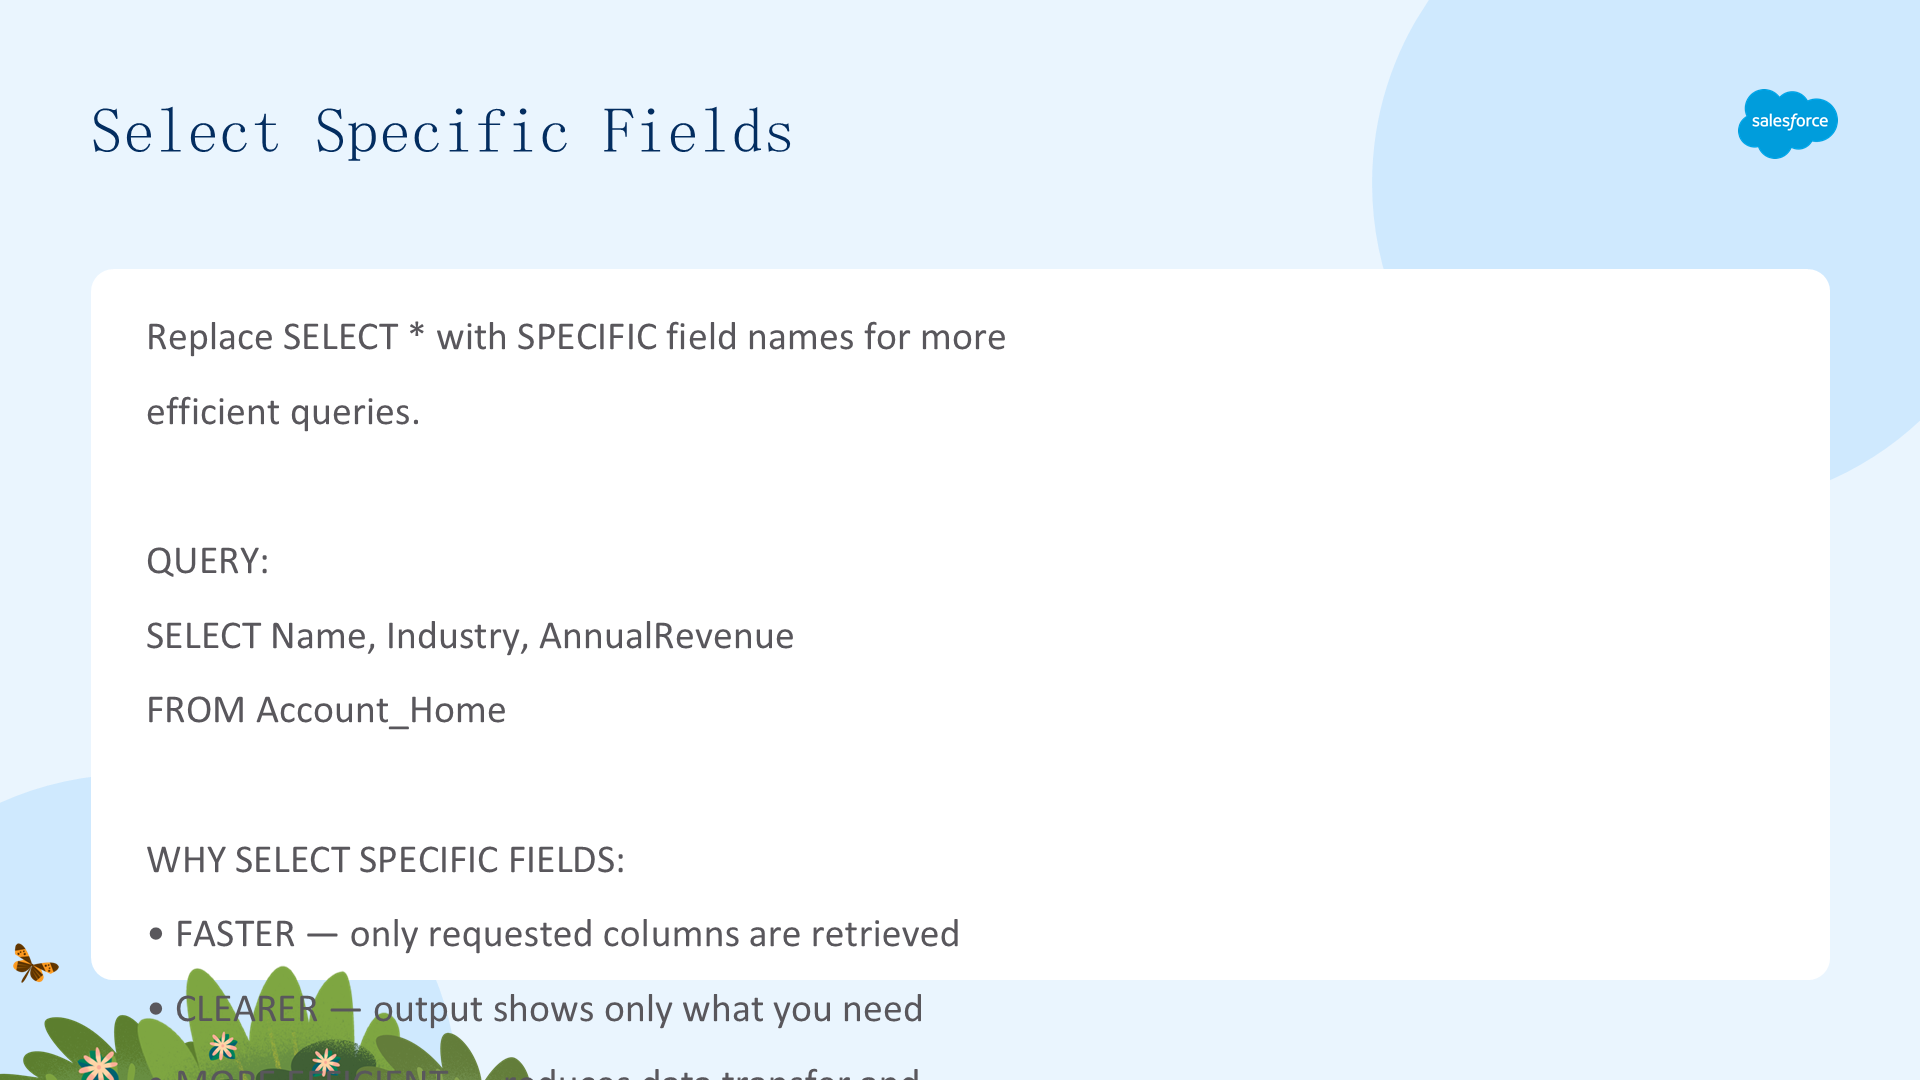
更高效的做法是只列出您需要的特定字段。这让查询运行更快,返回的结果集也更聚焦于分析所需的数据。
{sql('SELECT Name, Industry, AnnualRevenue FROM Account_Home')}用逗号分隔字段名。字段名区分大小写,必须与 DLO schema 完全一致。例如,对于一份初始报告,您可能只需要名字和 ID。
理解关键限定符字段(KQ_Id__c)
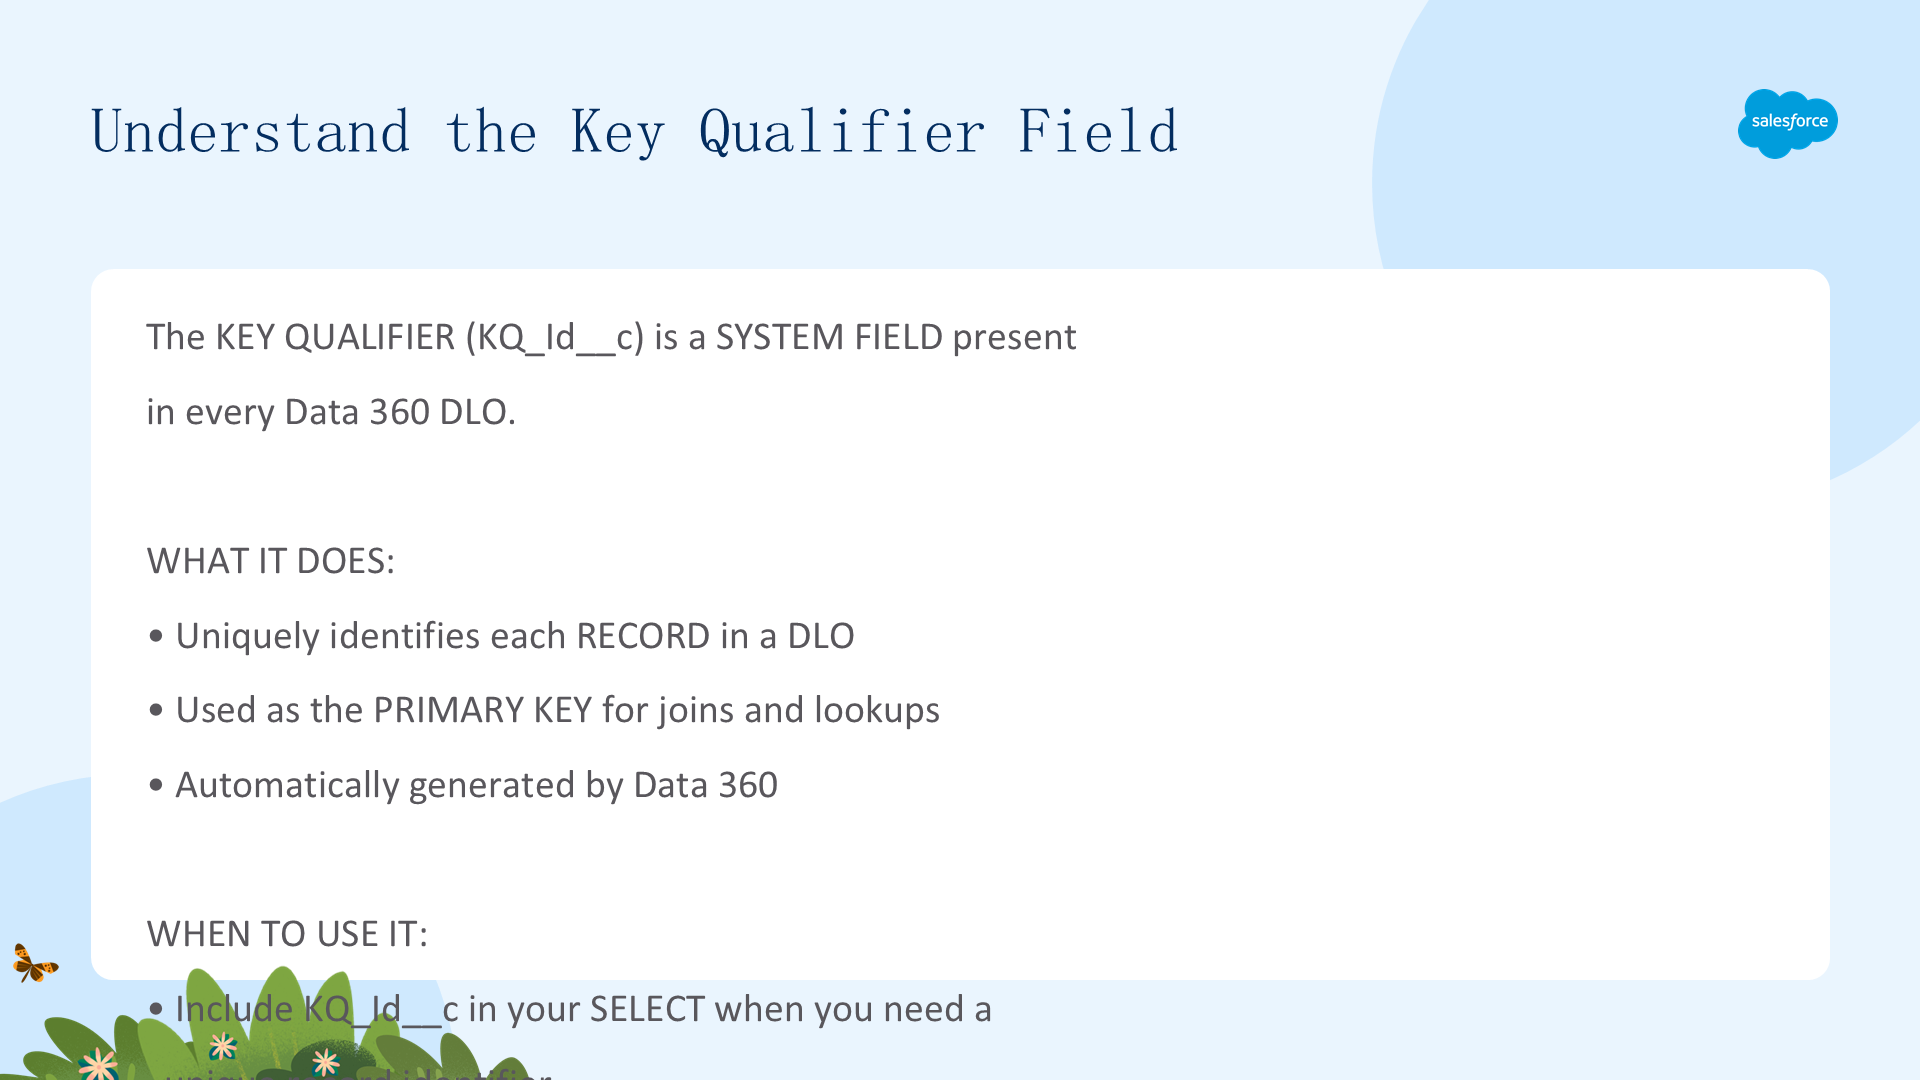
处理 Data 360 记录时,您会经常看到一个名为 KQ_Id__c(key qualifier ID,关键限定符 ID)的字段。理解这个字段对保证后续联接(join)数据时的准确性至关重要。
KQ_Id__c 是一个内部标识符,帮助追踪 Data 360 系统中记录的来源和唯一性:
- DMO 中的每条记录都有一个主 ID(如
ssot__Id__c)与 KQ_Id__c 的唯一组合; - 该标识符常用于在合并多个对象的数据时,确保正确关联到您打算使用的那条特定版本的记录。
最简单的记忆方式:主 ID 标识个体实体,而 KQ_Id__c 帮助您识别该实体对应的具体来源记录。
添加注释作为最佳实践
随着查询变复杂(尤其是团队协作时),可读性至关重要。您可以在 SQL 语句中添加注释来解释逻辑、注明假设或暂时禁用部分代码。注释在执行查询时会被忽略。
有两种注释:
- 单行注释:在行首(或注释掉一行的其余部分)使用两个连字符
--; - 多行注释:用
/*和*/包裹跨多行的注释。
编写并运行查询
在 Customer Data Quality 工作区中执行 SQL 语句:
- 在主编辑器窗口粘贴查询以查看单条记录;
- 点击编辑器左上角的 Run Query;
- 在屏幕底部的 Query Result 面板查看结果。
工作流程是迭代式的:编写 → 检查语法 → 运行 → 查看 → 修改。从简单开始,逐步增加复杂度。
保存查询
确认结果正确后,点击工作区右上角的 Save 按钮。保存的查询会出现在 Saved Queries 列表中,可以随时重跑、编辑以修改条件、与其他 Data 360 用户共享,或作为计算洞察的基础。
给查询起一个描述性的名称(如 High_Value_Accounts_By_Industry),并添加可选说明。为常见分析模式构建一个保存查询的库,可以大幅提升效率。
二、过滤、排序和限制查询结果
用 WHERE 过滤查询结果
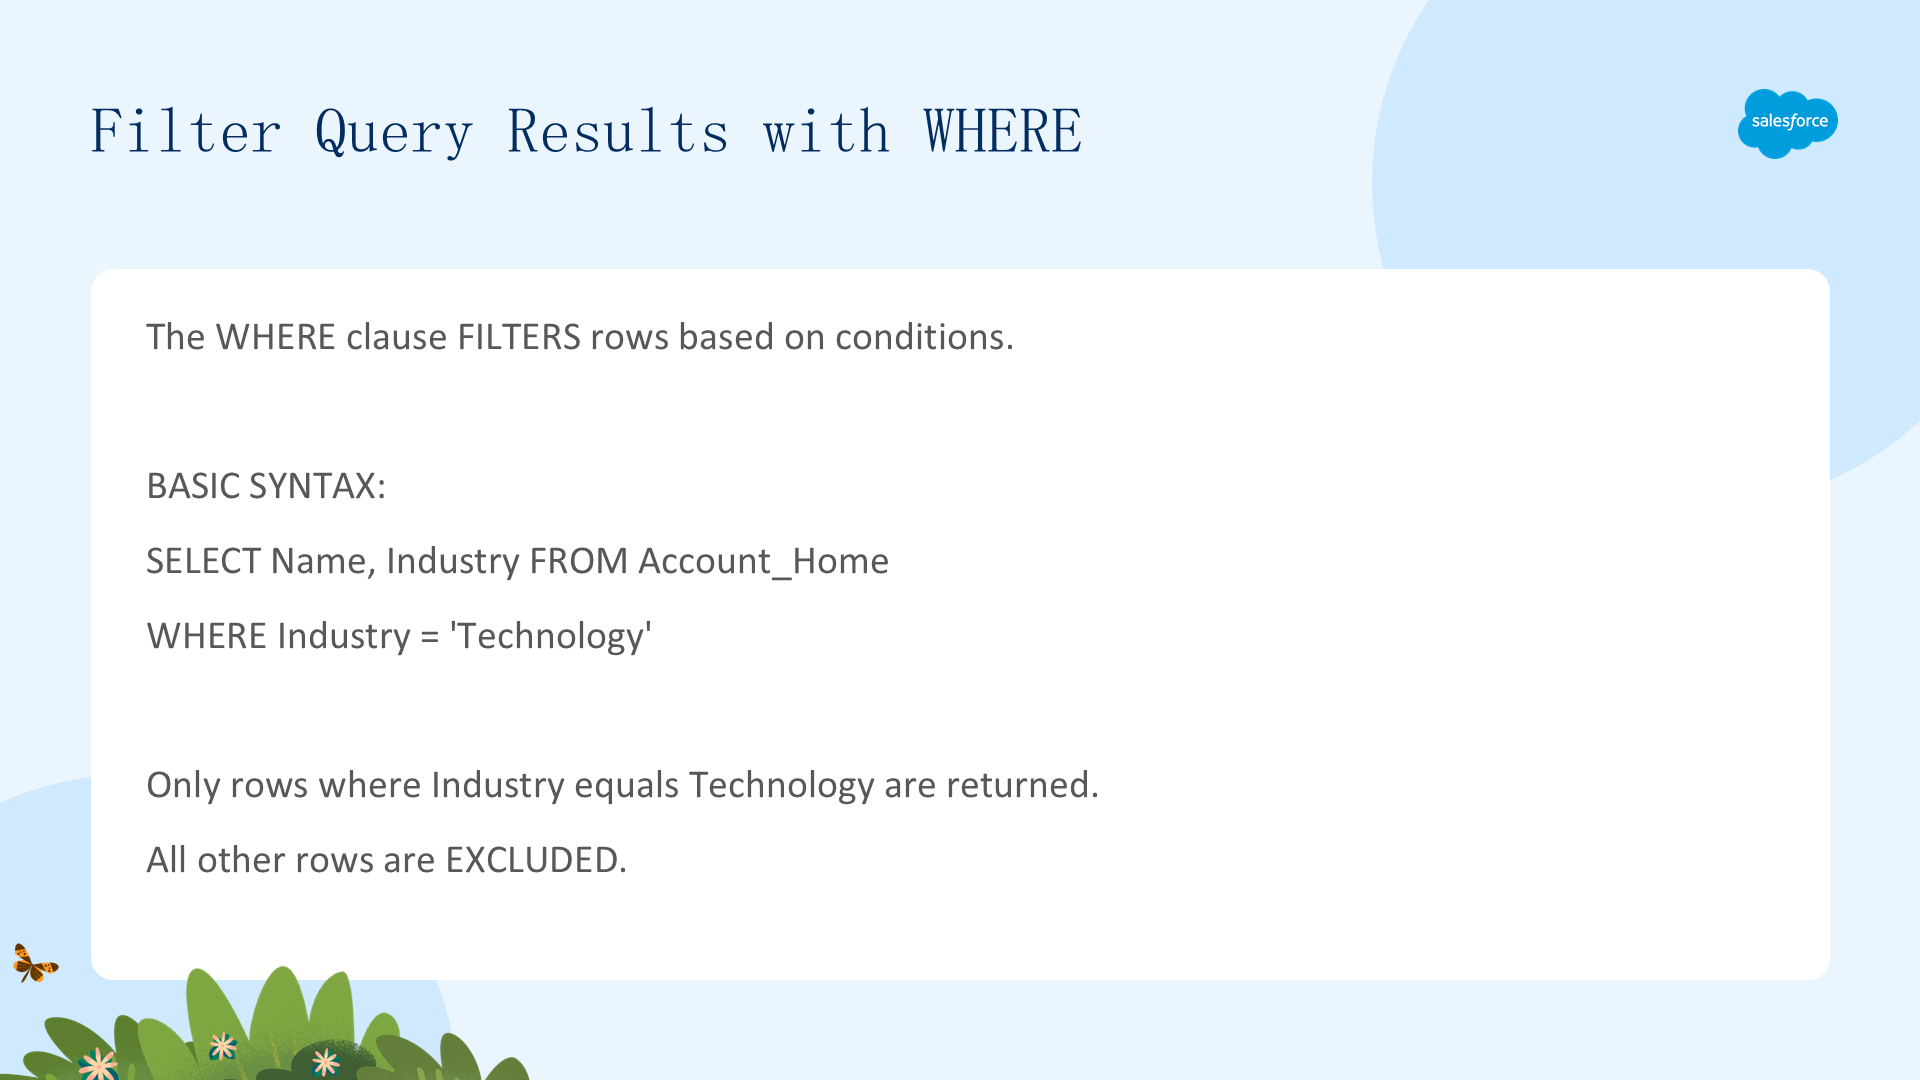
在上一单元中,您学会了用 SELECT 和 FROM 编写简单查询。把分析聚焦到特定的数据子集,可以限制结果、锁定有用的部分。为此,使用 WHERE 子句来过滤结果。
WHERE 子句总是位于 FROM 子句之后,用于指定记录要被纳入最终结果集所必须满足的条件。
{sql("SELECT Name, Industry FROM Account_Home WHERE Industry = 'Technology'")}使用比较和逻辑运算符
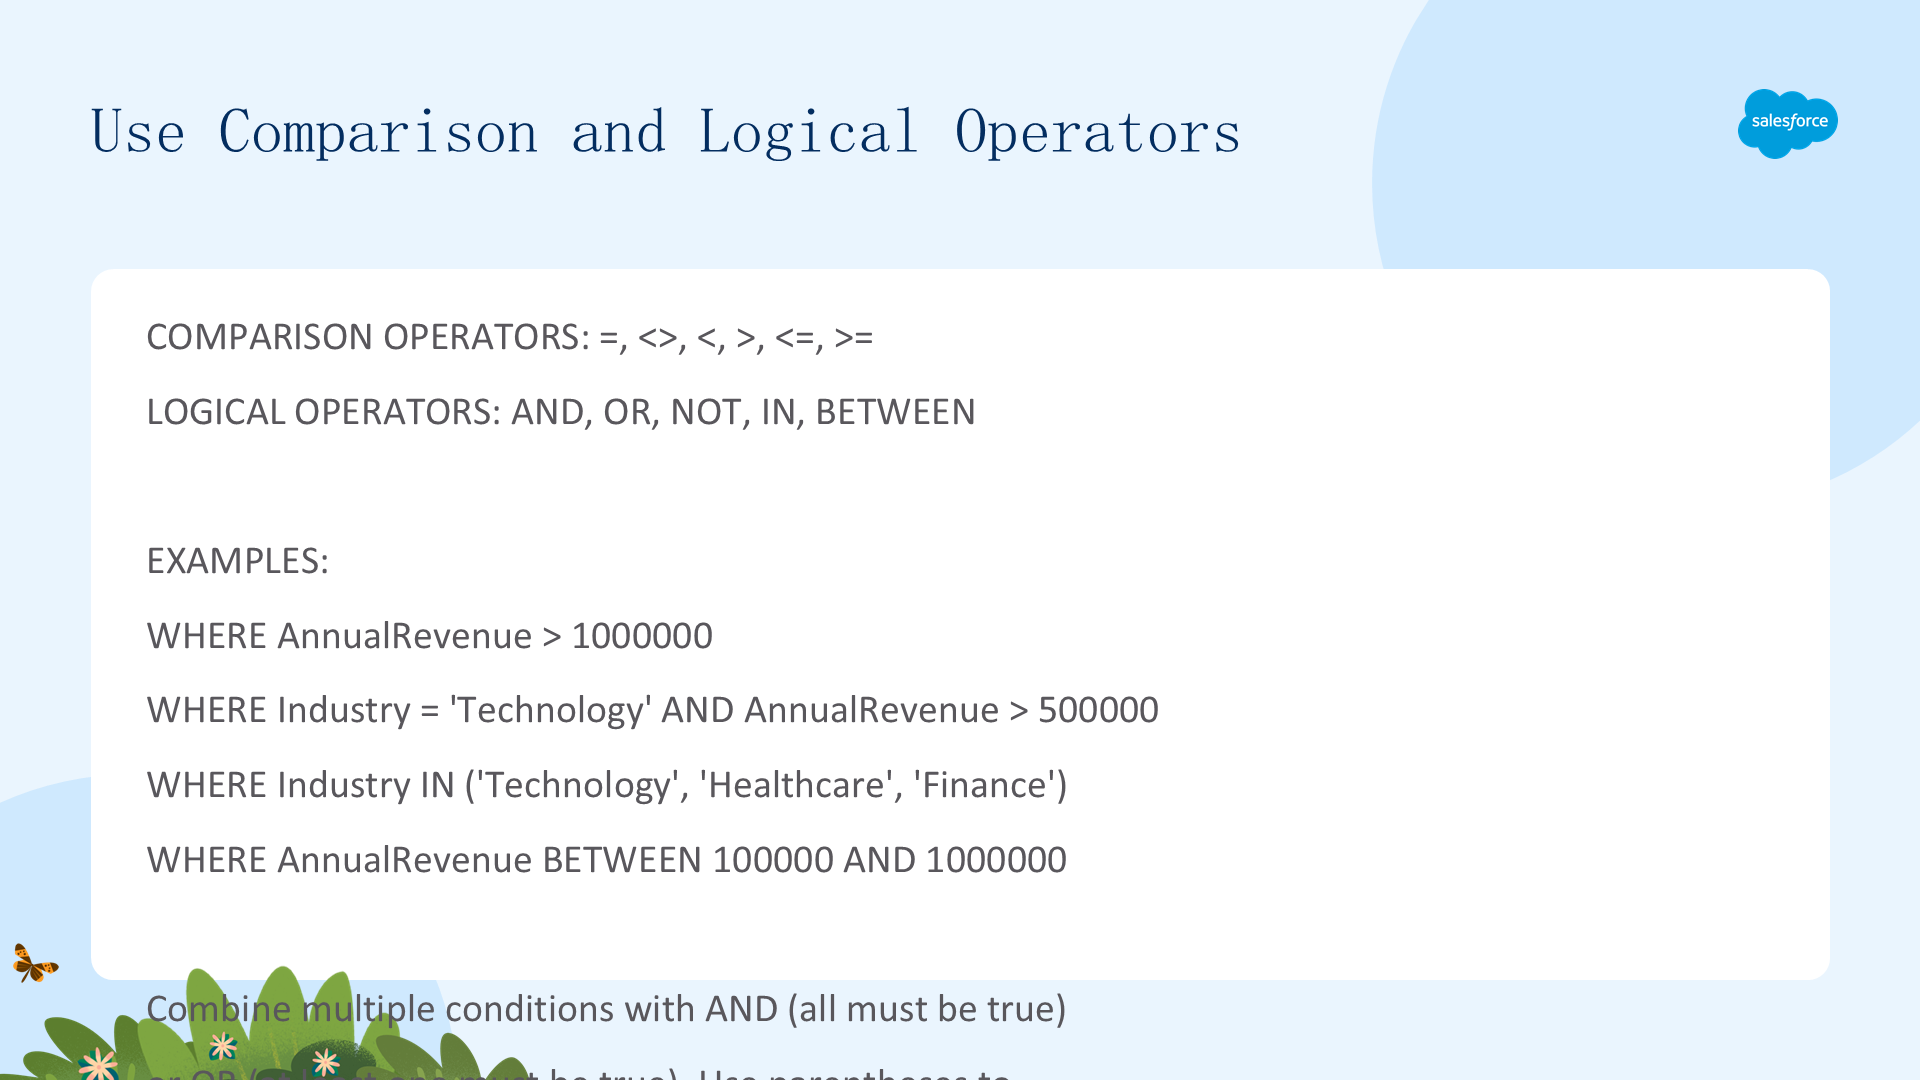
您可以使用标准比较运算符(如 =、>、<、!=)和逻辑运算符(AND、OR)来定义条件。
>是比较运算符;AND是逻辑运算符,要求两个条件都为真;IS NULL专门用于检查字段为空或未定义的记录,IS NOT NULL则排除值缺失的记录;OR运算符在任一条件满足时返回记录;- 可用括号
()分组复杂条件以提升清晰度。
用 LIKE 搜索模式
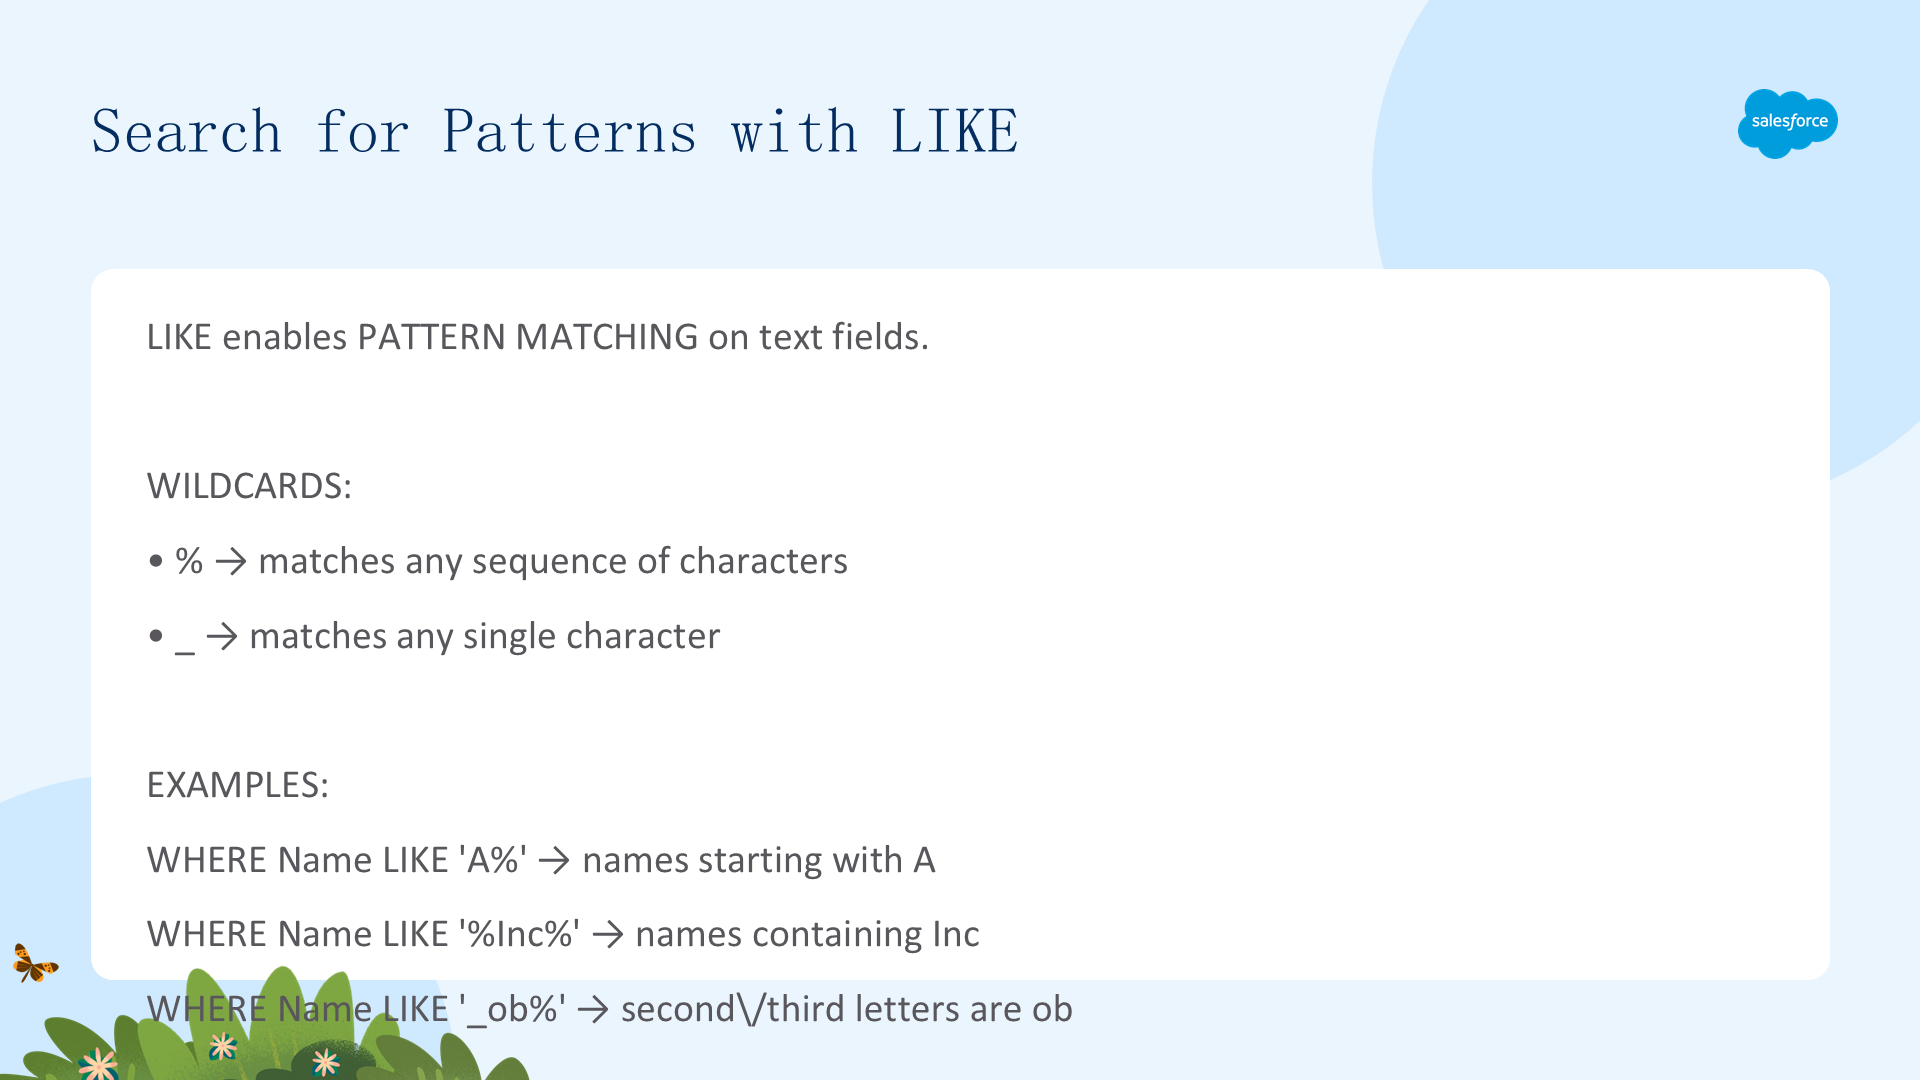
有时您不知道要查找的确切值,或想匹配一组相关的文本值(字符串)。LIKE 运算符用于对文本字段做模式匹配。
LIKE 与通配符配合使用:
- 百分号 %:匹配任意长度(含零个)的字符序列;
- 下划线 _:匹配任意单个字符。
注意:Data 360 中的 LIKE 是区分大小写的。要做不区分大小写的匹配,可配合 UPPER() 或 LOWER() 函数使用。
排序和限制结果
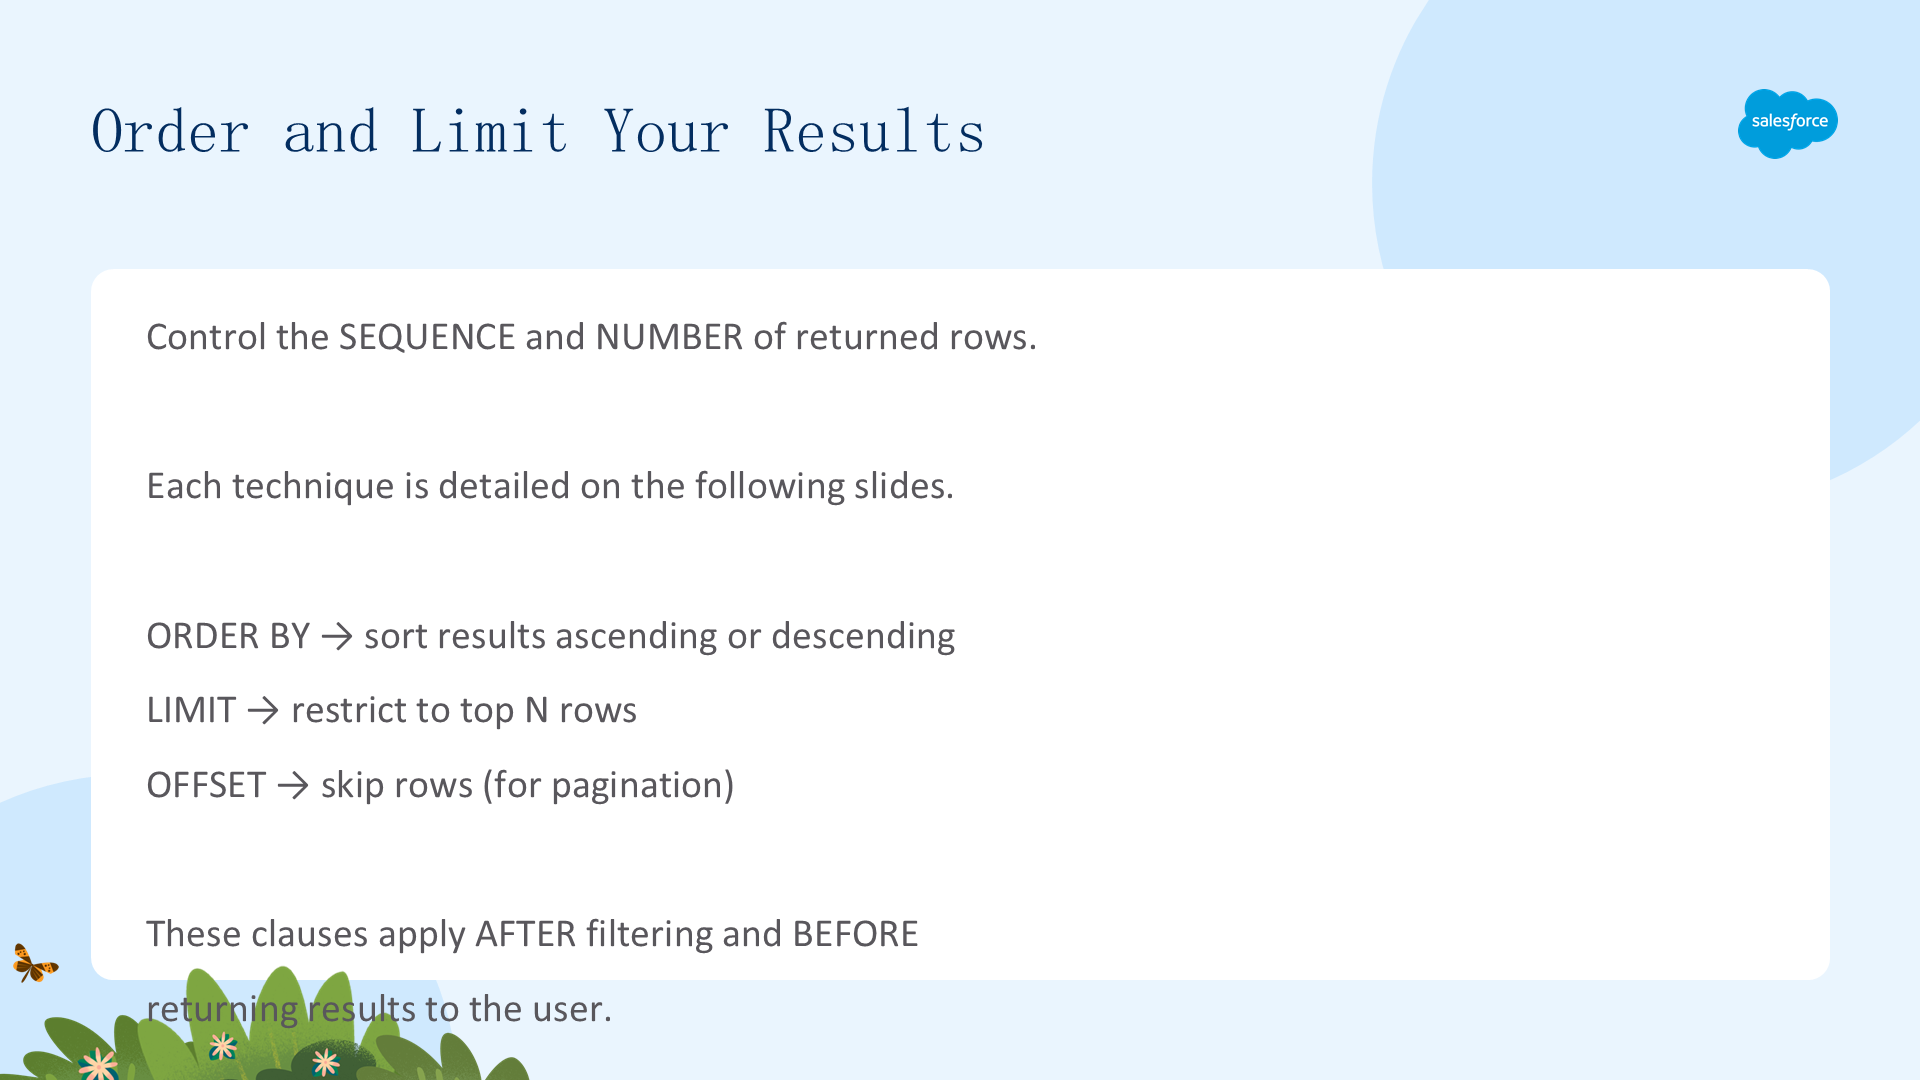
即使经过 WHERE 过滤,查询仍可能返回成千上万条记录。为了让结果便于查看并定位特定记录,使用 ORDER BY 和 LIMIT 子句。
- ORDER BY → 按升序或降序排序结果;
- LIMIT → 限制为前 N 行;
- OFFSET → 跳过行(用于分页)。
这些子句在过滤之后、返回结果之前应用。
用 ORDER BY 排序数据
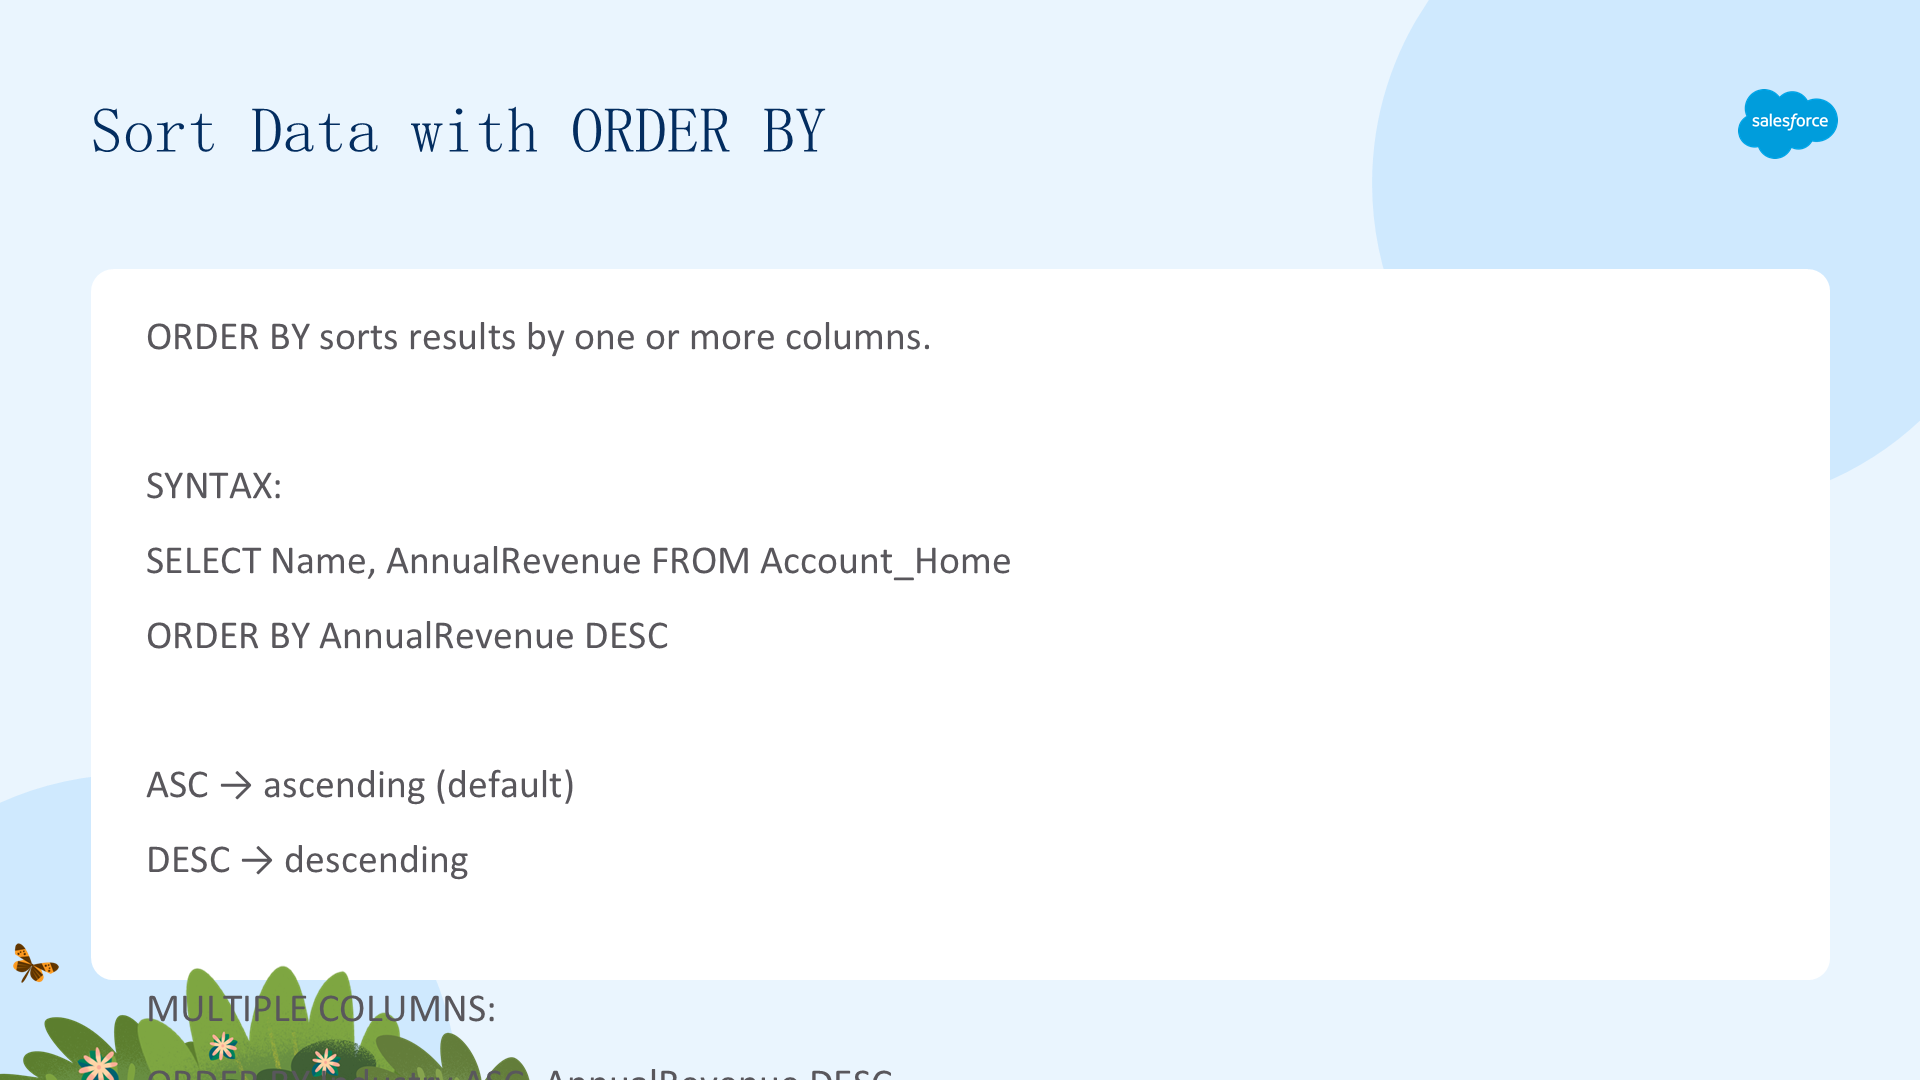
ORDER BY 子句按一个或多个指定字段对结果集排序。这一点很关键,因为没有它,结果的顺序可能不一致。
- 升序(A-Z、1-100):使用
ASC关键字(默认); - 降序(Z-A、100-1):使用
DESC关键字。
多列排序如 ORDER BY Industry ASC, AnnualRevenue DESC:先按行业字母顺序排序,再在每个行业内按收入从高到低排序。
用 LIMIT 和 OFFSET 控制行数
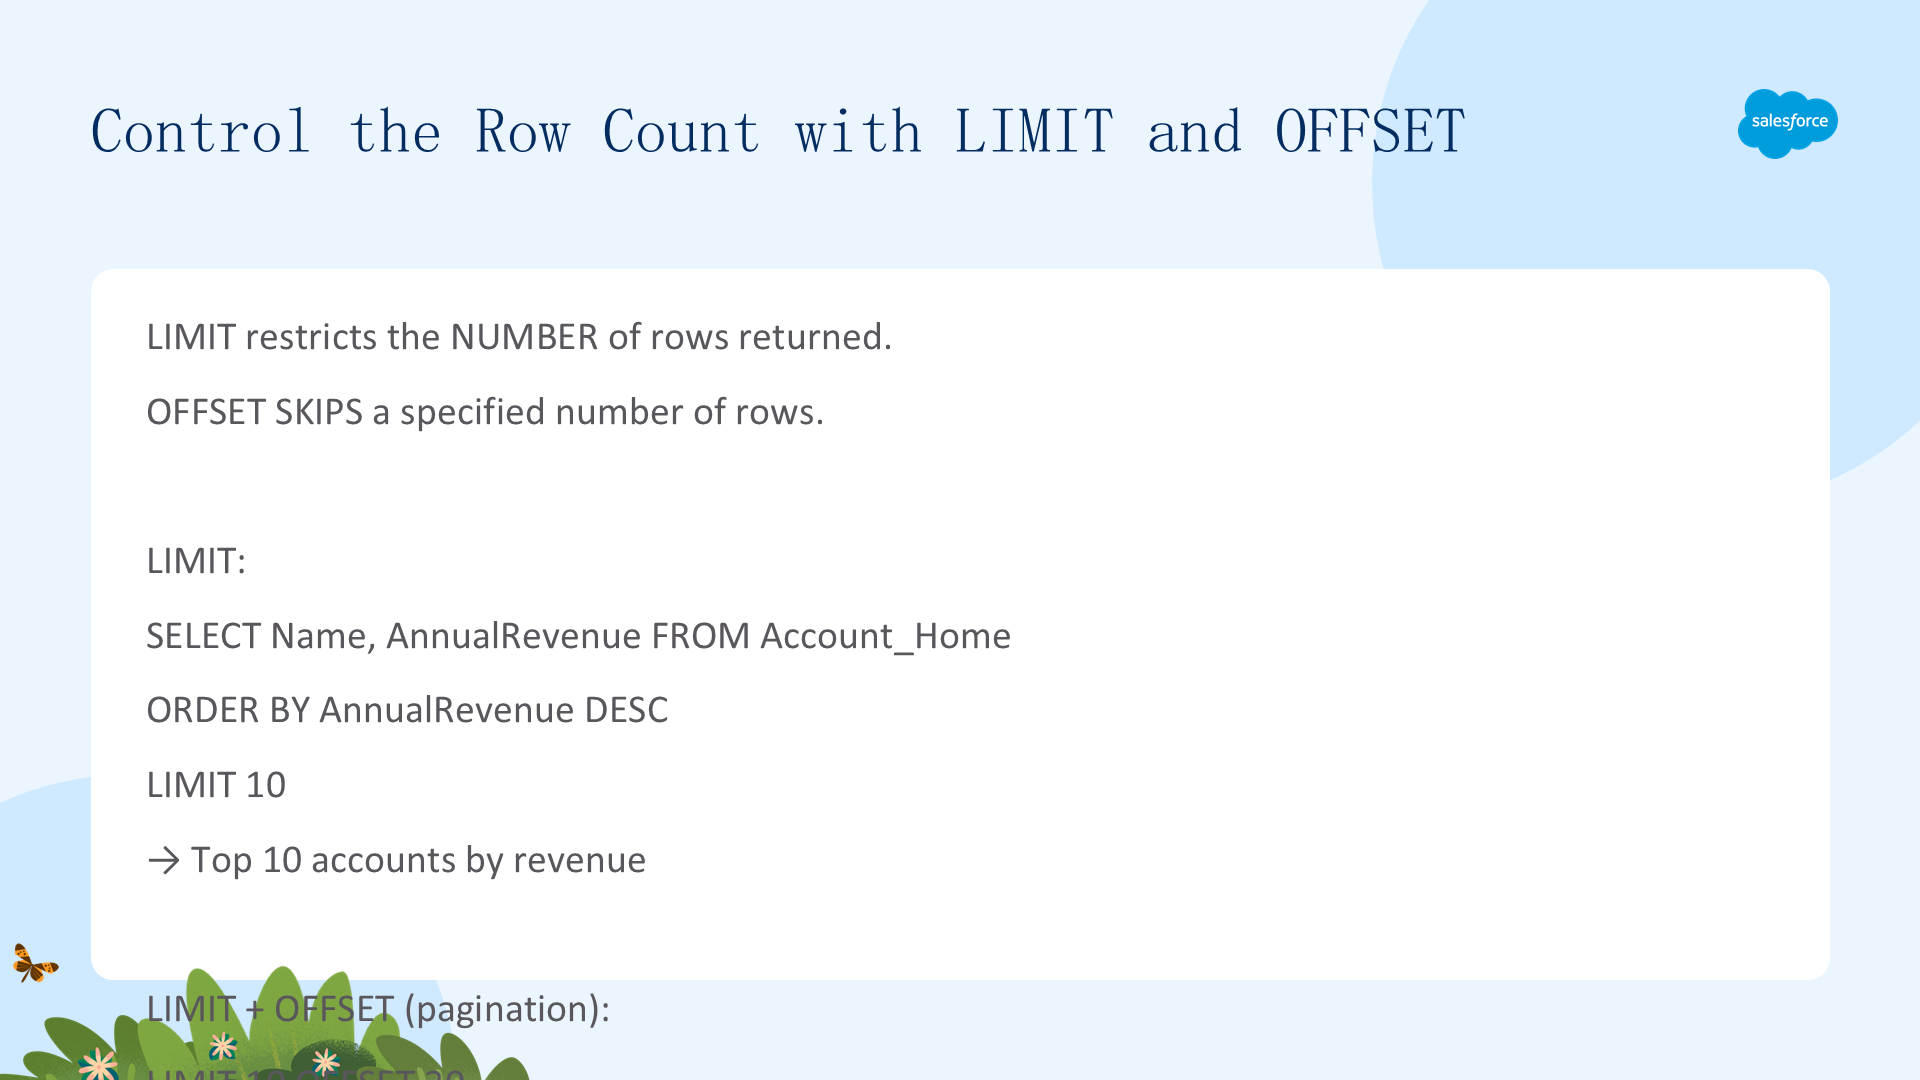
LIMIT 子句精确控制最终结果集返回多少行,最常与 ORDER BY 结合用于查找「前 N 条」记录(如最近 10 条记录或最低 5 个价格)。
OFFSET 子句与 LIMIT 配合使用,在开始返回结果集之前跳过指定数量的行。例如,要获取第 2 页的 20 条结果,就跳过前 20 条:LIMIT 20 OFFSET 20。
LIMIT 在查询管线中最后执行——在 WHERE、GROUP BY 和 ORDER BY 之后,因此返回的是所有过滤和排序完成后真正的前 N 条。
三、聚合数据获取高层洞察
为商业智能汇总数据
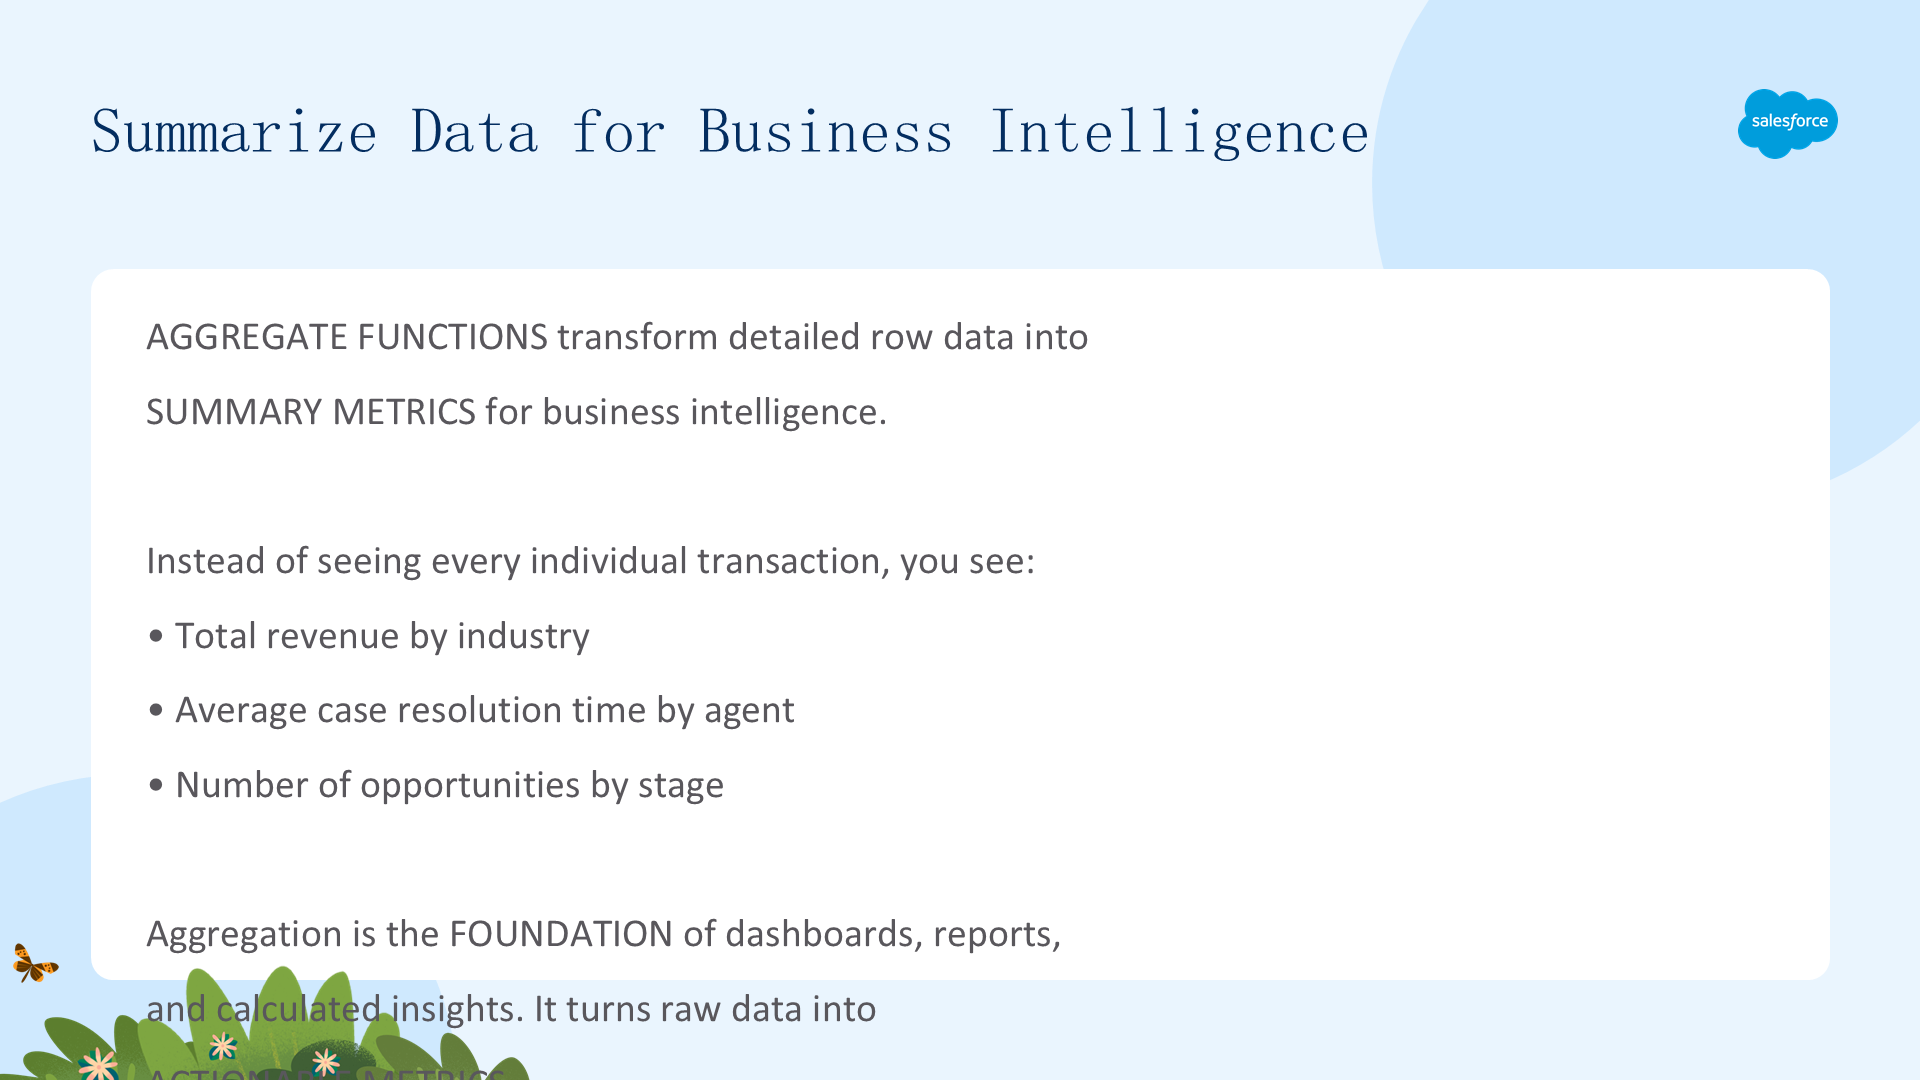
掌握了选择与过滤的基础后,关键的下一步是把原始数据变成高层指标和业务洞察。原始数据即使经过过滤也可能让人不知所措。Data 360 SQL 的聚合函数允许您从一组值计算出一个结果,例如总购买量、平均年龄或客户数量。
这些技术对于生成报表、理解宏观趋势和向利益相关者呈现业务洞察至关重要。聚合是仪表板、报表和计算洞察的基础——它把原始数据变成可操作的指标。
使用聚合函数
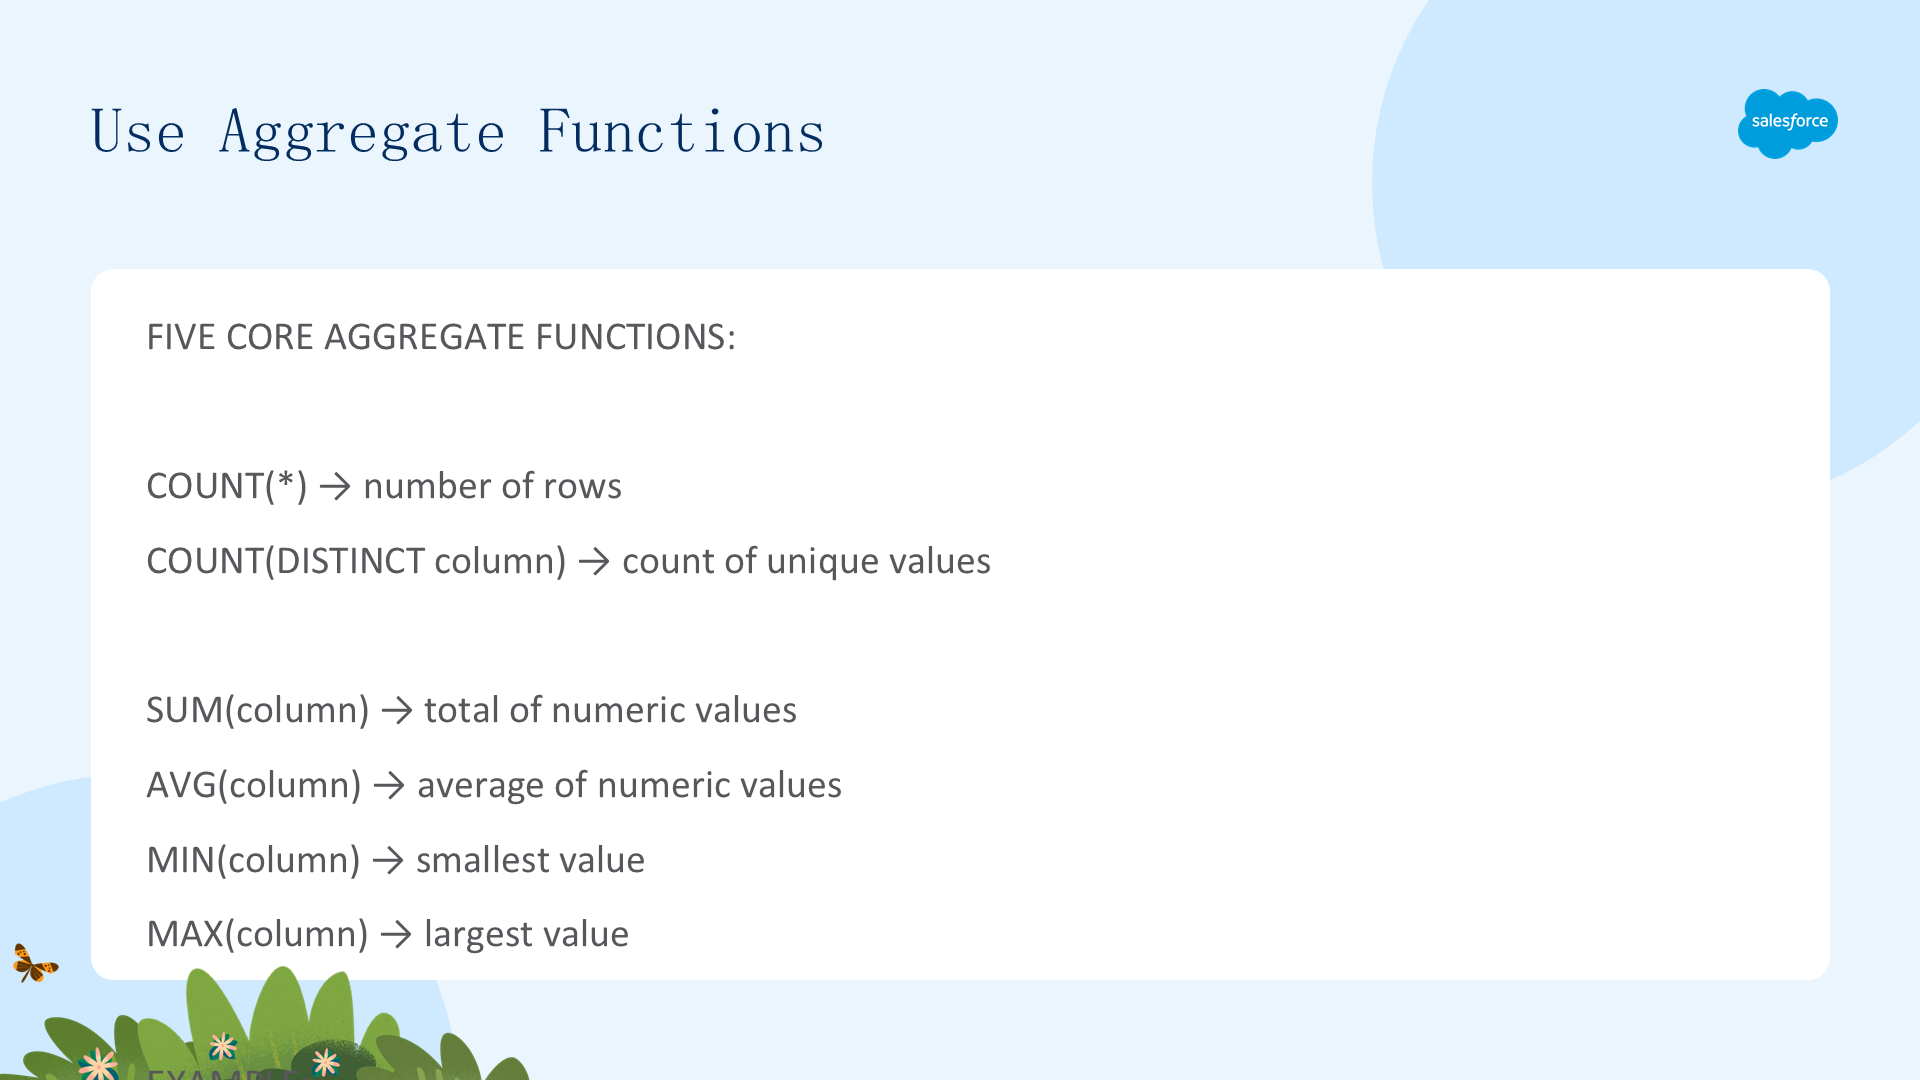
聚合函数对一组行执行计算并返回一个汇总值,通常放在 SELECT 子句中。最常用的函数:
- COUNT(*):返回输入行的数量;
- SUM(expression):返回所有输入值之和;
- AVG(expression):返回所有输入值的平均值(算术平均);
- MIN(expression):返回输入值集中的最小值;
- MAX(expression):返回输入值集中的最大值。
用 AS 给聚合结果起有意义的别名。除 COUNT(*) 外,所有聚合函数都会忽略 NULL。
用 GROUP BY 分组结果
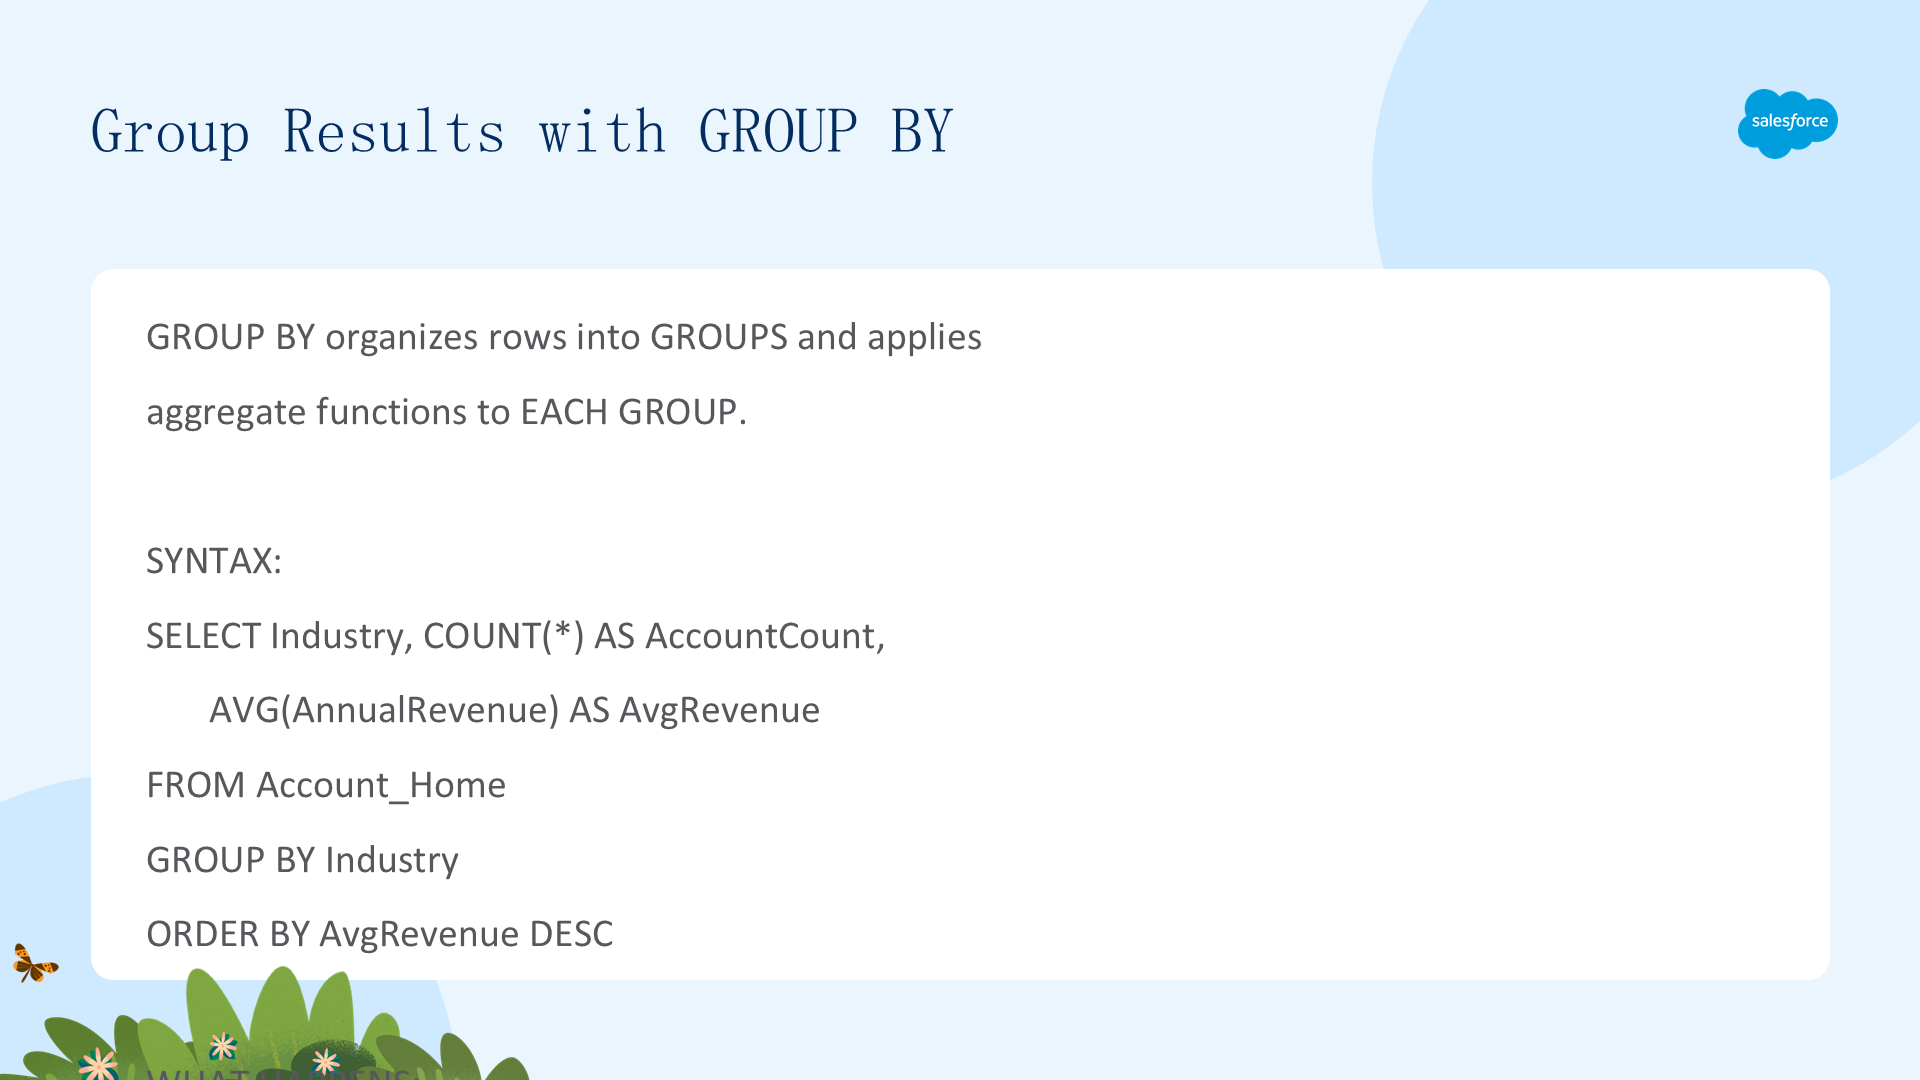
单个聚合值(如总收入)很有用,但分析通常需要按类别(或分组)拆分这些指标。要对每个唯一分组执行计算,使用 GROUP BY 子句。
- 在 SELECT 列表中包含要分组的类别字段;
- 在 GROUP BY 子句中包含同样的类别字段。
规则:SELECT 子句中任何未聚合的字段都必须出现在 GROUP BY 子句中。GROUP BY 把「所有账户」变成「按行业的账户」——这是最常见的商业智能模式。
用 HAVING 过滤分组
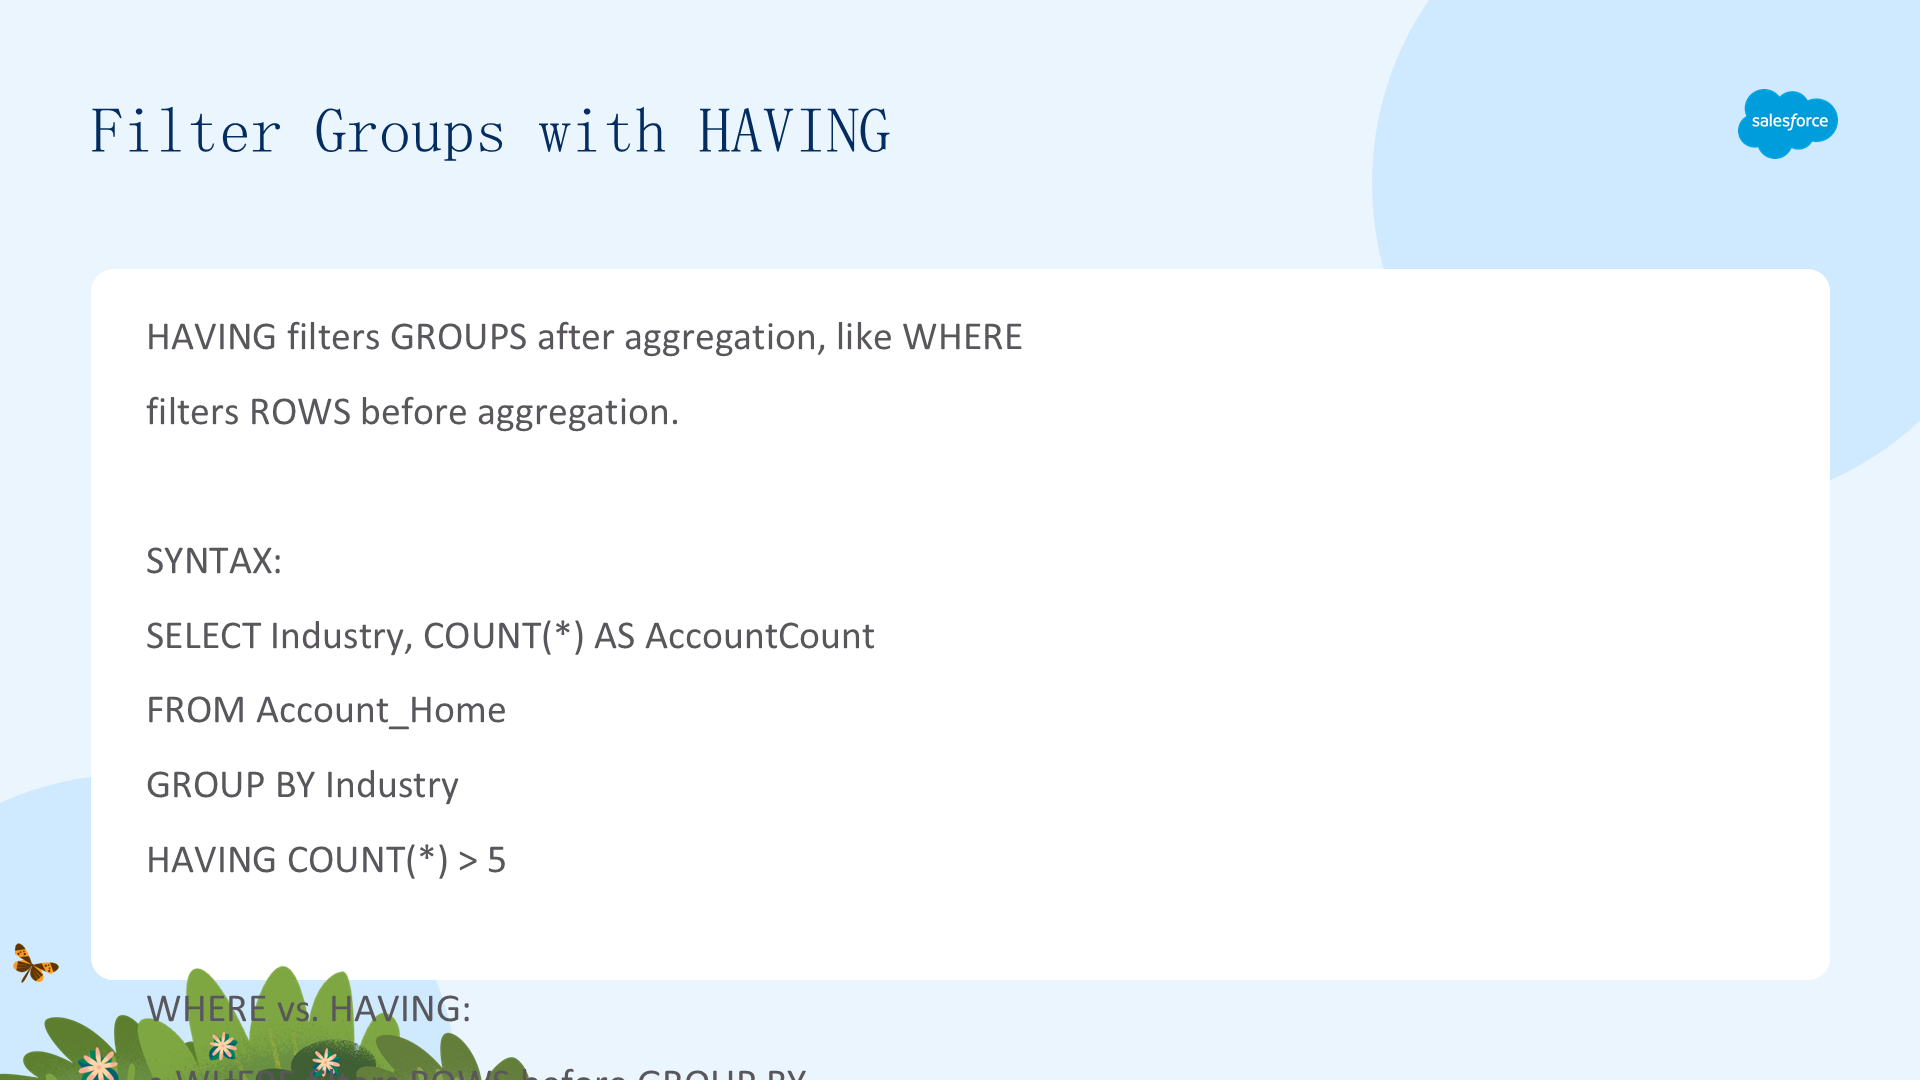
您已经知道 WHERE 子句在分组和聚合之前过滤单行。要对汇总结果——即分组本身——应用条件,使用 HAVING 子句。
HAVING 子句过滤聚合函数的输出,总是位于 GROUP BY 子句之后。
{sql("SELECT ssot__CountryId__c AS Country, AVG(TotalAmount) AS AvgOrderValue FROM ssot__SalesOrder_dlm GROUP BY ssot__CountryId__c HAVING AVG(TotalAmount) > 500")}WHERE 与 HAVING 的区别:WHERE 在 GROUP BY 之前过滤行,HAVING 在 GROUP BY 之后过滤分组。两者可以在同一个查询中一起使用——WHERE 处理行级条件,HAVING 处理分组级条件。
四、用联接合并多个对象的数据
探索联接的用途
到目前为止,您都只从单个 DMO 或 DLO 查询数据。但在 Data 360 中,客户信息天然地分布在多个对象中——例如客户的画像在 Individual DMO 中,而其邮箱地址在 ContactPointEmail DMO 中。
要创建客户的统一视图,就需要使用联接(join)。联接基于两者共享的相关字段,把两个或更多 DMO/DLO 的数据合并,从而把分散的信息(如个体姓名和对应邮箱地址)汇聚到一个结果集中。
- INNER JOIN → 只返回两表都有匹配值的行;
- LEFT OUTER JOIN → 左表所有行 + 右表匹配行;
- RIGHT OUTER JOIN → 右表所有行 + 左表匹配行;
- FULL OUTER JOIN → 两表所有行。
联接是现实世界数据分析中最强大也最常见的 SQL 操作。
内联接(INNER JOIN)
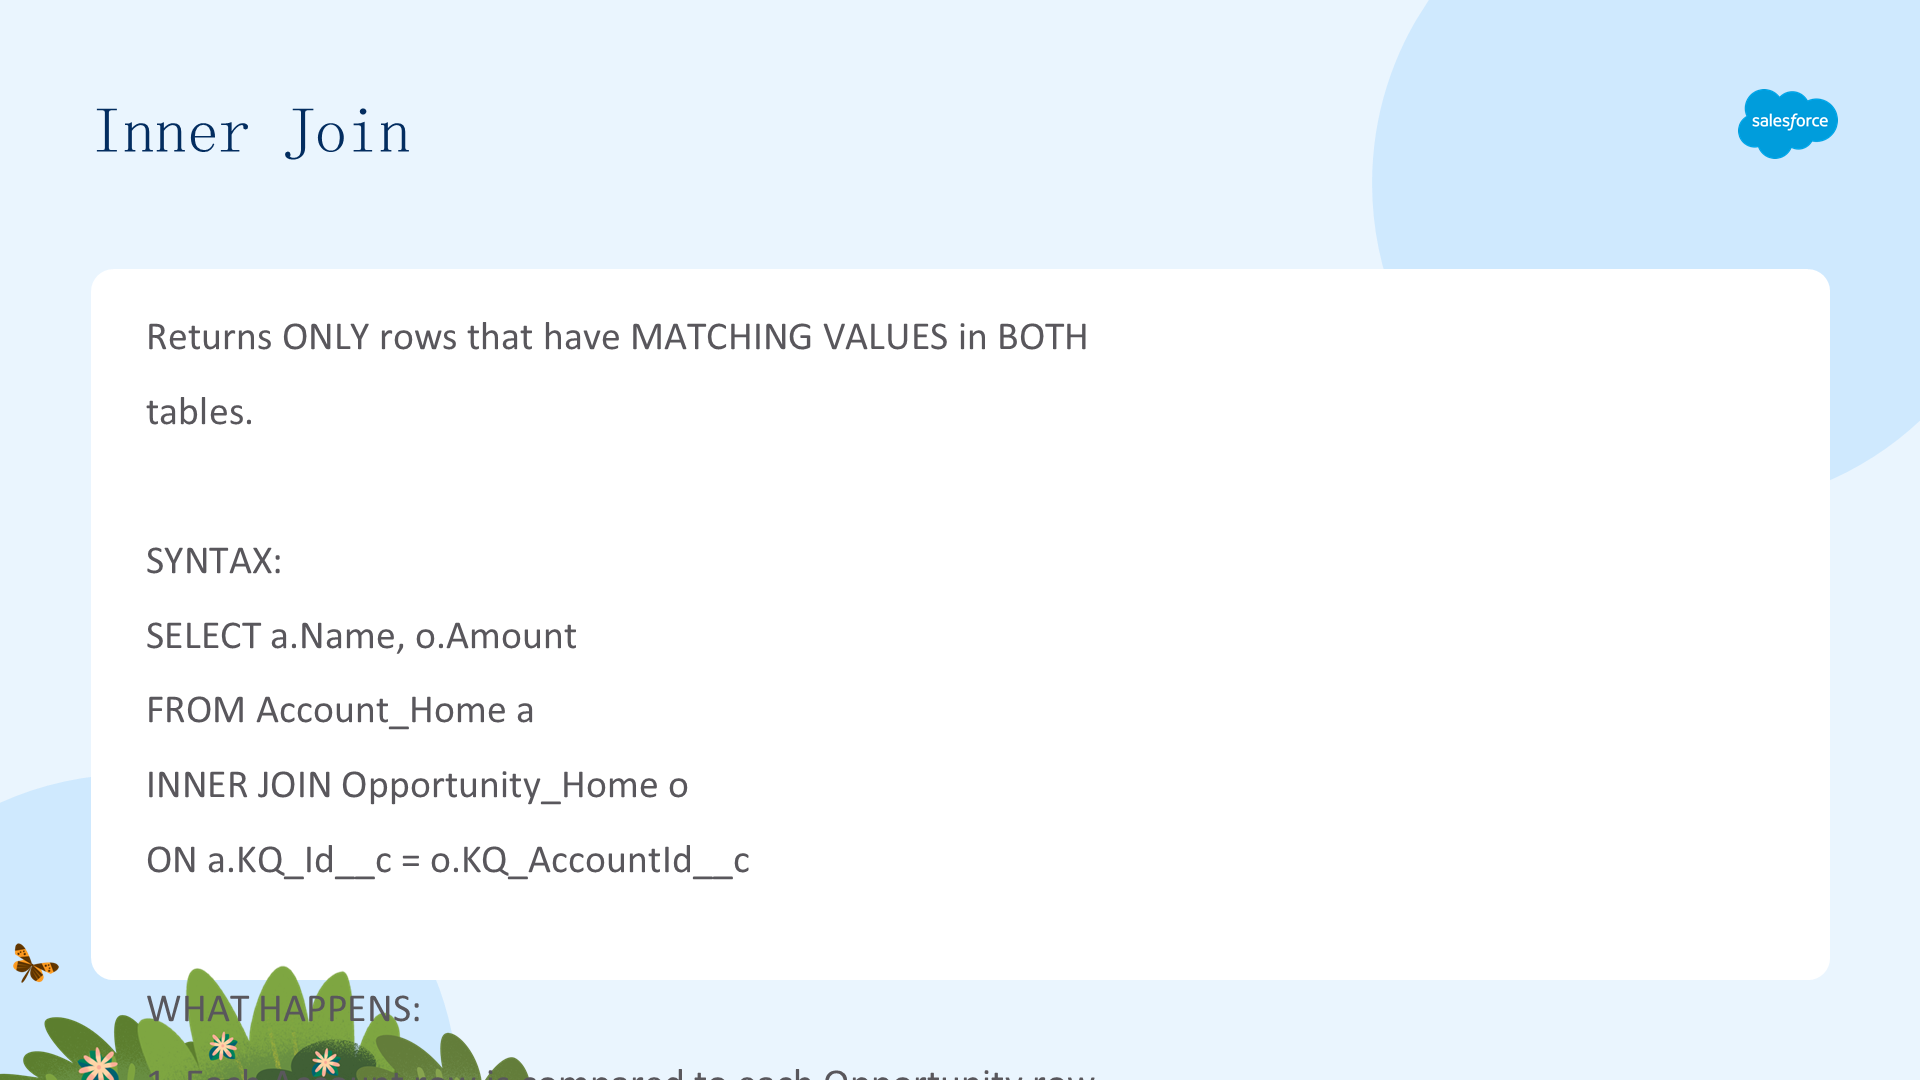
INNER JOIN 是最常见的联接类型,只返回两张表中指定联接字段有匹配值的行,只存在于其中一张表的记录会被排除。
{sql("SELECT i.FirstName, i.LastName, e.EmailAddress FROM Individual i INNER JOIN ContactPointEmail e ON i.ssot__IndividualId__c = e.ssot__IndividualId__c")}该查询把 Individual DMO 与 ContactPointEmail DMO 通过公共键 ssot__IndividualId__c 联接,只有 Individual ID 同时存在于两个 DMO 中的记录才会被纳入。注意别名(i.、e.)用来明确指定每个字段来自哪张表。
用 INNER JOIN 的场景:只想要两表都存在的记录(如「有邮箱联系点记录的个体」)。
外联接(OUTER JOIN)
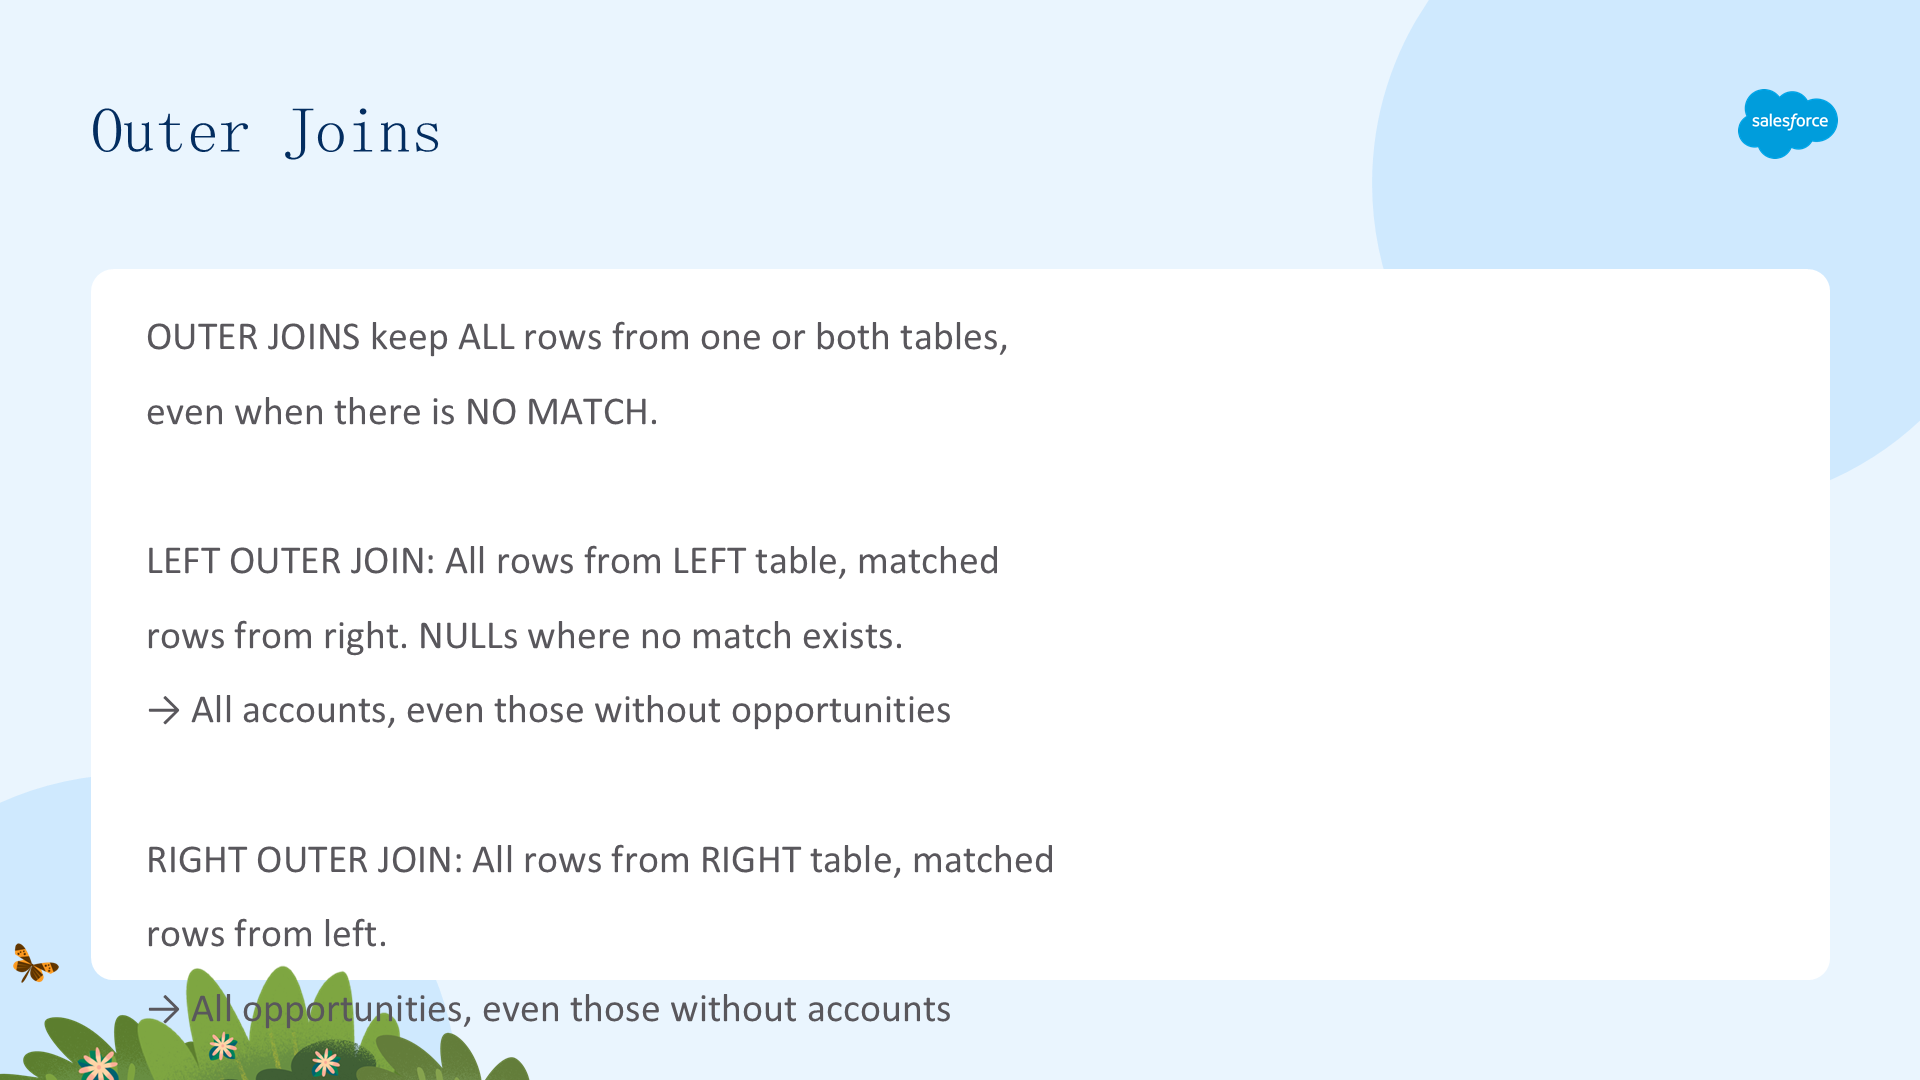
有时您需要包含那些在另一张表中没有匹配的记录,这时就要用外联接。
- LEFT OUTER JOIN(LEFT JOIN):返回左表(FROM 中先列出的表)所有行 + 右表匹配行;左表某行无匹配时,右表字段返回 NULL。用于「所有个体,包括没有邮箱地址的」;
- RIGHT OUTER JOIN(RIGHT JOIN):返回右表所有行 + 左表匹配行;
- FULL OUTER JOIN(FULL JOIN):返回两表所有行,无匹配一侧的列返回 NULL。
为简洁和可移植,通常优先使用 LEFT JOIN。如果需要 RIGHT JOIN,一般只需交换两表顺序并用 LEFT JOIN 即可实现相同结果。用 NULL 检查可识别缺失的关系(如「哪些账户没有商机」)。
联接最佳实践:使用关键限定符
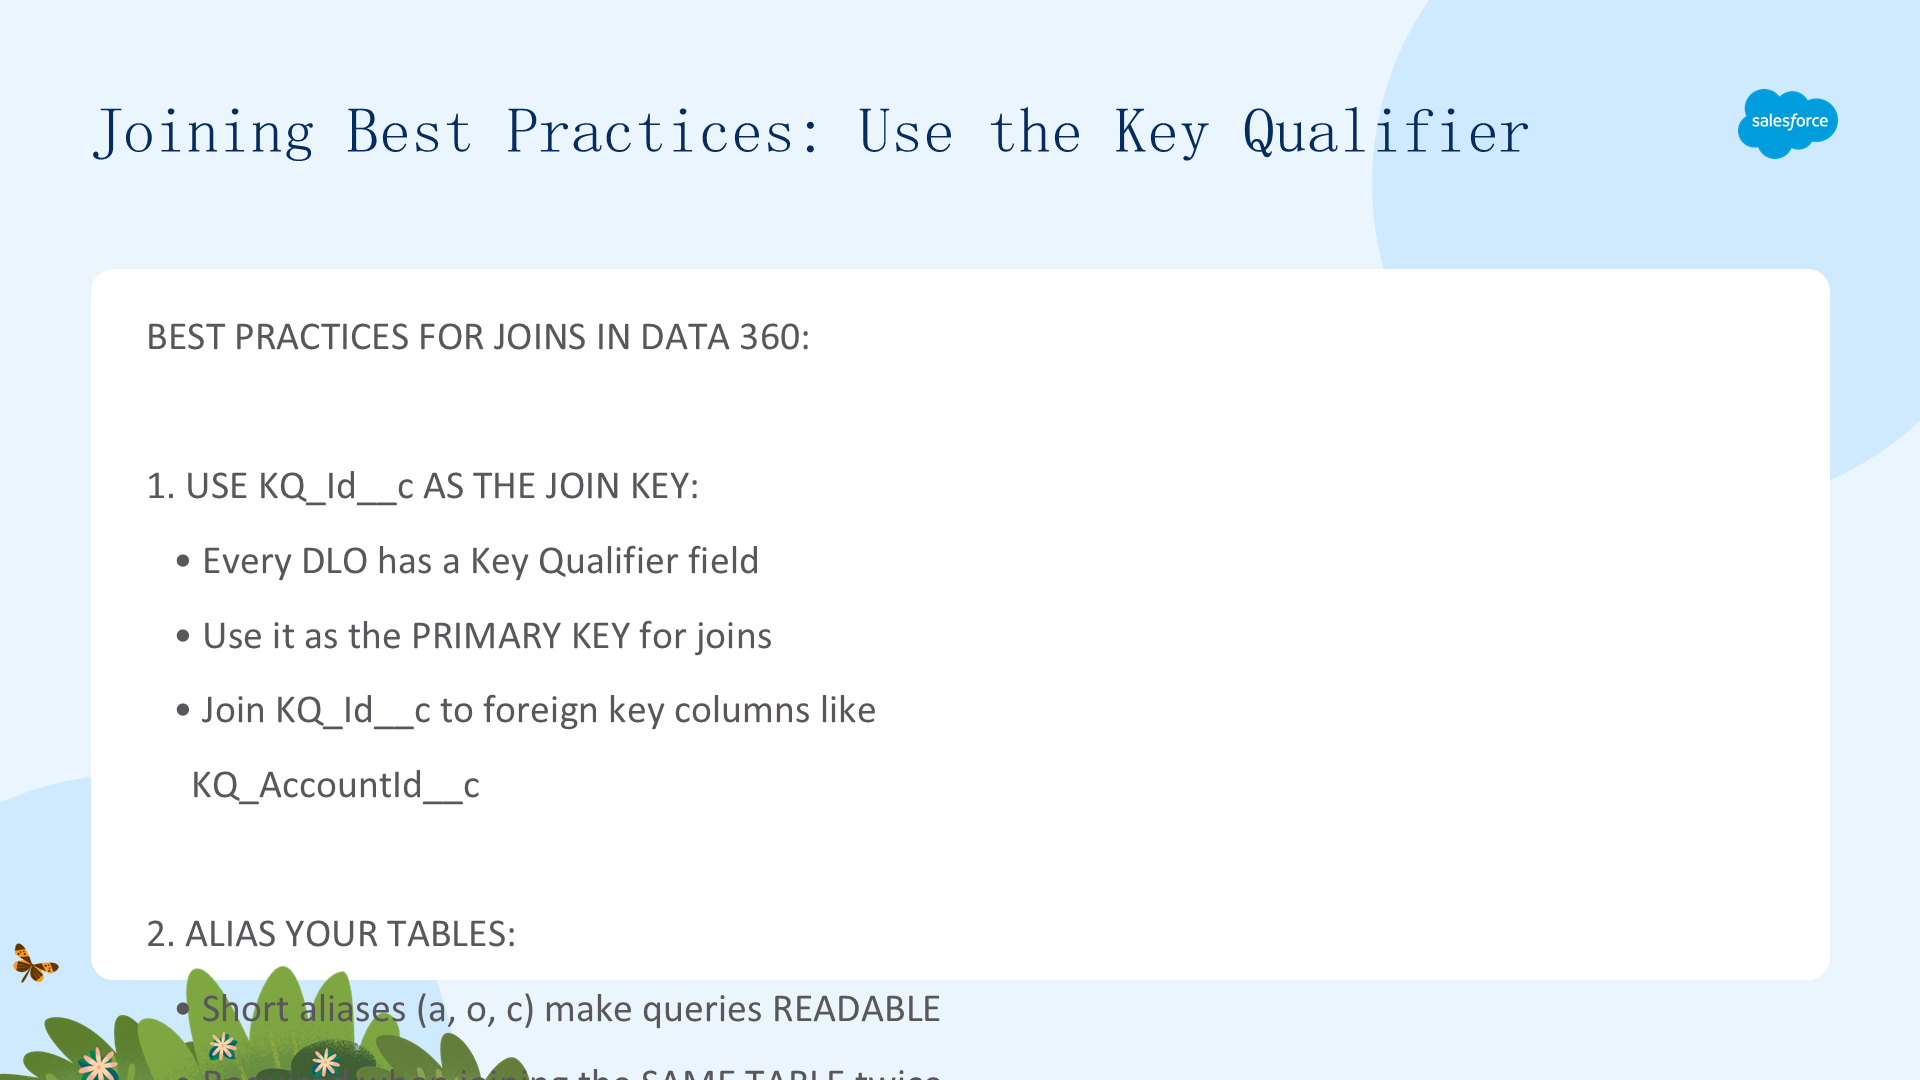
在单元一中您已了解关键限定符(KQ_Id__c)字段。对于大多数查询——尤其是涉及一对多关系的(如一个 Individual 有多个 Contact Point)——Data 360 通常要求同时按主 ID 和 KQ_Id__c 联接,以获得最准确、唯一的结果。
更稳健的邮箱列表联接如下:
{sql("SELECT i.FirstName, i.LastName, e.EmailAddress FROM Individual i INNER JOIN ContactPointEmail e ON i.ssot__IndividualId__c = e.ssot__IndividualId__c AND i.KQ_Id__c = e.KQ_IndividualId__c")}同时按两个字段联接是 Data 360 SQL 中的最佳实践,可确保正确关联到记录的特定、限定版本。其他实践还包括:给表起短别名、选择正确的联接类型、使用表限定的列名(如 a.Name)以防歧义。
五、使用高级 SQL 技术
释放查询的全部潜力
高级 SQL 技术超越了基础的 SELECT 和 WHERE,能处理复杂的业务逻辑。本单元涵盖:
- CASE 表达式 → 查询中的条件逻辑;
- 字符串函数 → 文本处理;
- CTE(通用表表达式) → 简化复杂查询;
- 子查询 → 查询中的查询。
这些技术可实现数据分类、文本清洗、层级分析和多步数据转换——全都在 SQL 中完成,而无需单独的数据转换任务。
用 CASE 和字符串函数转换数据
两种强大的转换技术:
- CASE → 条件逻辑:根据条件对数据进行分类、分桶和重新归类;
- 字符串函数 → 文本处理:拼接、提取子串、转换大小写、去除空格。
它们直接在 SQL 中把原始数据转换成分析就绪的格式,而无需单独的批量数据转换任务——把转换逻辑与分析逻辑放在一起。
用 CASE 应用条件逻辑
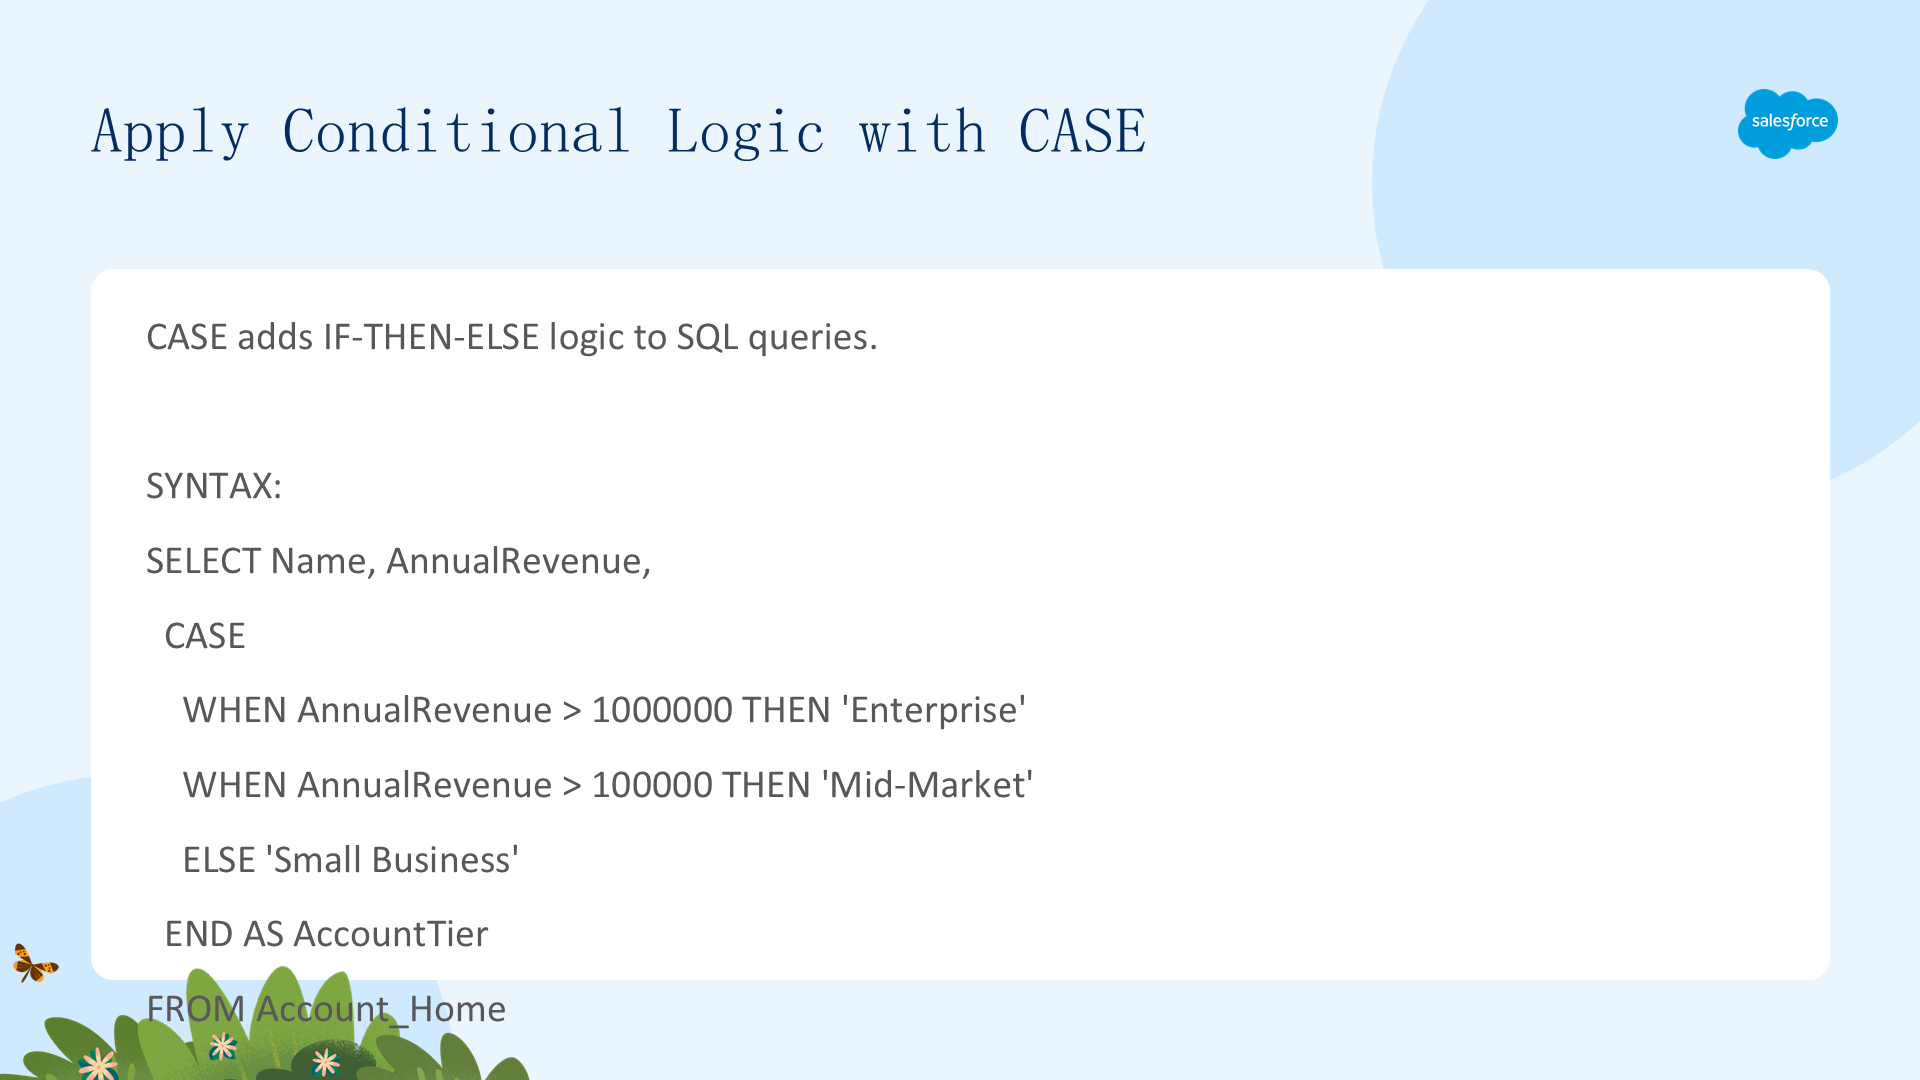
CASE 表达式让您在 SELECT 语句中直接实现 if/then/else 逻辑:检查字段值是否满足一个或多个条件,并返回相应结果,非常适合创建业务分类。
{sql("SELECT Name, AnnualRevenue, CASE WHEN AnnualRevenue > 1000000 THEN 'Enterprise' WHEN AnnualRevenue > 100000 THEN 'Mid-Market' ELSE 'Small Business' END AS AccountTier FROM Account_Home")}每条记录按顺序评估 WHEN 条件,第一个匹配的条件决定结果;ELSE 为不匹配的行提供默认值。CASE 让数据分类变得声明式和可重复——如客户分层(Enterprise/Mid/Small)、数据标准化、标记创建(At Risk/On Track/Ahead)。
用字符串函数操作文本
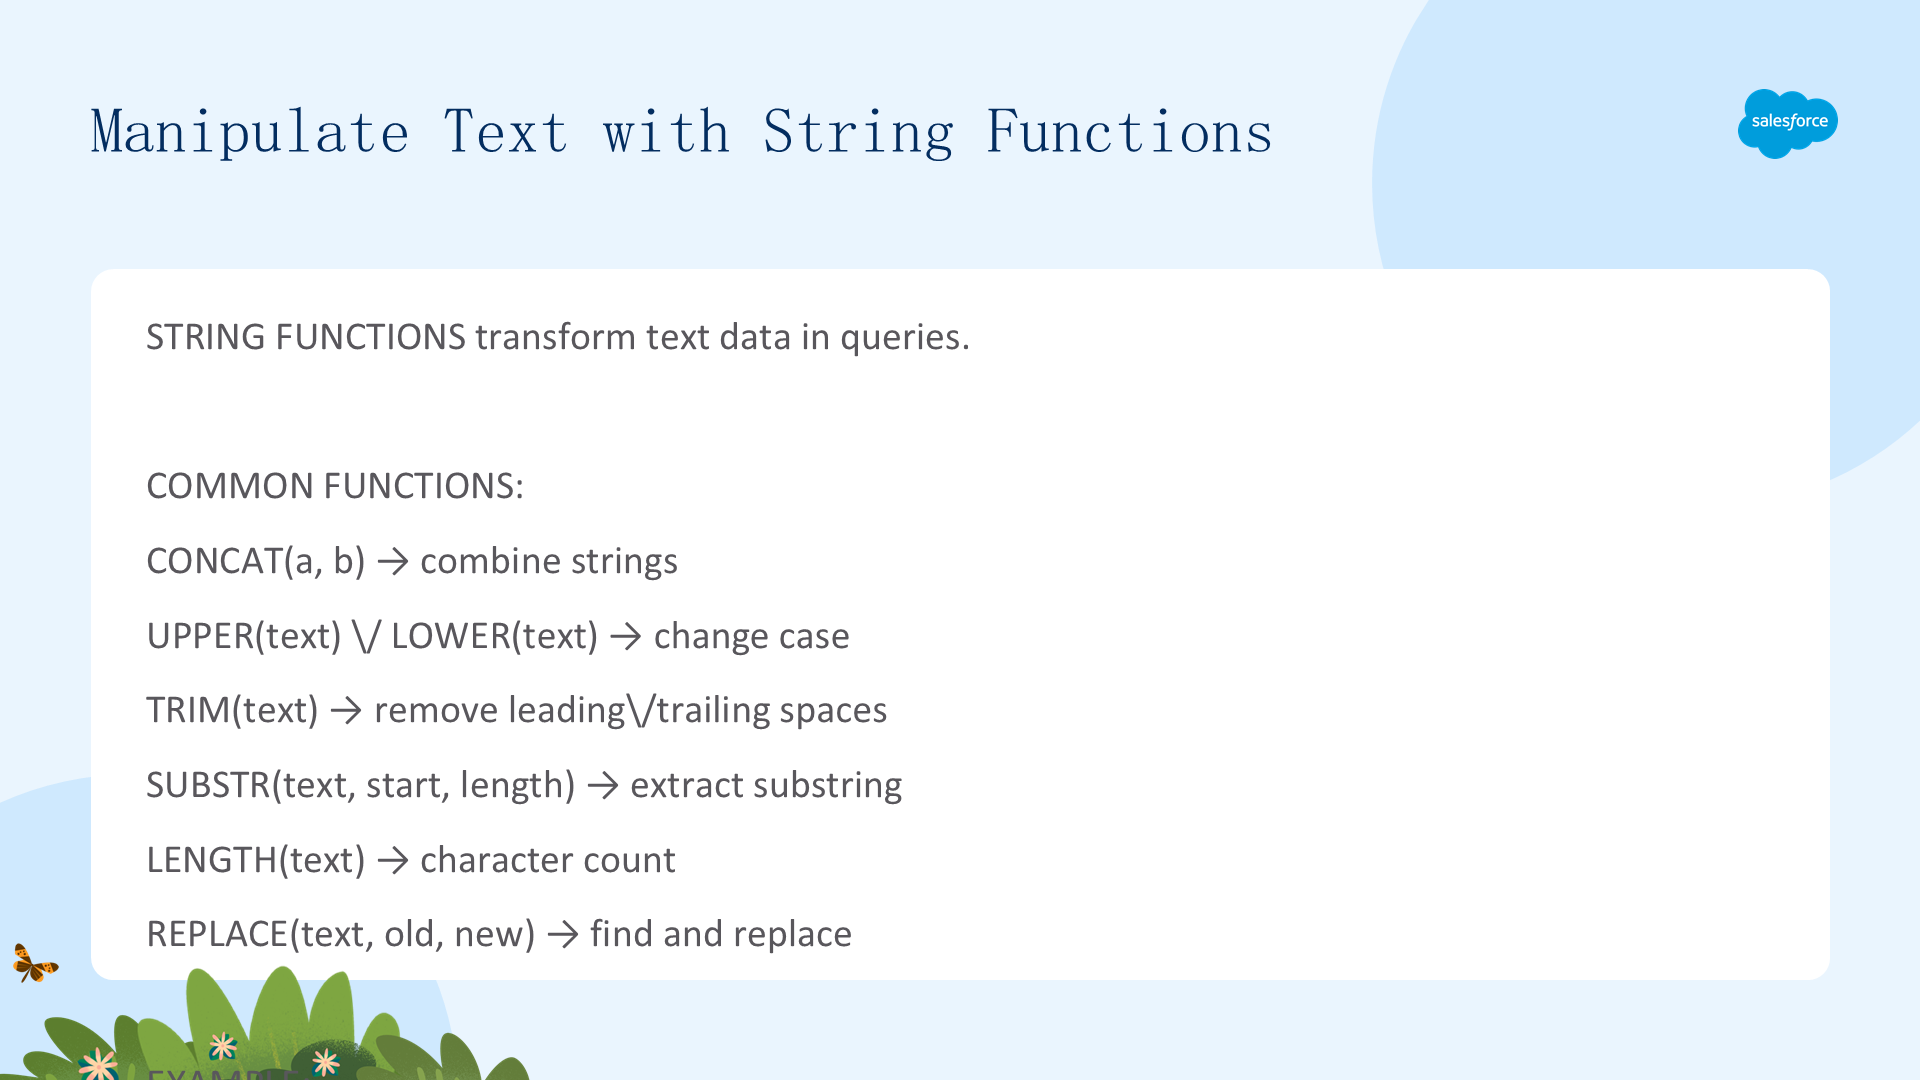
字符串函数对规范化、清洗文本数据至关重要,能确保过滤或分组时的准确性。常用函数:
CONCAT(a, b)→ 拼接字符串;UPPER(text)/LOWER(text)→ 转换大小写;TRIM(text)→ 去除首尾空格;SUBSTRING(text, start, length)→ 提取子串;LENGTH(text)→ 字符数;REPLACE(text, old, new)→ 查找替换。
字符串函数处理文本数据的「脏乱」现实——大小写不一致的姓名、含多余空格的地址、嵌在长字符串里的 ID,都能直接在 SQL 中清洗和标准化。
简化和优化查询
随着分析变复杂、需要多步过滤和计算,查询会变长、难以阅读。CTE 和子查询有助于组织和优化这些复杂逻辑:
- CTE(通用表表达式) → 把复杂查询拆成命名、可复用的子块;
- 子查询(subquery) → 在查询中嵌套另一个查询用于过滤或比较。
两者都能让复杂查询更易读、更易维护,通常也更高效。
用 CTE 简化复杂查询
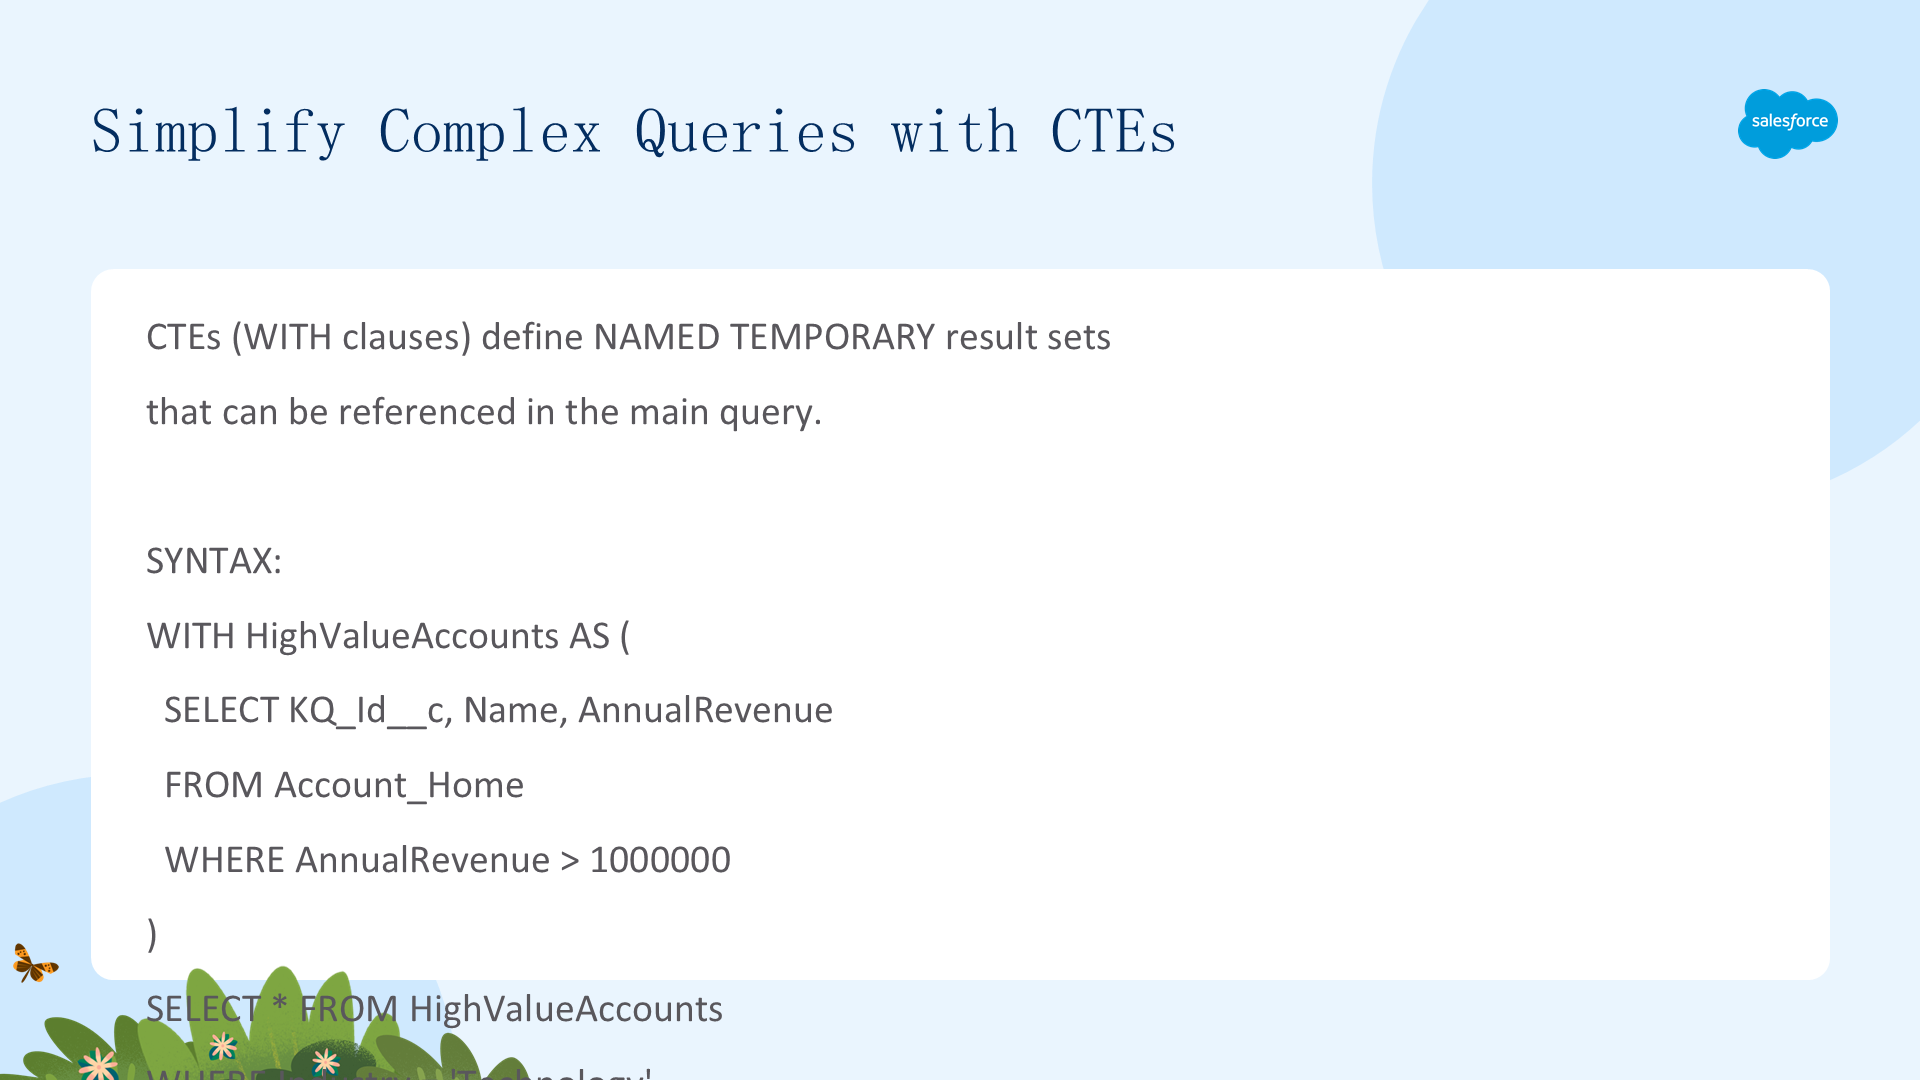
通用表表达式(CTE)是在单个 SELECT 语句的执行范围内定义的临时、命名结果集,使用 WITH 子句定义。CTE 非常适合把多步查询拆解成逻辑、可读的部分。
{sql("WITH HighValueAccounts AS ( SELECT KQ_Id__c, Name, AnnualRevenue FROM Account_Home WHERE AnnualRevenue > 1000000 ) SELECT * FROM HighValueAccounts WHERE Industry = 'Technology'")}在此示例中,HighValueAccounts CTE 先被计算,然后在最终 SELECT 中像标准 DMO 一样被引用。CTE 的收益:可读性(每个 CTE 代表一个逻辑步骤)、可复用性、可维护性——相当于 SQL 中的「变量」或「函数」。
用子查询检查相关数据
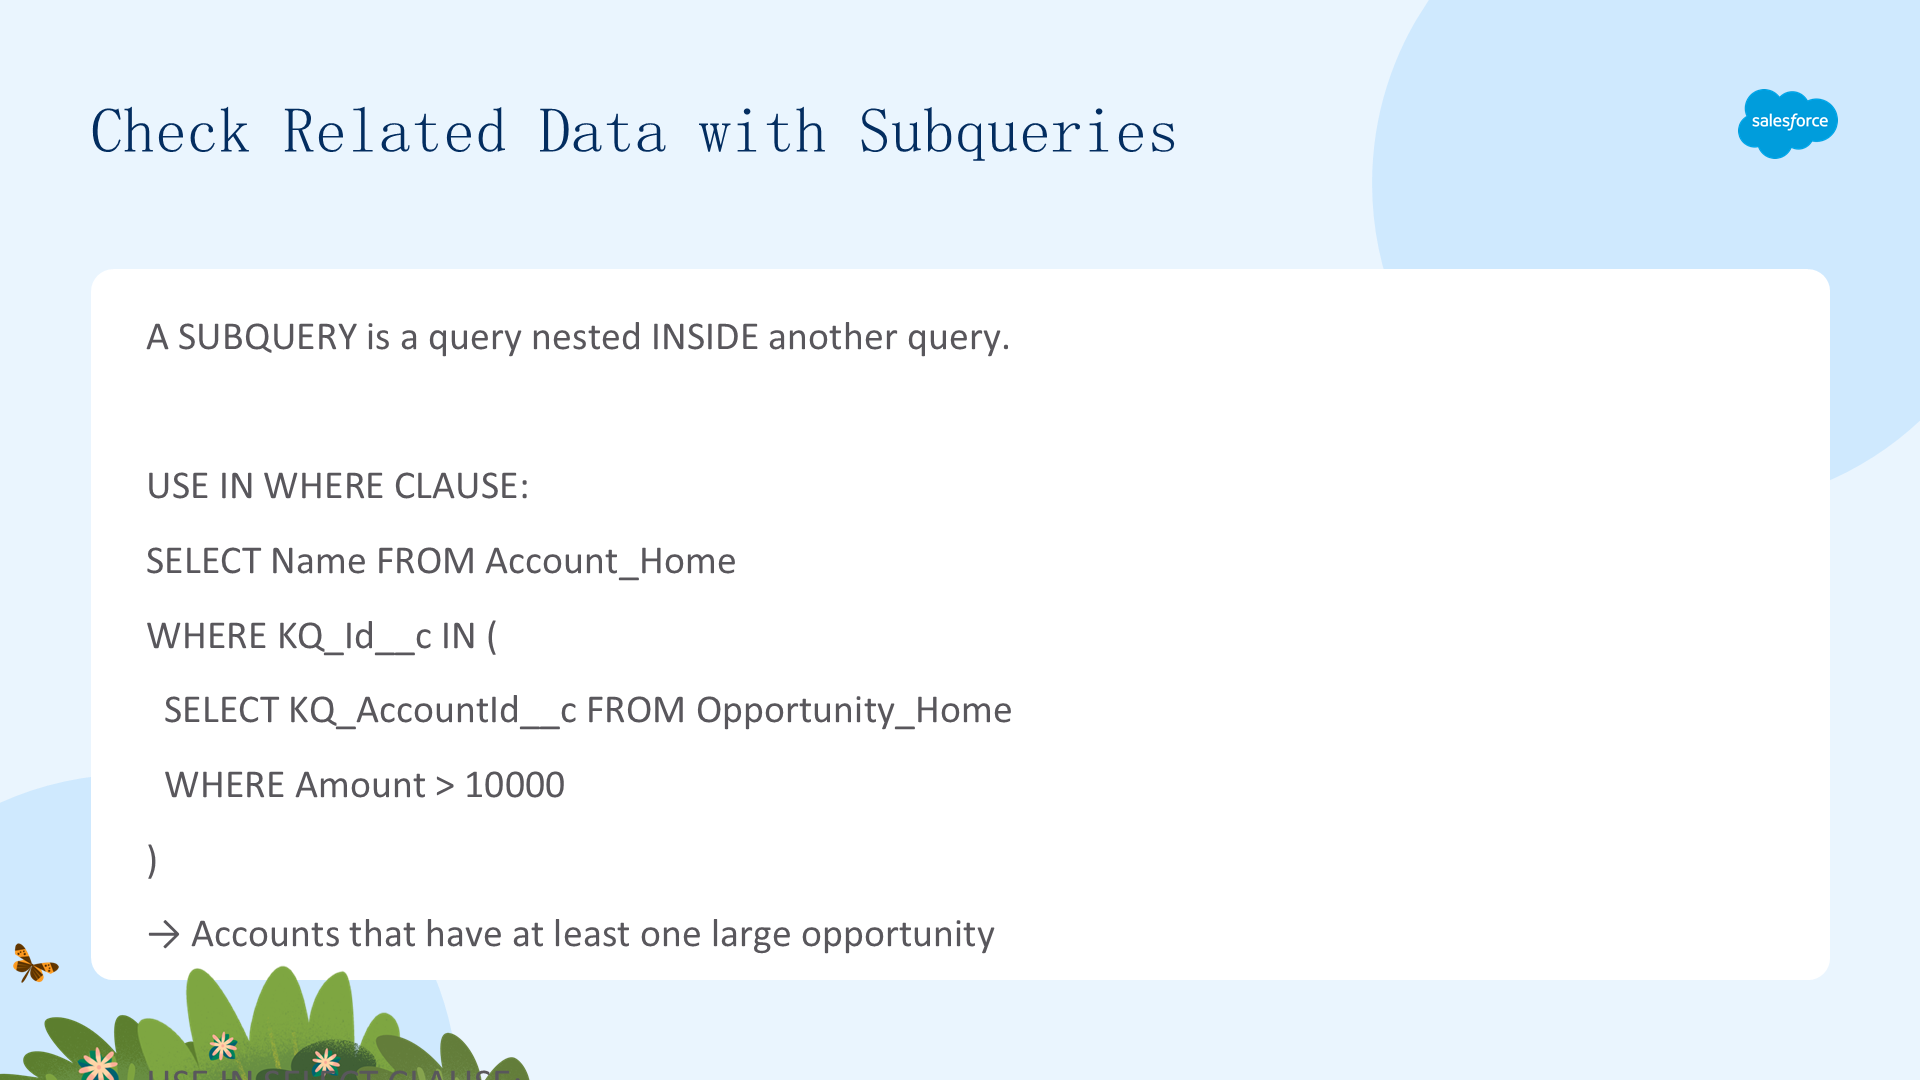
子查询(subquery)是嵌套在另一个 SELECT 语句内的查询,常用于 WHERE 子句中,基于相关 DMO 的数据过滤主查询,而无需完整联接。
EXISTS 运算符检查子查询是否返回任何行,效率很高——因为子查询一找到第一个匹配就停止。用 EXISTS 找出至少有一条相关销售订单的所有个体;相反,NOT EXISTS 在子查询不返回任何行时返回 TRUE,可用来识别「没有销售订单记录」的高风险客户。
{sql("SELECT Name FROM Account_Home WHERE EXISTS ( SELECT 1 FROM Opportunity_Home o WHERE o.KQ_AccountId__c = Account_Home.KQ_Id__c AND o.Amount > 10000 )")}子查询功能强大,但大数据集上可能较慢——性能敏感时考虑改用 CTE 或 JOIN。