提升 Data 360 技能
Data 360 学习之旅
Data 360 的学习之旅很直接:连接数据 → 映射到数据模型 → 统一数据 → 根据业务用例采取行动。但理解 Data 360 如何运作只是其中一部分,要真正发挥它的威力,还需要具备相应技能和经验的人。
此外,由于围绕数据的技术及其对 AI 的影响在快速演进,现在已不只是「数据」本身的问题,还涉及元数据(metadata)、语义(semantics)、上下文(context)、记忆(memory)等更多层面。数据专业人员的角色如今同时承载了首席数据官(CDO)与首席 AI 官(CAIO)的双重职责。
到目前为止,在 Data 360 学习之旅中您已经掌握了业务场景、收益和核心功能。在这一最终阶段,您将深入高级功能、开发者工具,以及构建跨 Salesforce 的端到端解决方案。那么,要取得成功需要哪些高级技能呢?
拓展你的技能
Data 360 用户需要的技能远不止理解数据本身,他们还必须理解 Salesforce 功能、Data 360 特有功能,以及越来越多地为提升 LLM 表现而需要的 LLM 解析 / 分块(chunking)策略。
无论您的日常工作身份是数据科学家、架构师、管理员、顾问还是营销人员,现在都同时肩负着首席数据官和首席 AI 官的责任。要成为公司数据(以及随之而来的 Agent)的有效管理者,Data 360 用户日益需要理解以下概念:
- 数据模型结构与概念;
- 数据血缘(data lineage)与数据卫生(data hygiene);
- 本体论(ontology)与元数据;
- 语义层与上下文;
- 治理与标记(tagging);
- 查询开发与优化;
- 用数据包(data kits)和沙盒开发;
- 大语言模型(LLM)及预测式与生成式 AI;
- 面向搜索索引和 RAG 的分块策略;
- 提示词开发与测试框架;
- 架构依赖与故障排查。
除 Data 360 学习路径外,Trailhead 还提供其他培训,包括 Build Your Data Literacy 学习路径,以及独特的 Agentblazer 项目——您甚至能成为 Agentblazer Legend!
高级 Data 360 内容
本里程碑中的内容帮助您构建跨 Data 360 的技能——从扩展转换、构建更高效的查询,到创建更高级的细分(segment)。以下预览五个高级内容领域:
- 架构指导(Architecture Guidance)——org 设置、数据空间、互操作性、多 org 复杂度;
- 提升数据、提升结果(Improve Data, Improve Results)——数据转换、Informatica 数据卫生、语义层、分块策略;
- 扩展功能(Expand Functionality)——高级细分、搜索索引、Intelligent Context、Document AI;
- 优化性能(Optimize Performance)——Data Graphs、Query Builder、降低信用额度消耗;
- 数据驱动自动化(Data-Driven Automation)——精简流程、智能工作流、面向结果的上下文引擎。
这些领域能帮助您提升性能、优化信用额度使用、精调 Data 360 功能。下面逐一展开。
架构指导
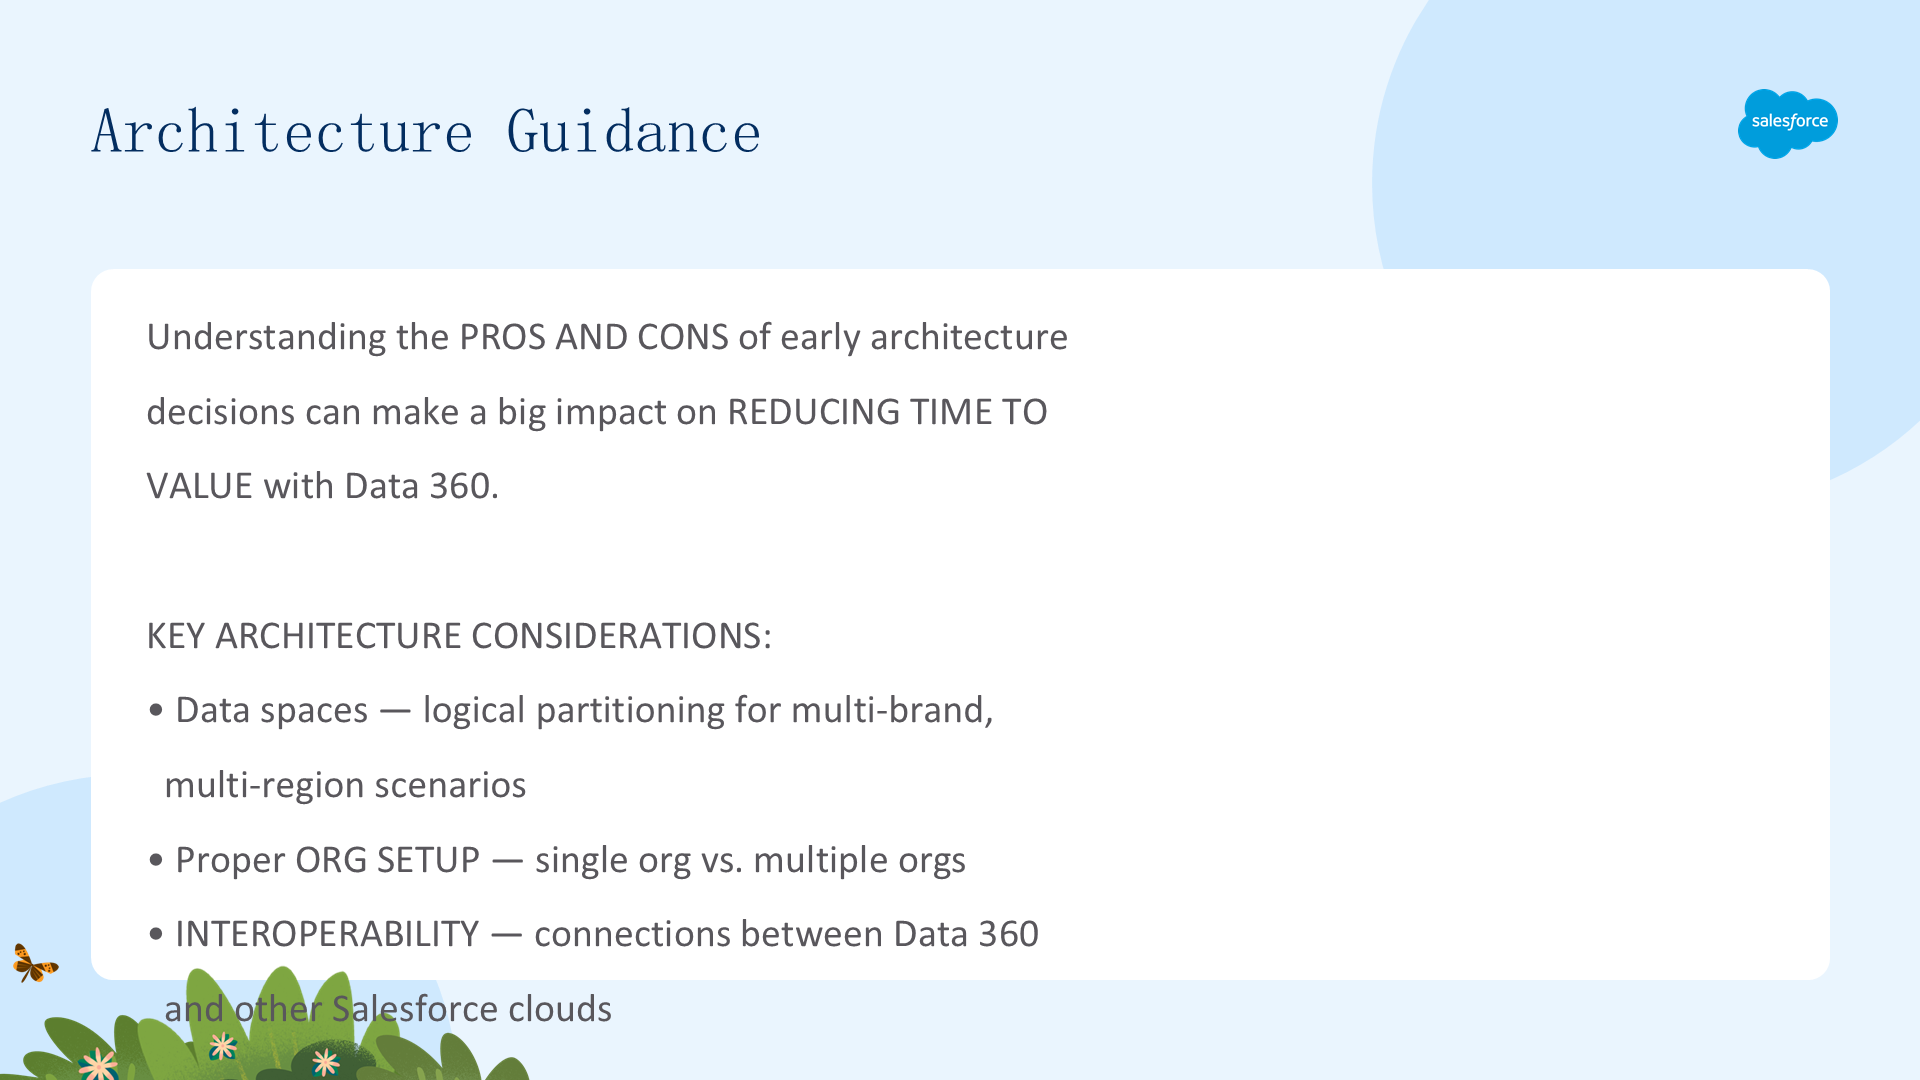
理解早期架构决策的利弊,可以极大地缩短 Data 360 的价值实现时间(time to value)。关键架构考量包括:
- 数据空间(data spaces)——为多品牌、多区域场景做逻辑分区;
- 合理的 org 设置——单 org vs 多 org;
- 互操作性(interoperability)——Data 360 与其他 Salesforce 云之间的连接。
复杂度会迅速攀升:单个 org 时架构决策相当直接;一旦叠加多个 org、数百个数据源、双向连接和复杂的安全需求,Data 360 架构会迅速变得复杂。要满足治理合规要求,就必须透彻理解数据隔离(data segregation)、元数据的访问控制,以及限制某些访问的下游影响。
早期做出正确的架构决策,可以避免日后昂贵的返工。
提升数据,提升结果
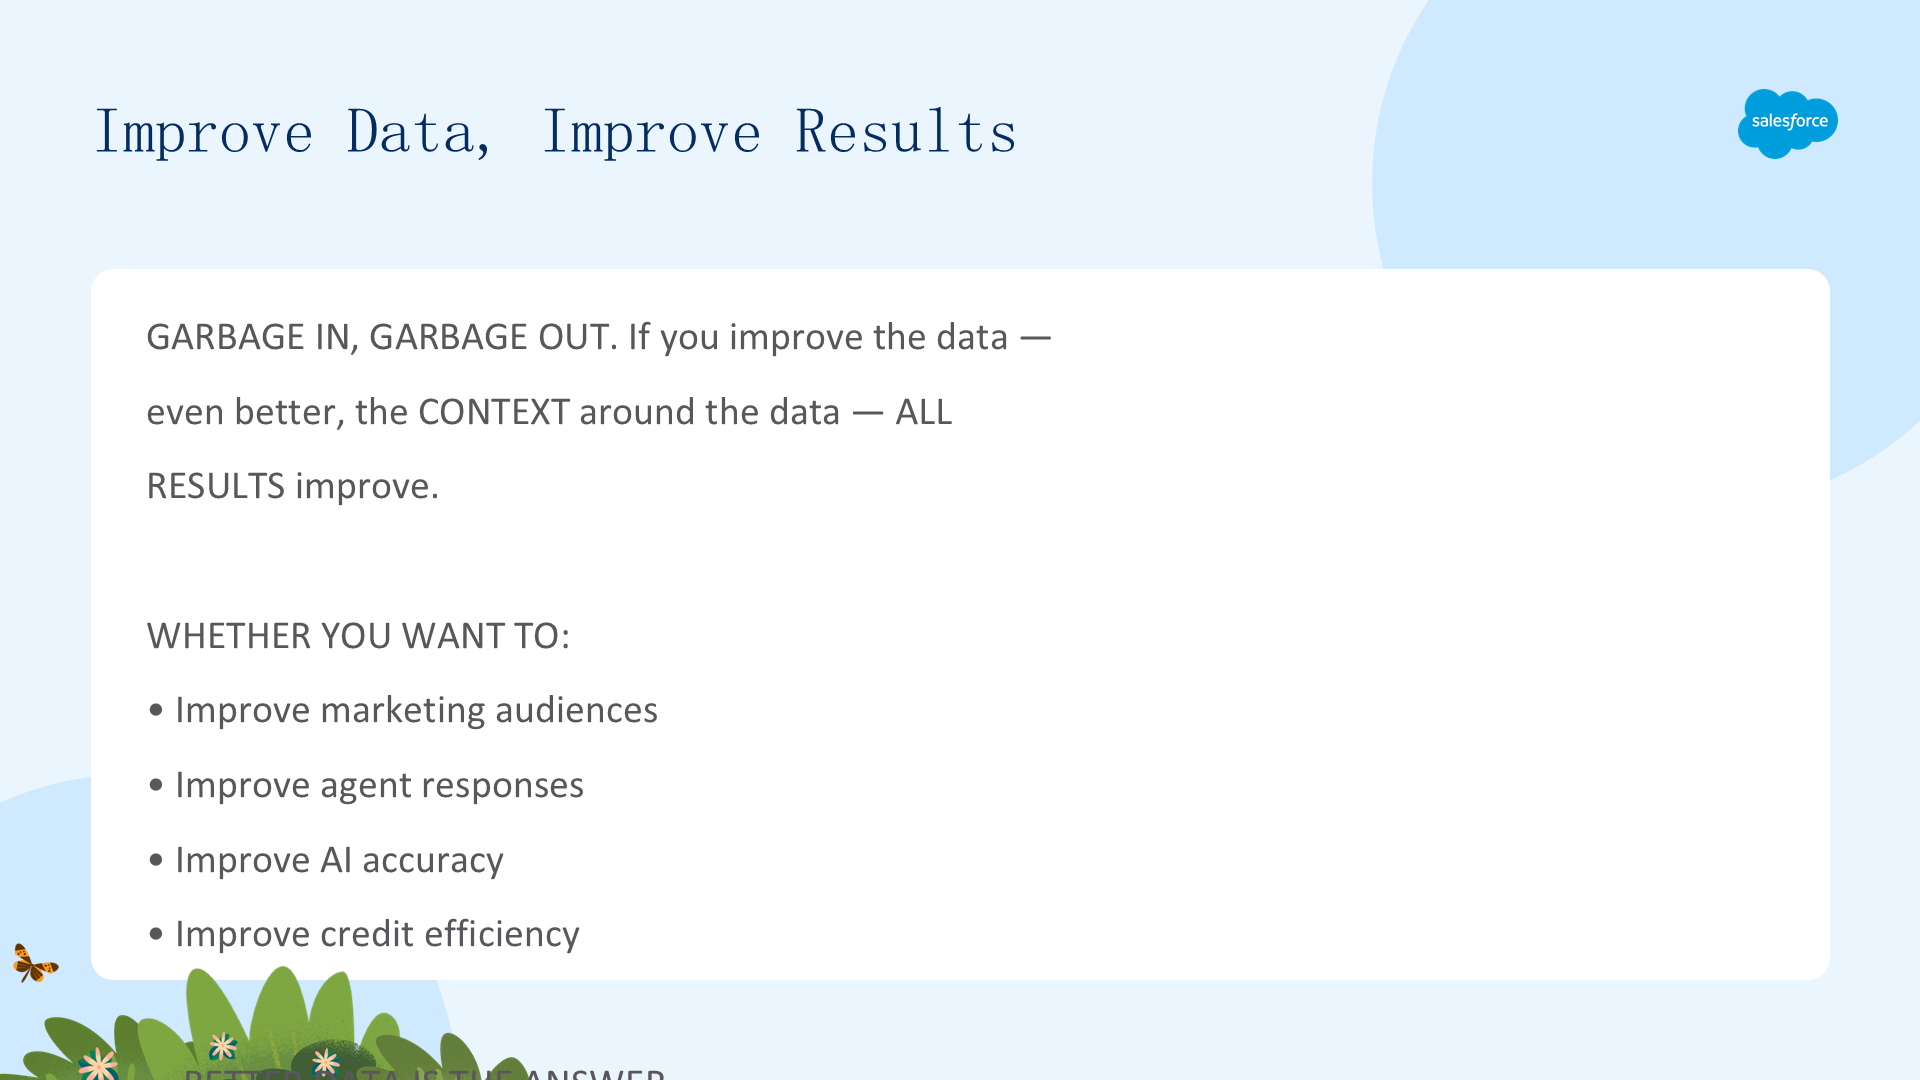
关于数据,您可能听过「垃圾进,垃圾出(garbage in, garbage out)」这句话。如果您改善了数据——甚至更好,改善了数据周围的上下文——所有结果都会随之改善,无论您是想改善营销受众还是改善 Agent 响应。
改善数据的方法包括:
- 数据转换(Data Transforms)——批量与流式转换,用于清洗、标准化和丰富数据;
- Informatica 数据卫生——企业级数据质量能力;
- 语义层(Semantic Layer)——用 Tableau Semantics 一致地定义业务术语和指标;
- 分块策略(Chunking Strategies)——优化非结构化内容为搜索和 RAG 而拆分的方式。
干净、结构良好、语义清晰的数据,是每一次成功 AI 实现的基础。一个基于干净数据构建的 Agent 会给出准确、有用的回答;而基于不一致、格式混乱数据构建的 Agent 则会给出错误或含糊的回答。
扩展功能
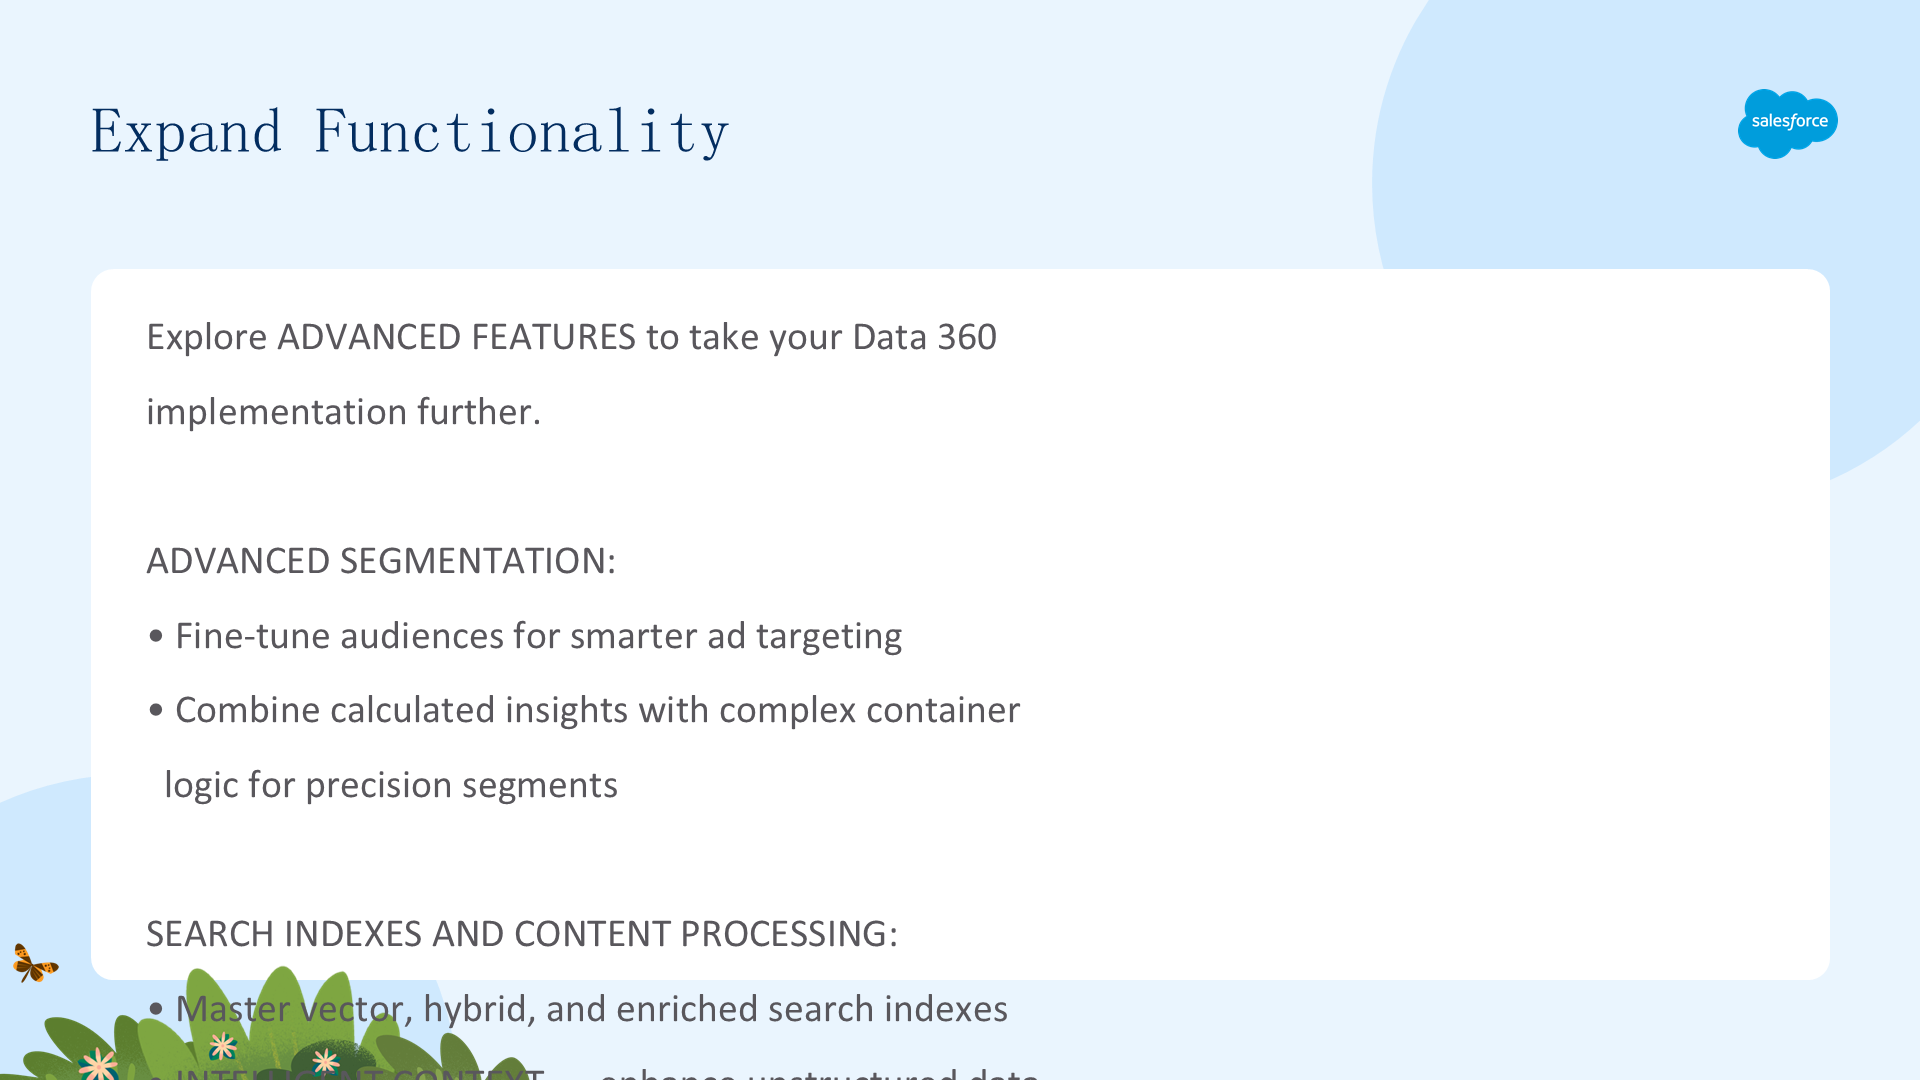
探索高级功能,让您的 Data 360 实现更进一步。
高级细分(Advanced Segmentation):
- 精调受众,实现更智能的广告定向;
- 将计算洞察与复杂的容器逻辑相结合,构建精准的细分。
搜索索引与内容处理:
- 掌握向量(vector)、混合(hybrid)和增强(enriched)搜索索引;
- Intelligent Context——用 AI 驱动的上下文抽取增强非结构化数据处理;
- Document AI——从 PDF、发票和合同中提取结构化数据(姓名、日期、金额等)到数据湖对象。
这些功能让您从基础的 Data 360 使用,进阶到高级的、AI 驱动的数据处理与激活场景——每个功能都建立在 connect-map-unify-act 的核心基础之上。
优化性能
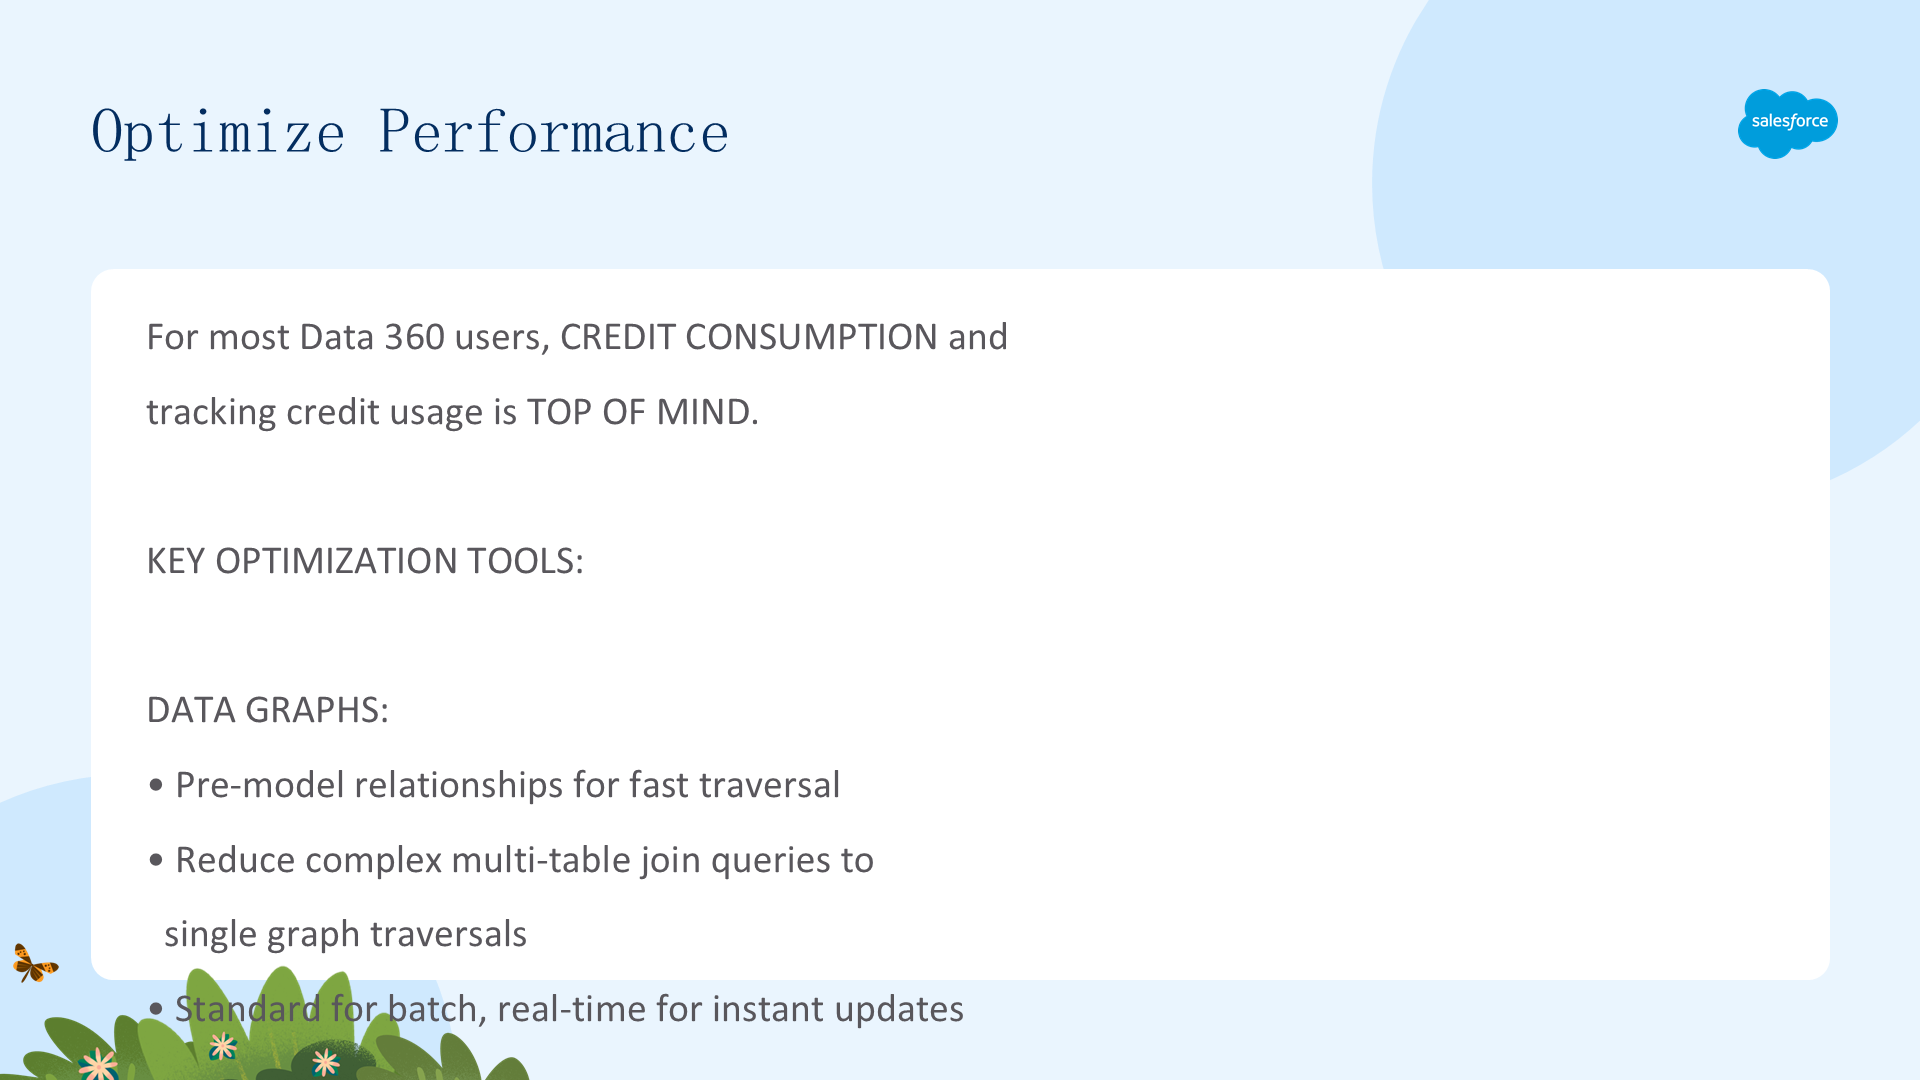
对大多数 Data 360 用户来说,信用额度消耗(credit consumption)及其追踪是最关注的问题。关键的优化工具包括:
- Data Graphs(数据图谱)——预先对关系建模以实现快速遍历,把复杂的多表联接查询简化为单次图谱遍历;标准图谱用于批处理、实时图谱用于即时更新;
- Query Builder(查询构建器)——在部署前测试和优化查询,理解查询性能特征,在消耗生产额度前识别昂贵的操作。
通过扩展查询技能,您可以直接影响查询性能并降低信用额度消耗。想象一下在年度绩效评估时告诉老板「我把信用额度消耗降低了 X%」——那是多么有说服力的成果!性能优化 = 成本优化。
数据驱动自动化
精简流程、自动化任务,可确保平台在无需持续人工干预的情况下保持稳健。超越单个工具,掌握高级数据技能是组织效率的催化剂,它能把 Data 360 转变为一个面向结果的上下文引擎(outcome-focused context engine)。
需要思考的关键问题:
- 您的流程自动化需要哪些数据?
- 需要哪些数据来减少手动配置、转向自动化、智能化的工作流?
- 如何用 Data 360 触发的 Flow 取代人工监控和干预?
- 如何用计算洞察驱动基于阈值的自动化,而非计划批处理?
目标:从被动的数据管理,迈向主动、自动化的数据智能,无需人工干预即可驱动 Agent、Flow 和体验——这是自主化企业的愿景。
下一步是什么?
通过深化对 Data 360 高级技能的理解——改善数据卫生、掌握优化工具、构建上下文——您将在AI 优先的市场中极具竞争力。
您的高级学习路径:
- 完成 Batch Data Transforms 徽章,提升数据质量;
- 继续 Data 360 学习之旅的 Level 3,学习高级功能和开发者工具;
- 探索 Data 360 Consultant 认证路径,验证您的专业能力;
- 查看配套学习路径,检查 Data 360 知识中的任何缺口;
- 加入 Agentblazer 项目,成为 Agentblazer Legend。
随着工具和功能的扩展,请随时回来重新查看此学习路径,了解最新内容。Data 360 的格局正在快速演进——持续学习不是可选项,而是必需品。