一、探索 Data 360 与 Agentforce
探索 Data 360 与 Agentforce 如何交互
您已经决定在 Salesforce org 中使用 Agentforce,并期待构建真正了解客户和业务的 AI Agent。要理解两者之间的联系,先来看 Data 360 为 Agentforce 提供的两个层次:启用(enablement)和实现(implementation)。
- 启用:在 org 中开通并启用了 Data 360。
- 实现:不仅启用了 Data 360,还连接了数据、将其映射到数据模型,并可能通过身份解析规则集整合了数据、配置了其他 Data 360 功能。
启用和实现 Data 360 会对 Agentforce 的能力产生不同影响:
- 仅启用 Data 360:这是所有 Agentforce 使用场景的前提。诸如 Agentforce Data Library 和 Einstein Trust Layer 等功能,没有 Data 360 就无法工作。
- 实现 Data 360:实现后您将获得多样化的客户 360 数据、强大的数据清洗与转换能力,以及完全可自定义的 RAG。要构建强大的 Agent 队伍并支持复杂需求,就必须实现 Data 360。
本模块将讲解启用与实现 Data 360 分别如何影响您的 Agent——Data 360 与 Agentforce 协同工作,为您提供植根于企业数据的、有效且可信的 Agent。
Data 360 已实现:基于客户 360 数据构建的 Agent
当 Data 360 完全实现后,它提供了一个稳健、安全的数据基础,让 Agent 能够访问统一的客户 360、转换后的、实时的以及零拷贝(zero-copy)的数据。下面以虚构的服装公司 Northern Trail Outfitters(NTO) 为例,看看 Data 360 基础的几个关键方面如何影响 Agent。
统一客户 360(Unified Customer 360)——汇聚来自 Salesforce 内外的数据,运行身份解析规则集,为每位客户构建带有完整历史上下文的统一画像。Agent 基于 Data 360 数据,能深入了解客户从 Sales Cloud 的购买到 Marketing Cloud 的互动。NTO 示例:客户请求产品推荐 → Agent 看到客户最近购买了新系列的鞋子、还点击了夹克的营销活动 → 于是推荐匹配的夹克而非鞋子。
数据转换(Data Transforms)——清洗和转换数据,解决命名和格式不一致等数据质量问题。干净的数据能提升 Agent 的准确性、一致性和可靠性。NTO 示例:订单日期是 DD/MM/YY 格式,而退货政策公式只支持 MM/DD/YY,导致 Agent 无法处理退款 → NTO 运行数据转换把所有日期转为 MM/DD/YY 格式 → 退款流程恢复正常。
实时数据(Real-Time Data)——实时摄取、统一、分析并对数据采取行动,让 Agent 掌握客户当前的行为并在几秒内响应。NTO 示例:客户浏览网站时打开 Agent 聊天询问当前促销 → Agent 实时看到客户正在点击背包 → 于是推荐最相关的「指定背包买一送一」促销。
零拷贝(Zero Copy)——连接存储在 Salesforce 之外的数据,在 Data 360 与外部系统之间建立双向通信,无需复制数据即可自由访问。NTO 示例:忠诚度数据存储在 Databricks,通过零拷贝连接引入 Data 360 丰富统一画像 → Agent 看到客户是白金会员 → 推荐专属促销。
虽然还有其他为 Agentforce 摄取数据的方式,但 Data 360 是唯一支持整体 360 战略与统一数据的方案:CRM 数据通过 Fileforce 只摄取非结构化 CRM 数据、不统一数据;Agentforce Data Library 同样只摄取非结构化数据、不统一数据。
本单元小结
在本单元中,您了解了基于 Data 360 构建的 Agent 如何受益于统一、转换后、实时和零拷贝的数据。
- 仅启用 Data 360 = 所有 Agentforce 功能(Data Library、Trust Layer)的前提;
- 实现 Data 360 = 统一画像 + 干净数据 + 实时 + 零拷贝 + 可自定义 RAG;
- NTO 的示例展示了每个支柱在具体客户场景中的价值。
接下来:连接数据源并转换数据后,您就可以设置检索增强生成(RAG),并探索 AI 护栏与分析能力了。
二、用 Data 360 打造可信的 Agent
探索可信 Agent 的重要性
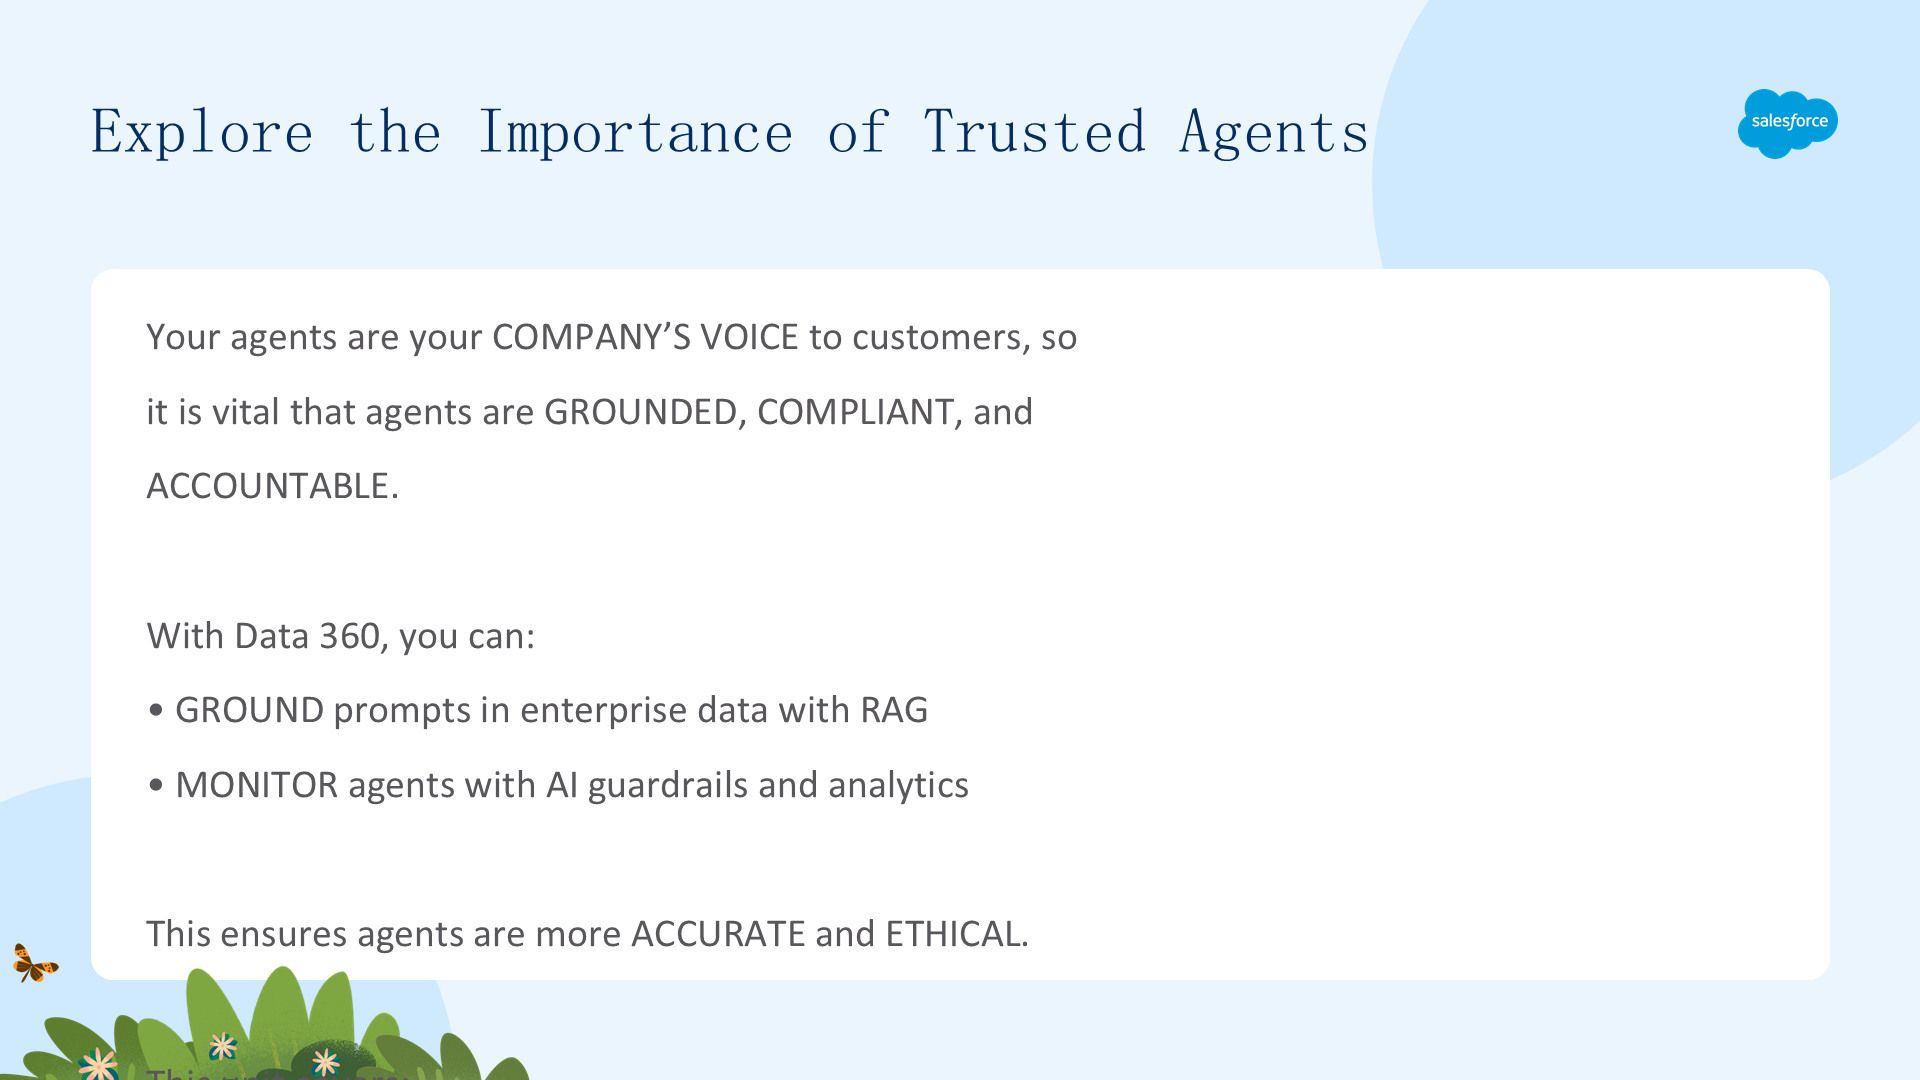
Agent 是您公司面向客户的声音,因此让 Agent 有据可依(grounded)、合规(compliant)、可问责(accountable)至关重要。借助 Data 360,您可以用 RAG 将提示词扎根于企业数据,并用 AI 护栏和分析来监控 Agent。
这确保了您的 Agent 更准确、更符合伦理。本单元涵盖:
- 检索增强生成(RAG)——两种实现路径(快速入门 vs 高级设置);
- AI 护栏——Einstein Trust Layer + 审计与反馈追踪;
- Agentforce Analytics——监控 Agent 表现。
目标:打造您可以信任、能准确、安全、可度量地代表品牌的 Agent。
了解检索增强生成(RAG)
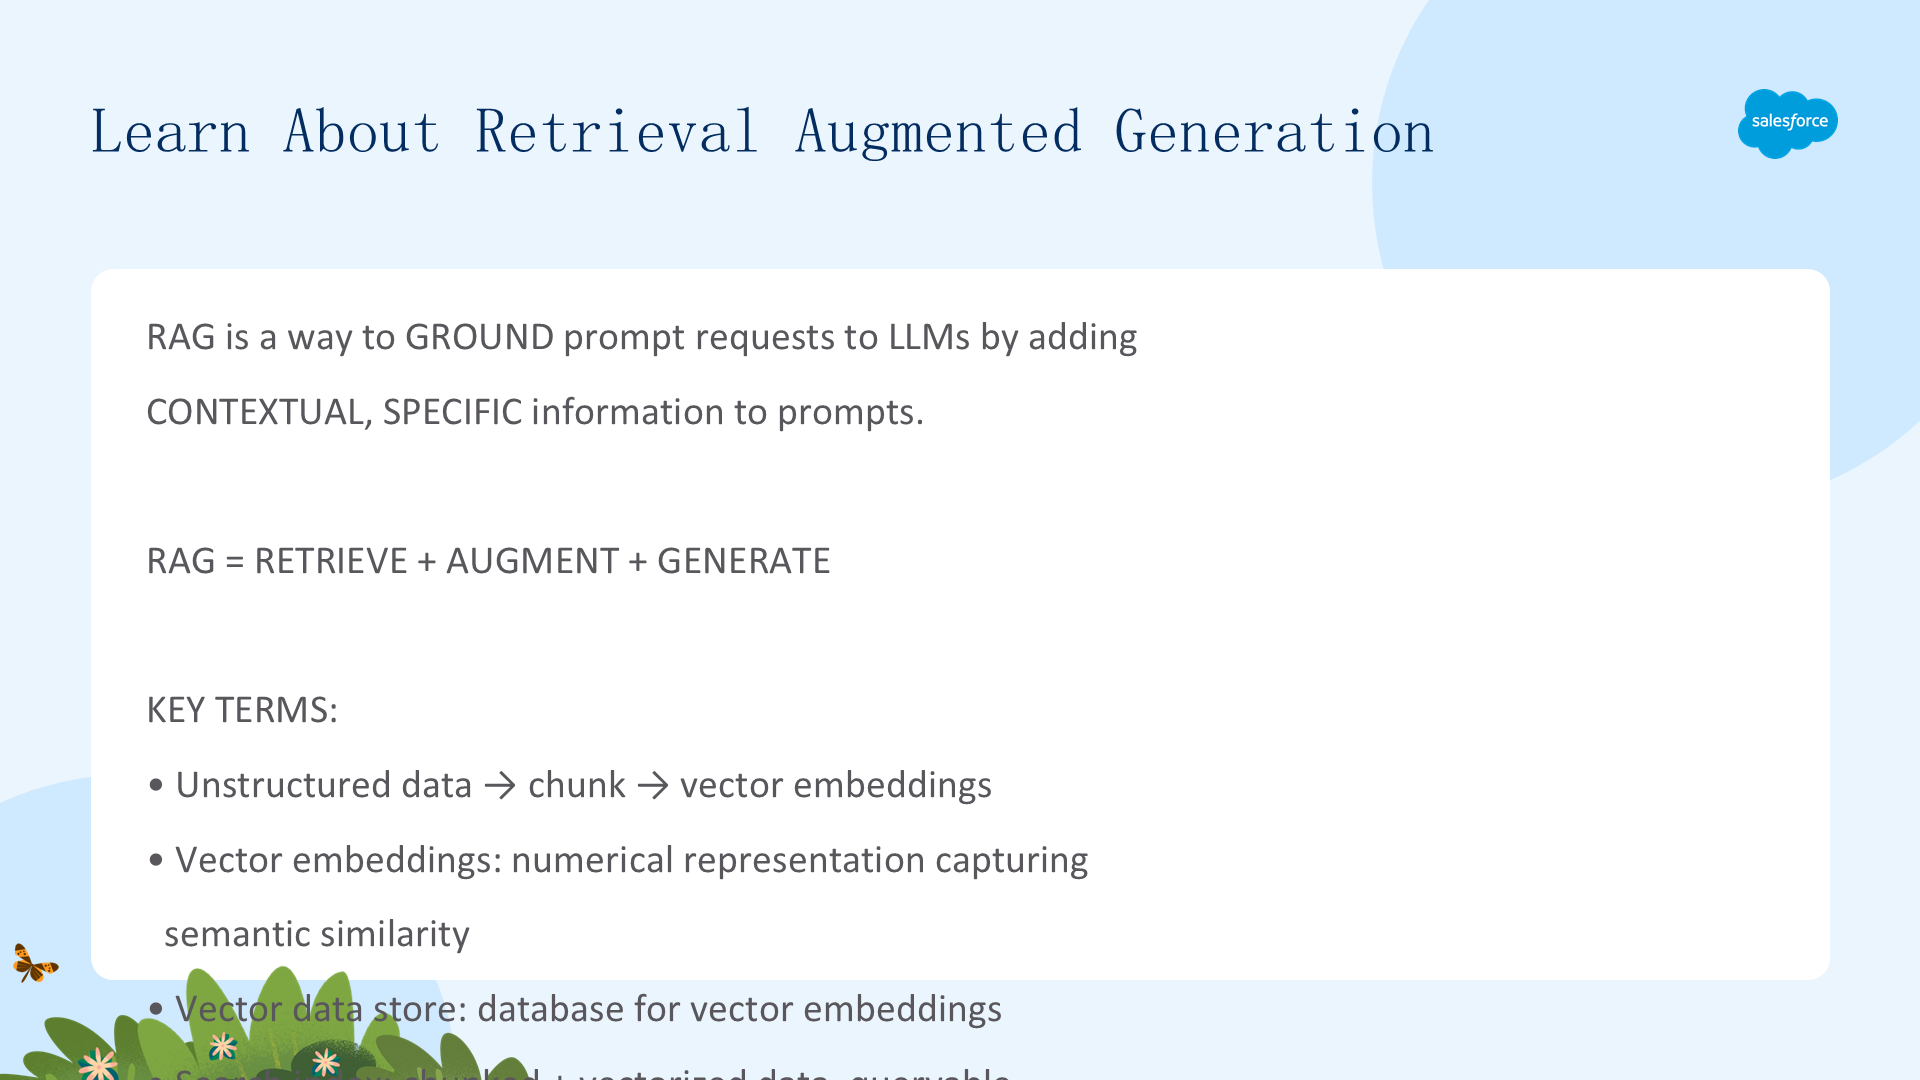
RAG 是一种将提示请求扎根(ground)到大语言模型(LLM)的方法。扎根就是在提示中添加上下文、具体的信息,以提升 LLM 生成输出的质量、准确性和相关性。RAG 包括从知识库检索(retrieve)相关信息、将这些信息与原提示结合来增强(augment)提示、最后生成(generate)响应。
理解 RAG 的几个关键术语:
- 非结构化数据:没有特定一致格式、难以存入传统关系型数据库的数据;摄取后需先分块(chunk)再创建向量嵌入;
- 向量嵌入(vector embeddings):机器可读的非结构化数据数值表示,能衡量不同文本的语义相似度;
- 向量数据存储(vector data store):专门存储向量嵌入的数据库;
- 搜索索引(search index):存储已分块、已向量化数据、可被其他应用搜索检索的数据结构;
- 检索器(retriever):连接提示与搜索索引的桥梁,在数据源中搜索相关信息来增强提示;集成检索器(ensemble retriever)是多个检索器的集合,可并行从多个来源搜索。
为 Agent 实现 RAG 有两条路径:快速入门用 Agentforce Data Library,或高级设置在 Data 360 中自定义。下面逐一介绍。
Data 360 已启用:探索 Agentforce 数据图书馆
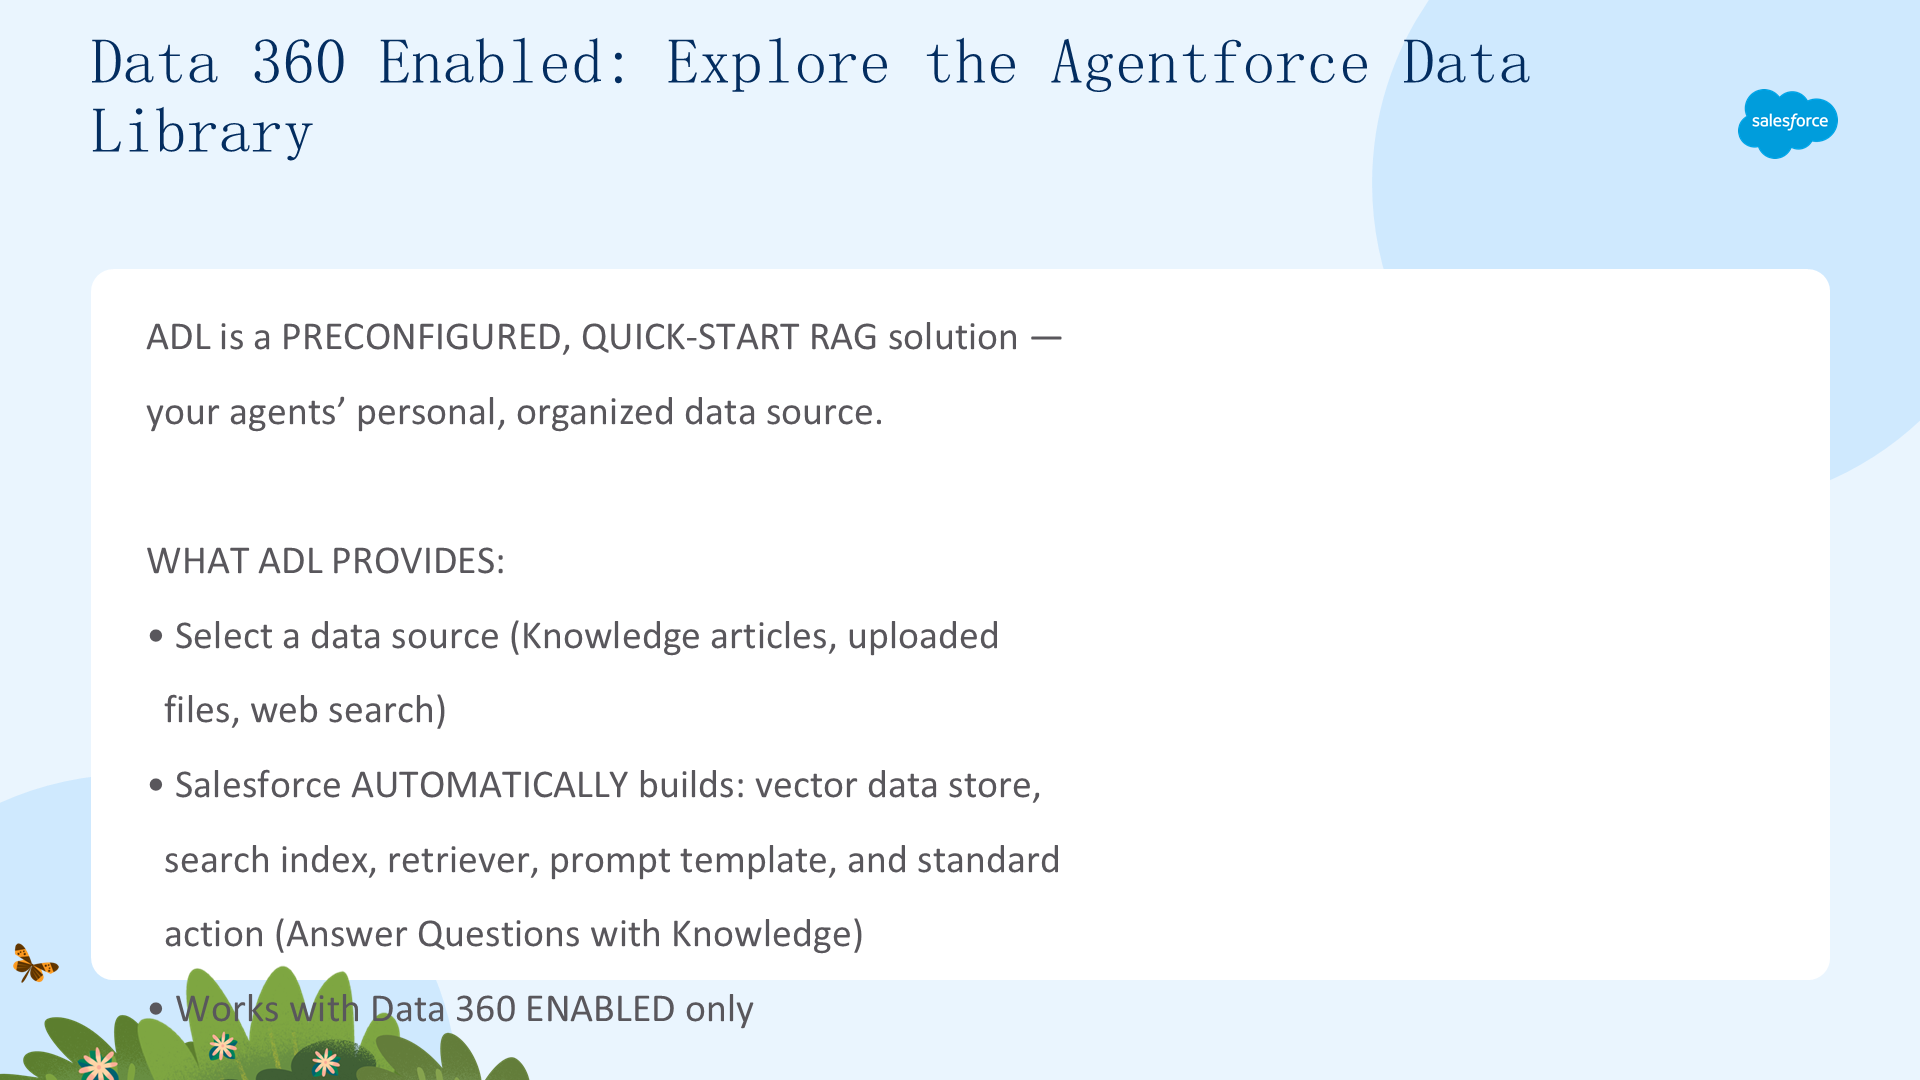
Agentforce Data Library(ADL)是一个预配置、快速入门的 RAG 解决方案,是您 Agent 的个性化、有组织的数据源。
当您在 Agentforce Builder 或 Setup 中添加数据图书馆时,Salesforce 会自动用 Data 360 构建一个 RAG 驱动的解决方案,并为所有组件(向量数据存储、搜索索引、检索器)使用默认设置;您也可以单独设置和自定义这些组件。
ADL 仅支持非结构化数据,例如:
- 知识文章(Knowledge articles);
- 文件(Files);
- 网页搜索(Web search)。
ADL 的局限:每个数据图书馆只能包含一个数据源,不具备实时和零拷贝能力,非 CRM 数据必须下载为文件后再添加到数据图书馆。ADL 是 RAG 的声明式、低代码入口,最适合快速见效、直接的知识检索场景。
Data 360 已实现:用 Data 360 完全自定义 RAG
直接在 Data 360 中实现 RAG 需要更多时间,但能让您对数据摄取和处理、更多样的数据源、以及更精确的检索机制(如混合搜索 hybrid search)拥有更大的控制权。
高级设置可将提示扎根于任何已进入 Data 360 的数据:例如摄取含非结构化长文本字段的 CRM 记录并分块,然后创建向量数据存储和搜索索引,用检索器扎根提示。您可以给 Agent 访问已整合的、零拷贝的、实时的数据,无论结构化还是非结构化。
用数据图谱实现 RAG:数据图谱(data graph)记录以 JSON 字符串的形式提供相关数据的扁平化视图,可被快速检索。例如,创建一个对客户画像与销售订单明细之间关系建模的数据图谱,用它扎根 Agent 的提示。主要好处:
- 通过零拷贝集成多个来源的数据(含 CRM 数据和外部湖数据),无需创建集成检索器;
- 将数据转换为 JSON 格式,保持关系数据且易于被 Agent 理解。
ADL 与自定义 Data 360 设置对比:ADL 仅需启用、设置快、只支持非结构化数据、单数据源、无实时/零拷贝;自定义 Data 360 设置需要实现、更复杂,但支持结构化+非结构化、通过集成检索器或数据图谱集成多源、支持实时与零拷贝,并通过 Data Cloud One 连接将检索器同步到配套 org。高级设置 = 对 RAG 管线的完全掌控。
Data 360 已启用:用 AI 护栏保障安全
AI 需要护栏(guardrails)来保护数据安全并让人始终参与其中,从而确保 AI 的使用符合组织的安全、隐私、监管与 AI 治理政策。
Agentforce 的护栏包括 Einstein Trust Layer 和生成式 AI 审计与反馈追踪,这些功能都由 Data 360 驱动(Agentforce 还有自身内置的护栏)。
- Einstein Trust Layer:通过零数据保留、毒性检测、安全数据检索、动态扎根等机制保护客户数据,提升输出的安全性与准确性。
- 生成式 AI 审计与反馈追踪:记录提示 ID、用户数据、提示文本(PII 脱敏)、安全/毒性评分,并通过 Feedback API 记录点赞/点踩、接受/重新生成/修改、修改后的最终响应等反馈。
探索 Einstein 信任层
Einstein Trust Layer 通过稳健的安全特性和护栏保护客户数据,其核心保护包括:
- 零数据保留(Zero Data Retention)——提示和数据不会被 LLM 提供商存储,也不会被用于训练模型;
- 毒性检测(Toxicity Detection)——筛查用户输入和 AI 输出中的有害、偏见或不恰当内容;
- 安全数据检索(Secure Data Retrieval)——确保 Agent 只访问用户被授权查看的数据,尊重所有 Salesforce 安全模型;
- 动态扎根(Dynamic Grounding)——在运行时检索最新、最相关的数据,而非依赖过时或缓存的信息。
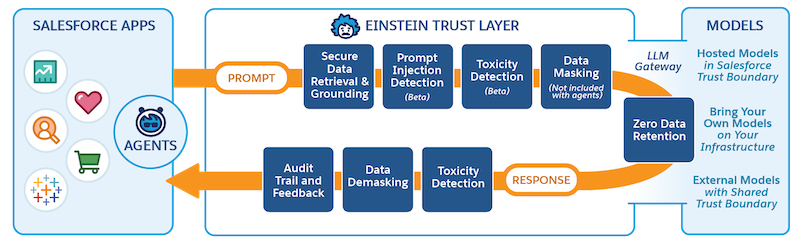
Trust Layer 透明地运行——用户和管理员无需配置它,它对所有 Einstein 生成式 AI 功能默认开启,并自动应用于每一次 Agent 交互。
生成式 AI 审计与反馈追踪
审计追踪(audit trail)提供追踪 AI Agent 动作和输出所需的数据,这些数据在 Data 360 中存储和分析:
- 提示 ID 和用户数据;
- 提示文本及 PII 脱敏后的提示;
- 安全与毒性评分。
您可以通过 Feedback API 记录对 Agent 响应的反馈:
- 点赞 / 点踩反应及原因文本;
- 接受、重新生成、修改、拒绝或忽略等动作;
- 修改后的最终响应。
这形成了一个完整的反馈闭环:监控 Agent 说了什么、识别负面反馈模式、基于真实使用数据改进提示与知识库,并向审计人员展示每次 AI 交互的时间戳记录以证明合规。这让 AI 从一个黑盒变成可审计的系统。
探索 Agentforce Analytics
Agent 部署后,用 Agentforce Analytics 监控其表现。数据在 Data 360 中存储和处理,并用 Data 360 的仪表板和报表展示结果。
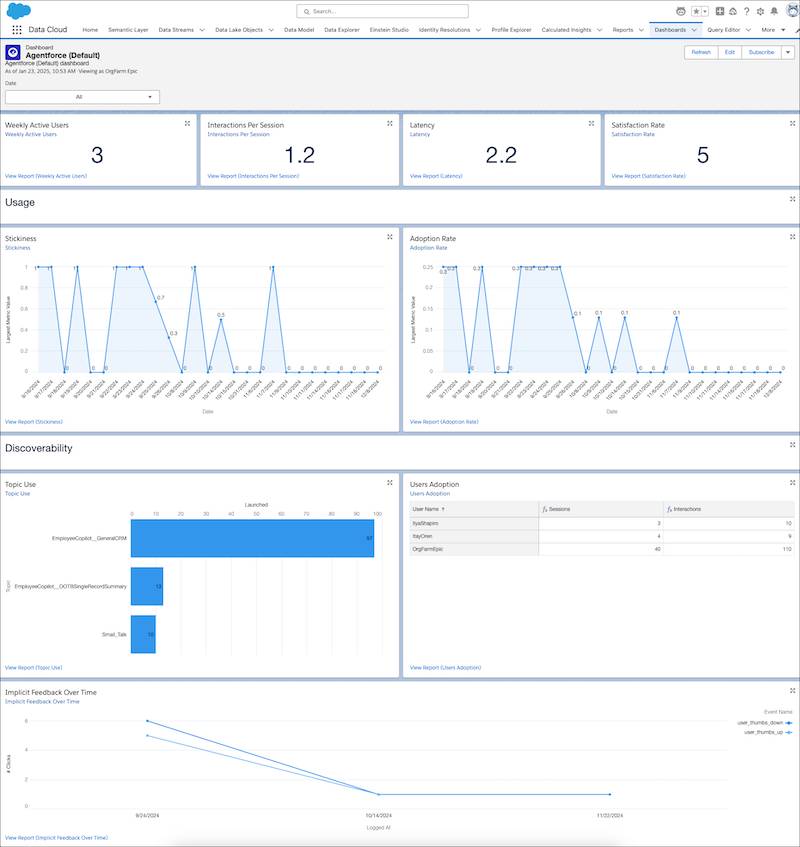
预置的洞察仪表板包括以下数据:
- 数据脱敏(data masking);
- 响应中的毒性(toxicity);
- 用户趋势(user trends);
- 接受率(acceptance rates)。
您也可以构建自己的自定义仪表板,针对组织特定的 KPI 和监控需求。Agentforce Analytics 让您看清 Agent 的表现——哪些有效、哪些需要改进、优化工作应聚焦在哪里。
Data 360 已启用 vs. 已实现
总结一下启用与实现 Data 360 的特性差异。
仅启用 Data 360:
- 对客户的视图有限,每个数据源彼此割裂;
- 通过 Agentforce Data Library 实现 RAG 扎根提示;
- 借助 Einstein Trust Layer 获得可信、安全的 AI;
- 通过生成式 AI 审计与反馈追踪实现可信、人工监控的 AI;
- 通过 Agentforce Analytics 获取洞察。
启用并实现 Data 360(拥有启用的全部好处,外加):
- 跨所有数据源的转换后、统一的数据;
- 实时数据能力;
- 存储在外部系统(如数据湖)中的零拷贝数据;
- 通过计算洞察和 AI Models(原 Einstein Studio)的预测式 AI 增强数据;
- 通过高级 Data 360 设置实现更强大的 RAG 扎根提示(结构化+非结构化、集成检索器、数据图谱、混合搜索)。
启用让您「入场」,实现则让您「赢得比赛」。
本单元小结
现在您了解了 Data 360 启用与实现给 Agentforce 带来的不同好处,也了解了 Data 360 如何用统一数据、RAG、AI 护栏和分析为 Agentforce 能力提供动力。
- 启用 = 前提;实现 = 充分释放能力;
- RAG 有两条路径:ADL(快速)与 Data 360 设置(高级、可自定义);
- Einstein Trust Layer + 审计追踪 = 可信、可问责的 AI;
- Agentforce Analytics = 对表现的可见性。
接下来:跟随 NTO 的企业架构师 Pia,学习如何为 Agentforce 完整实现 Data 360,走完从数据到 Agent 的全程。
三、为 Agentforce 实现 Data 360
了解数据需求
在实现 Data 360 之前,需要先理解项目的数据需求。以下数据准备步骤和需要考虑的问题有助于理清思路:
- 确定用例需要什么数据、定义数据类型——需要 CRM 记录(如线索、案例)吗?需要非结构化还是结构化数据?需要上传文件吗?
- 定位数据来源、确定如何连接到 Data 360——CRM 记录目前在哪个 org?数据在外部数据仓库中吗(若是,则需使用零拷贝数据联邦连接器)?需要实时访问该数据吗?
- 梳理数据处理需求——数据有质量问题吗?是哪种、是否普遍?需要统一数据吗(即运行身份解析将其关联到统一画像)?
在开始配置之前回答这些问题,可以避免返工,并确保您的 Agent 拥有正确的数据。
为 Agent 配置 Data 360
NTO 想构建一个能回答产品问题的 Agent,计划用高级 Data 360 RAG 扎根提示。跟随 NTO 的企业架构师 Pia,从数据准备开始配置 Data 360 并构建 Agent。
Pia 的数据准备步骤:
- 在 org 中启用并开通 Data 360,设置 Data 360 用户;
- 在 Service Cloud 中找到客户案例数据,确定其来源;
- 创建数据流,把案例数据从 Service Cloud 摄取到 Data 360,存入 Case DLO;
- 用批量数据转换解决名称和格式不一致等数据问题,转换后的数据存入 Cleaned Case DLO;
- 在 Cleaned Case(DLO)与 Case 数据模型对象(DMO)之间添加映射;
- 创建并运行身份解析规则集,把案例与客户的统一画像关联起来。
现在 Pia 能了解每个案例的更多上下文——例如「裤子 1068 太短」的案例来自身高 170cm 的 Rachel Rodriguez,「裤子 2000 太长」的案例来自身高 165cm 的客户。这些上下文将帮助 Agent 给出更相关、更有效的答案。
Pia 的 RAG 设置:
- 从 Case DMO 和 Unified Individual DMO 分别创建搜索索引(Data 360 会为每个索引自动创建检索器);
- (可选)创建一个集成检索器;
- 创建一个提示模板,调用检索器,用案例数据和统一画像回答产品问题。
数据准备就绪、RAG 配置完成,Pia 就可以构建 Agent 了。
构建并部署 Agent
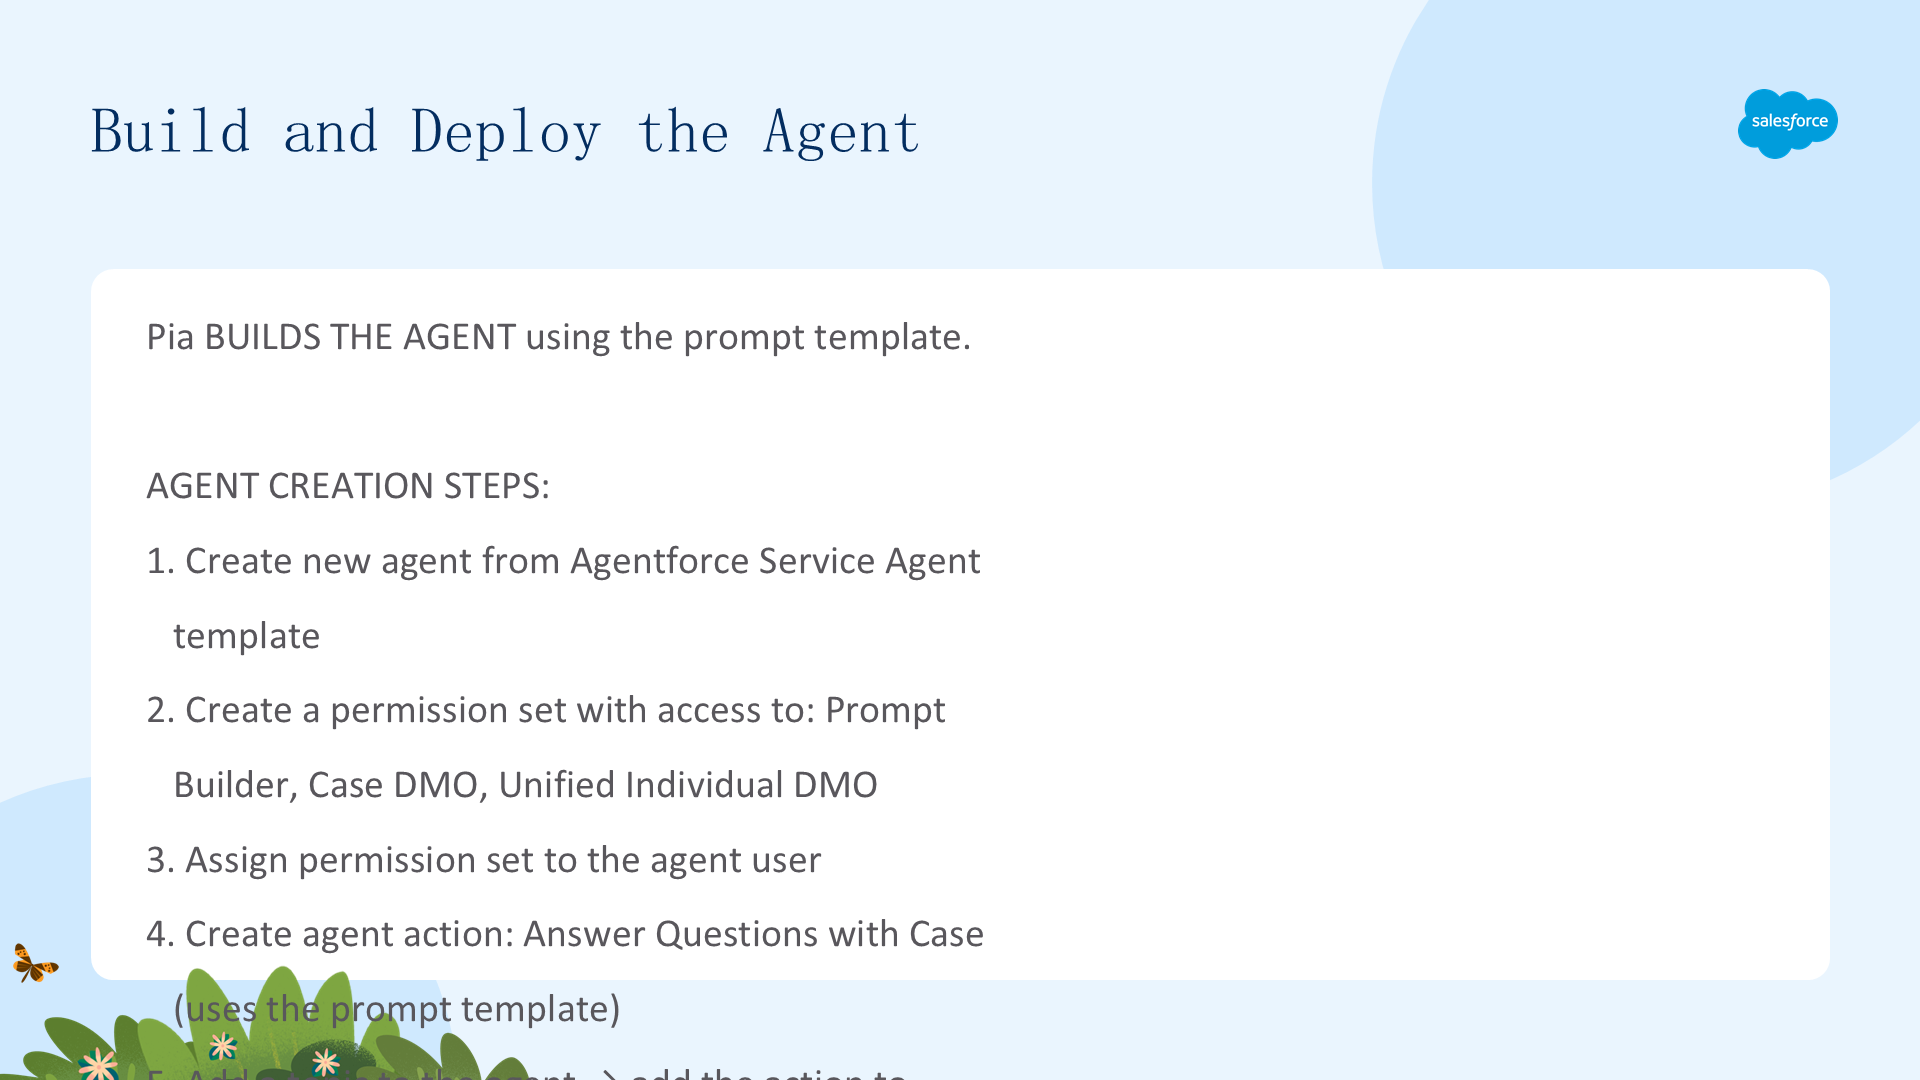
Pia 使用提示模板构建 Agent:
- 从 Agentforce Service Agent 模板创建新 Agent;
- 创建一个权限集,包含对 Prompt Builder、Case DMO 和 Unified Individual DMO 的访问权限,并分配给 Agent 用户;
- 创建名为 Answer Questions with Case 的 Agent 动作,使用该提示模板;
- 为 Agent 用户添加一个主题(topic);
- 把 Answer Questions with Case 动作添加到该主题;
- 激活并测试 Agent。
测试示例:Pia 问 Agent:「我腿很长,身高 170cm,你推荐或不推荐哪些裤型?」Agent 回答:「身高相近的客户反馈 1068 款太短,2000 款更长。我推荐 2000 款,不推荐 1068 款。」
Agent 利用统一画像数据(身份解析得到的客户身高)给出个性化、上下文感知的推荐——这正是「通用 FAQ 机器人」与「智能 Agent」的区别。
经过几轮测试和提示微调后,NTO 将 Agent 部署到客户渠道。部署后,团队持续遵循这些最佳实践:
- 监控审计追踪并对 Agent 给出反馈;
- 编辑提示以处理关键反馈;
- 用 Agentforce Analytics 仪表板监控表现;
- 更新 RAG 实现,让 Agent 的数据源保持最新。