一、为 Headless 功能准备你的数据(Prepare Your Data for Headless Functionality)
学完本单元,你将能够:解释什么是数据基础(data foundation)以及它如何支撑可靠的 headless 工作流;描述 Salesforce 元数据如何为工具和调用者提供内置上下文;识别审计元数据、配置集成用户、在 Setup 中启用 Model Context Protocol(MCP)服务器所需的管理员和开发者清单。
工具已就绪,你的数据呢?(The Tools Are Ready. Is Your Data?)
Salesforce 的 AI 原生工具——如 Agentforce Vibes、Cursor 或 Claude——让你无需切换到浏览器 UI,就能探索 org、完成日常任务、自动化工作流和排查问题。AI 代理以程序化方式处理其中许多操作,并在需要时弹出 UI。
这种灵活性很强大,但它改变了在任何工具连接之前、你的数据需要呈现的样子。你无需成为开发者就能构建坚实的数据基础——这些工作很熟悉:干净的元数据、清晰的权限、审慎的配置。
代理要可靠行动所需的上下文——待处理的升级、续约日期、SLA 状态、关系历史——花了很多年才在你的 org 中积累起来。一个干净的元数据基础,让这些上下文无需为每个界面重新创建,就能提供给已连接的工具。Headless 能力让你的业务上下文(包括数据、工作流和治理)在受支持的界面间可用,帮助代理在遵守你配置的安全与治理控制的同时,访问当前可信的信息。
作为对比:在浏览器中工作时,页面布局、字段标签和工具提示提供视觉上下文——一个工具提示会解释像 STAT_3 这样的 picklist 值。程序化调用者没有这层视觉层,它们依赖可用的 schema 元数据(包括对象描述、字段标签和 picklist 值)来解读你的数据模型并识别相关字段。
没有清晰的对象描述、字段标签和明确的 picklist 值,工具就无法解析字段定义,也无法推断你的业务上下文。干净的元数据基础确保外部工具以可预测、准确的方式与你的 org 交互。连接工具只需最小努力,但坚实的基础需要真正的功夫。
什么是数据基础(What Is a Data Foundation?)
当 AI 模型直接指向没有受治理数据基础的原始数据库表时,问题会迅速成倍出现:每个用户都各自生成自己的同一工作流版本;流程变得不一致;AI 做出本应由你的业务规则做的判断;治理消失。
正确的做法是把业务逻辑保留在 Salesforce 域内——数据被治理、统一,并为代理的行动做好准备。这就是数据基础所提供的东西。一个强大的数据基础结合了五项能力。
数据基础的五大能力(The Five Capabilities)
主数据管理(Master Data Management,MDM)为每个实体分配一条权威记录。Salesforce Data 360 在你的客户档案上处理原生身份解析(identity resolution)——把跨系统的记录匹配到单一权威档案;而 Informatica MCP Server 把企业级的主数据管理和去重扩展到 Salesforce 之外。
数据质量(Data Quality)确保完整性、准确性和新鲜度,让你的程序化工具始终基于可靠的输入行动。Informatica MCP Server 直接来自 Informatica Intelligent Data Management Cloud(IDMC),提供健壮的数据质量、血缘(lineage)和卫生检查。
数据集成与联邦(Data Integration and Federation)连接你分散的系统,让工具能访问企业数据所在的任何地方。Data 360 使用零拷贝联邦(zero-copy federation)——在原地查询数据而无需把它复制进 Salesforce——来查询你的数据仓库和超大规模云平台(如 AWS、Azure 和 Google Cloud),无需移动记录。MuleSoft MCP Server 把你现有的企业 API 和集成直接暴露为 MCP 工具。
治理(Governance)定义谁能看到你的数据,并执行访问与合规规则。Salesforce Platform 执行字段级安全(FLS)、共享规则和基于角色的访问控制(RBAC),而 Data 360 增加自动化打标(tagging)和动态脱敏(dynamic masking)。如果你运行的服务没有配置治理,它就会以无治理访问的方式运行——未经脱敏地暴露敏感字段。你必须显式配置治理,它永远不会自动发生。
数据目录(Data Catalog)提供一个结构化索引,帮助调用者在运行动作之前发现并读取你的业务资产。Headless 360 MCP server 建立在 MCP 之上——一个定义 AI 工具如何与外部平台通信的开放标准——它今天通过 Discover 和 Describe 工具提供这一能力,让调用者基于你的 org schema 和元数据建立上下文。
这五项能力共同产出一个成熟、可靠的数据模型——一幅结构化、一致的业务图景,任何工具都可以安全地查询和操作。数据基础通过三大核心支柱来解决这一模型:元数据与上下文 Grounding、Data 360 和 跨云 MCP。本单元讲解第一根支柱。
元数据:你 org 内置的 Grounding 层(Metadata: Your Org’s Built-in Grounding Layer)
你 Salesforce org 中的每个对象和字段都携带元数据——标签、描述、帮助文本和关系定义。例如,Account 对象包含一个标签(Account)、一段关于它在业务中代表什么的描述,以及 Industry、Annual Revenue 等字段——每个都有自己的标签和描述。
当工具通过 Salesforce MCP 服务器连接时,Salesforce 会暴露可用的 schema 元数据,如对象和字段标签、描述、数据类型、picklist 值和关系。这些元数据帮助工具识别相关对象和字段,用于诸如汇总记录、查找相关数据和草拟回复等任务。清晰、准确的元数据能改善解读,但它不能替代验证规则、自动化、权限和应用逻辑——这些才是治理你组织如何运作的东西。问题只在于你是否把它维护得足够好、足够有用。
代理如何读取你的元数据(How Agents Read Your Metadata)
当代理通过 Headless 360 MCP server 连接到你的 org 时,它不会一上来就运行查询或采取行动——它先读取你 org 的结构。
为了理解你的 org 数据模型,代理在查询数据或采取行动之前,可以使用两个元数据工具:
- Discover:返回你 org 中可用对象的列表,包括它们的 API 名称、标签和描述。代理用这个列表来理解你的 org 包含什么,并识别与当前任务相关的对象。
- Describe:返回某个特定对象的细节——每个字段的 API 名称、标签、数据类型、描述、picklist 值,以及与其他对象的关系。代理用这些上下文把用户请求映射到正确的字段并采取准确的行动。
这些工具返回认证用户可用的 schema 元数据。结果反映你配置的标签、描述、字段、picklist 值、关系和访问权限——但不提供通过验证规则、Flow、Apex 代码和其他自动化实现的每一条业务规则或行为。
元数据质量如何支持代理解读(How Metadata Quality Supports Agent Interpretation)
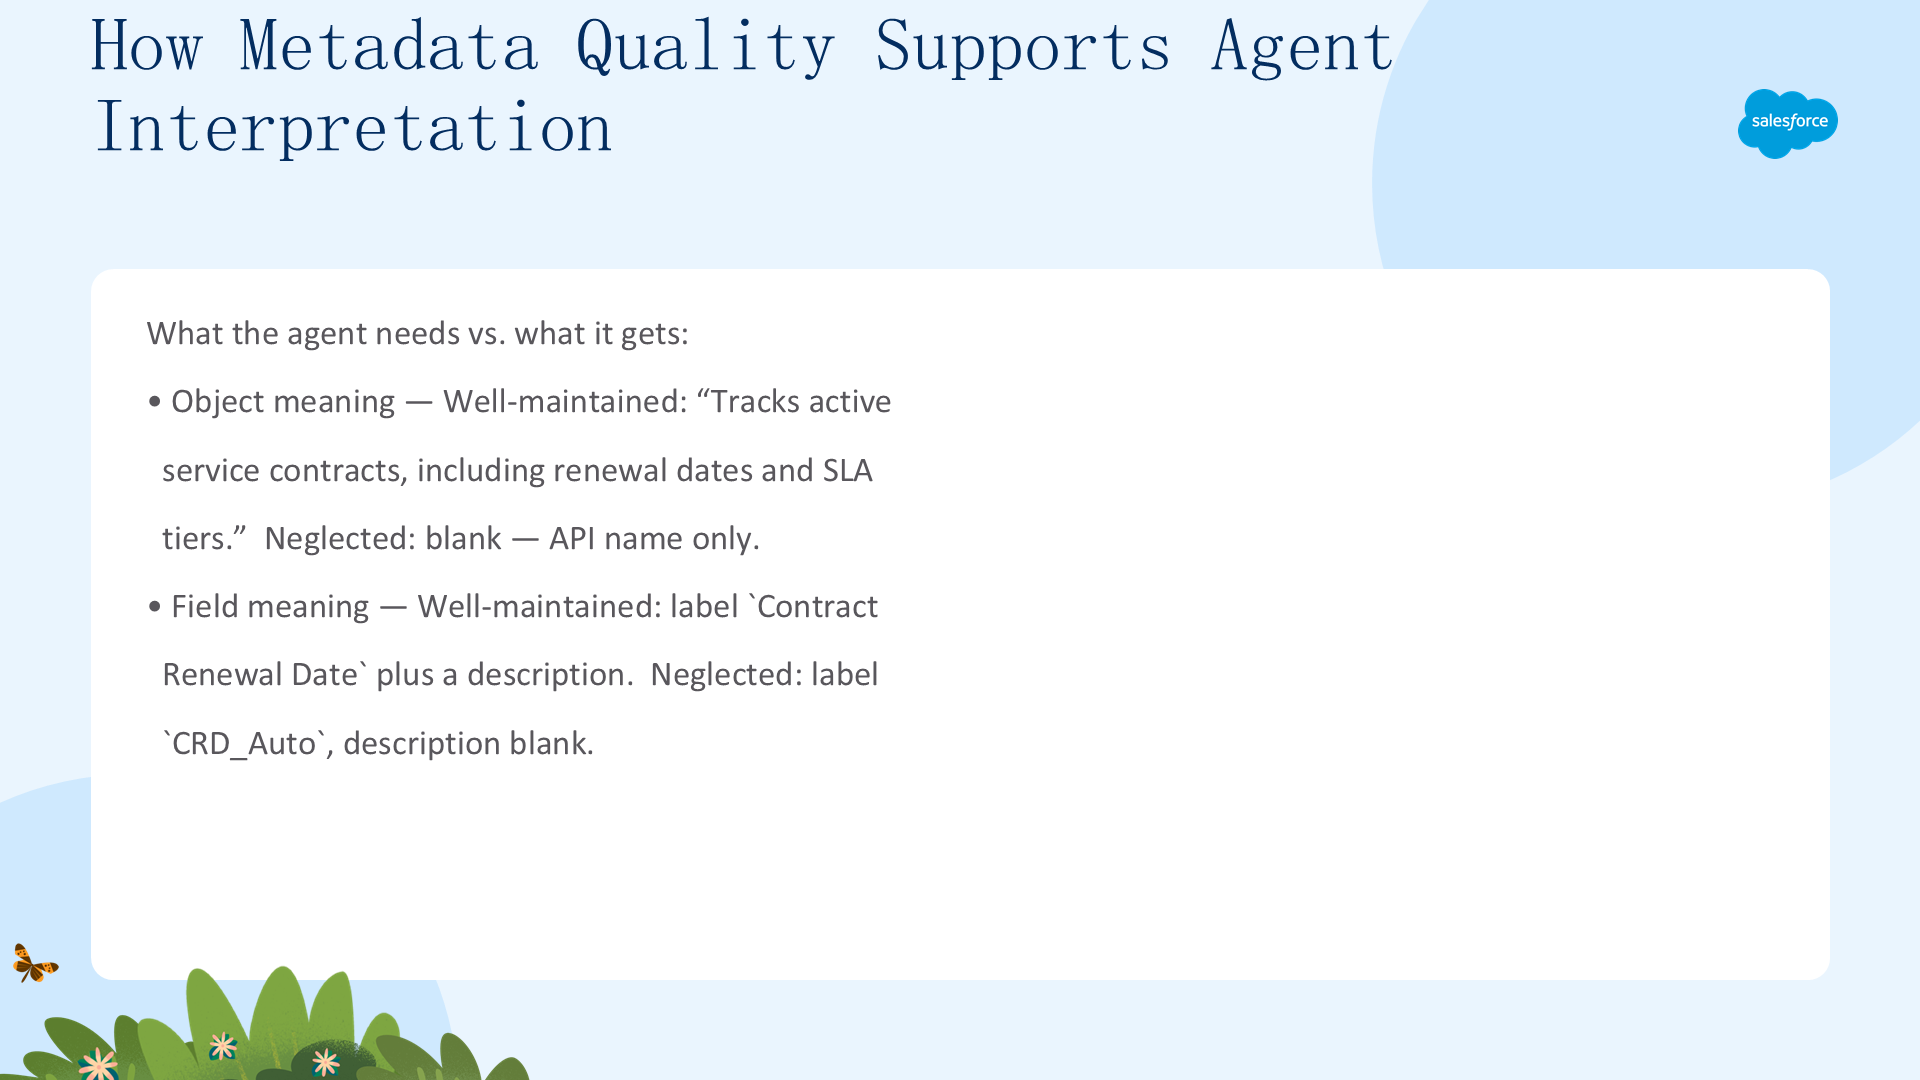
这一对比是本单元的核心。以「这个对象代表什么?」为例:维护良好的元数据下,代理会读到「追踪企业账户的活跃服务合同,包括续约日期和 SLA 层级」这样的对象描述;而被忽视的元数据下,该字段是空白的,代理只能看到 API 名称。
「这个字段是什么意思?」维护良好的给出字段标签 Contract Renewal Date 加一段描述(该合同可续约的日期,用于触发自动续约工作流);被忽视的则给出 CRD_Auto 这样的标签、描述空白。
「我该选哪个 picklist 值?」如果你的值是遗留代码,代理就没有任何选择依据。清晰的元数据是「理解你 org 的代理」与「靠猜的代理」之间的分水岭。
保持元数据整洁(Keep Your Metadata Clean)
干净的元数据帮助外部工具无缝定位正确的字段;混乱的元数据迫使程序化调用者去猜测,导致硬性中断或不准确的操作。在工作流上线之前,从高流量对象开始、向外审计你的 org 元数据基础。
关于审计标准:元数据层只暴露你 org 里实际存在的东西。如果你把字段描述留空,服务器只会返回开发者 API 名称,别无其他。例如,一个搜索 revenue 的调用者,如果你不提供描述性标签,就无法把该概念关联到名为 Opp_Rev_Adj_Q3 的字段——这不是模型失败,而是元数据失败。
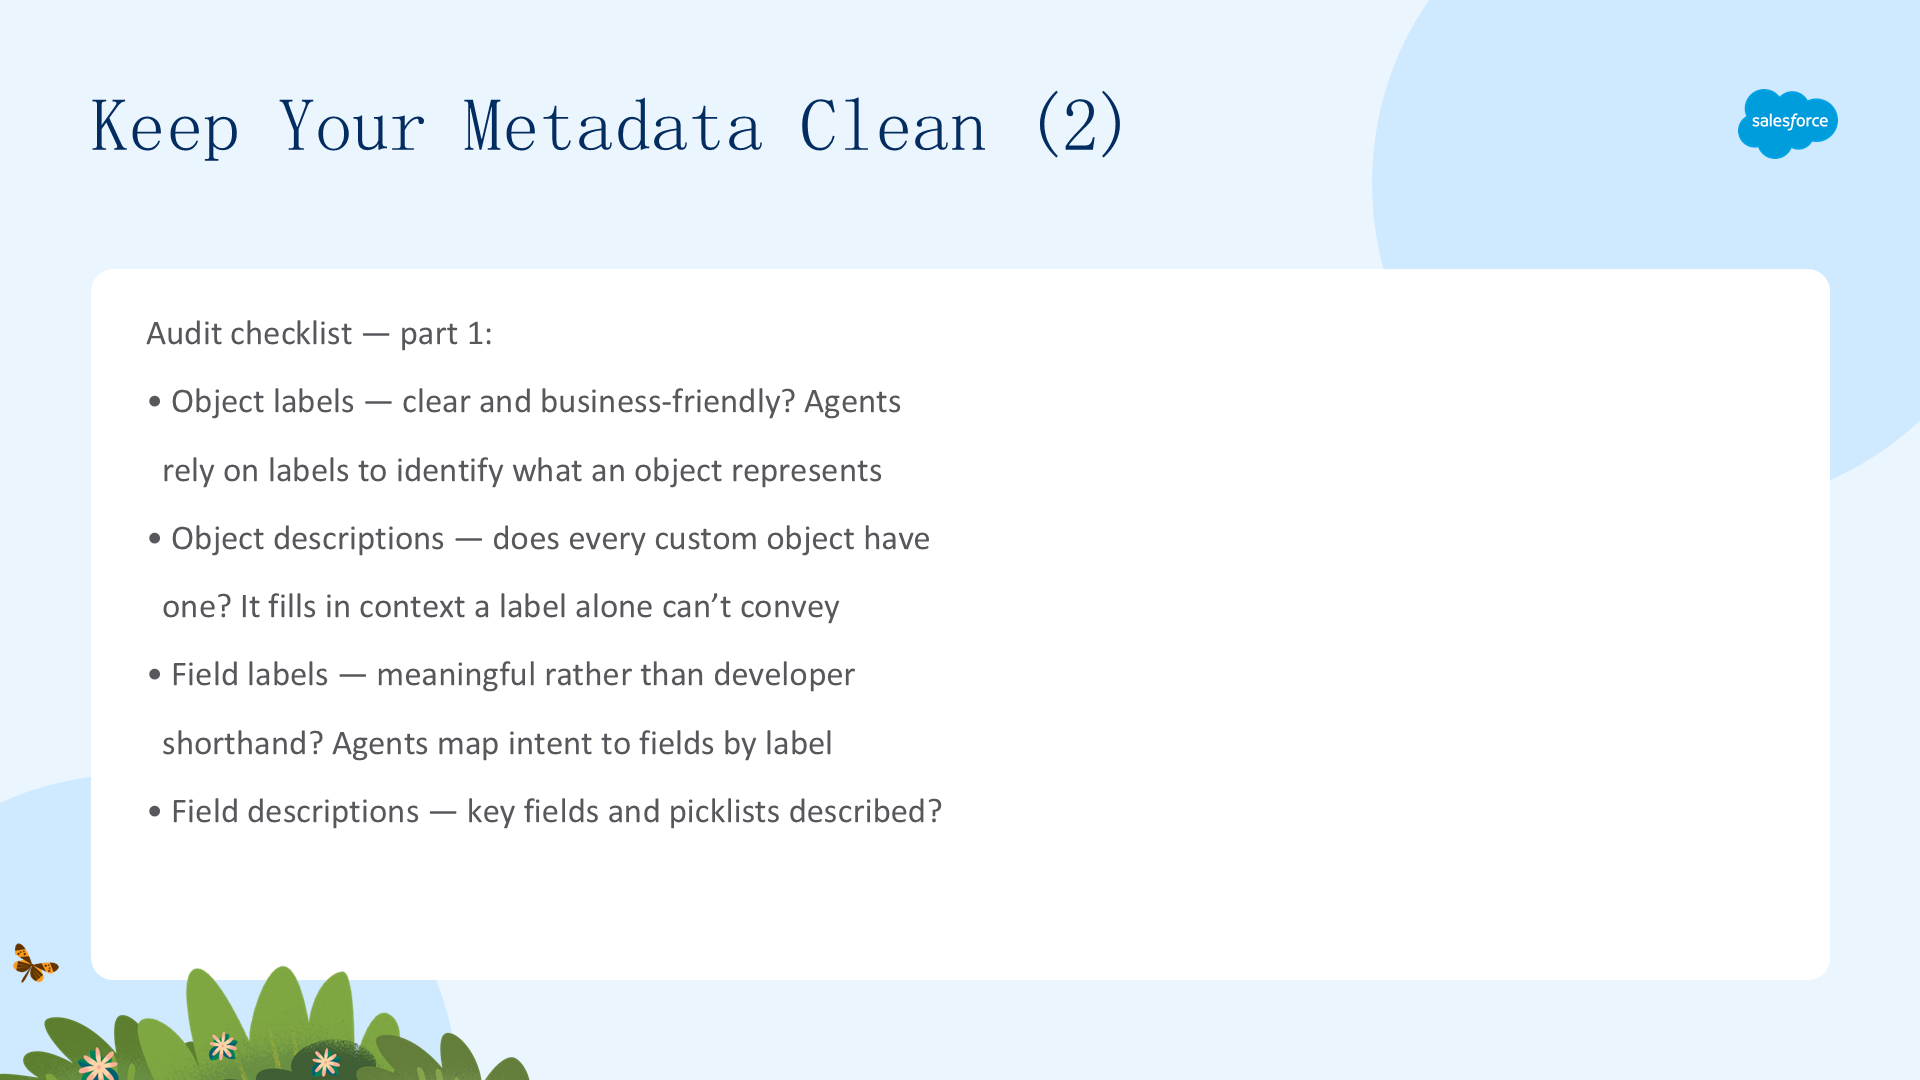
上线前要运行的清单,前四项:
- 对象标签(Object Labels):你的自定义对象标签是否清晰、对业务友好?代理依赖标签来识别对象代表什么。
- 对象描述(Object Descriptions):你 org 中每个自定义对象是否都有详细描述?它补充了单靠标签无法传达的关键业务上下文。
- 字段标签(Field Labels):你的字段标签是否有意义,而非开发者简写?代理用人类可读的标签把用户意图映射到具体字段。
- 字段描述(Field Descriptions):你是否描述了关键字段——尤其是自定义字段和 picklist?这帮助代理理解字段的用途、业务逻辑和有效值。
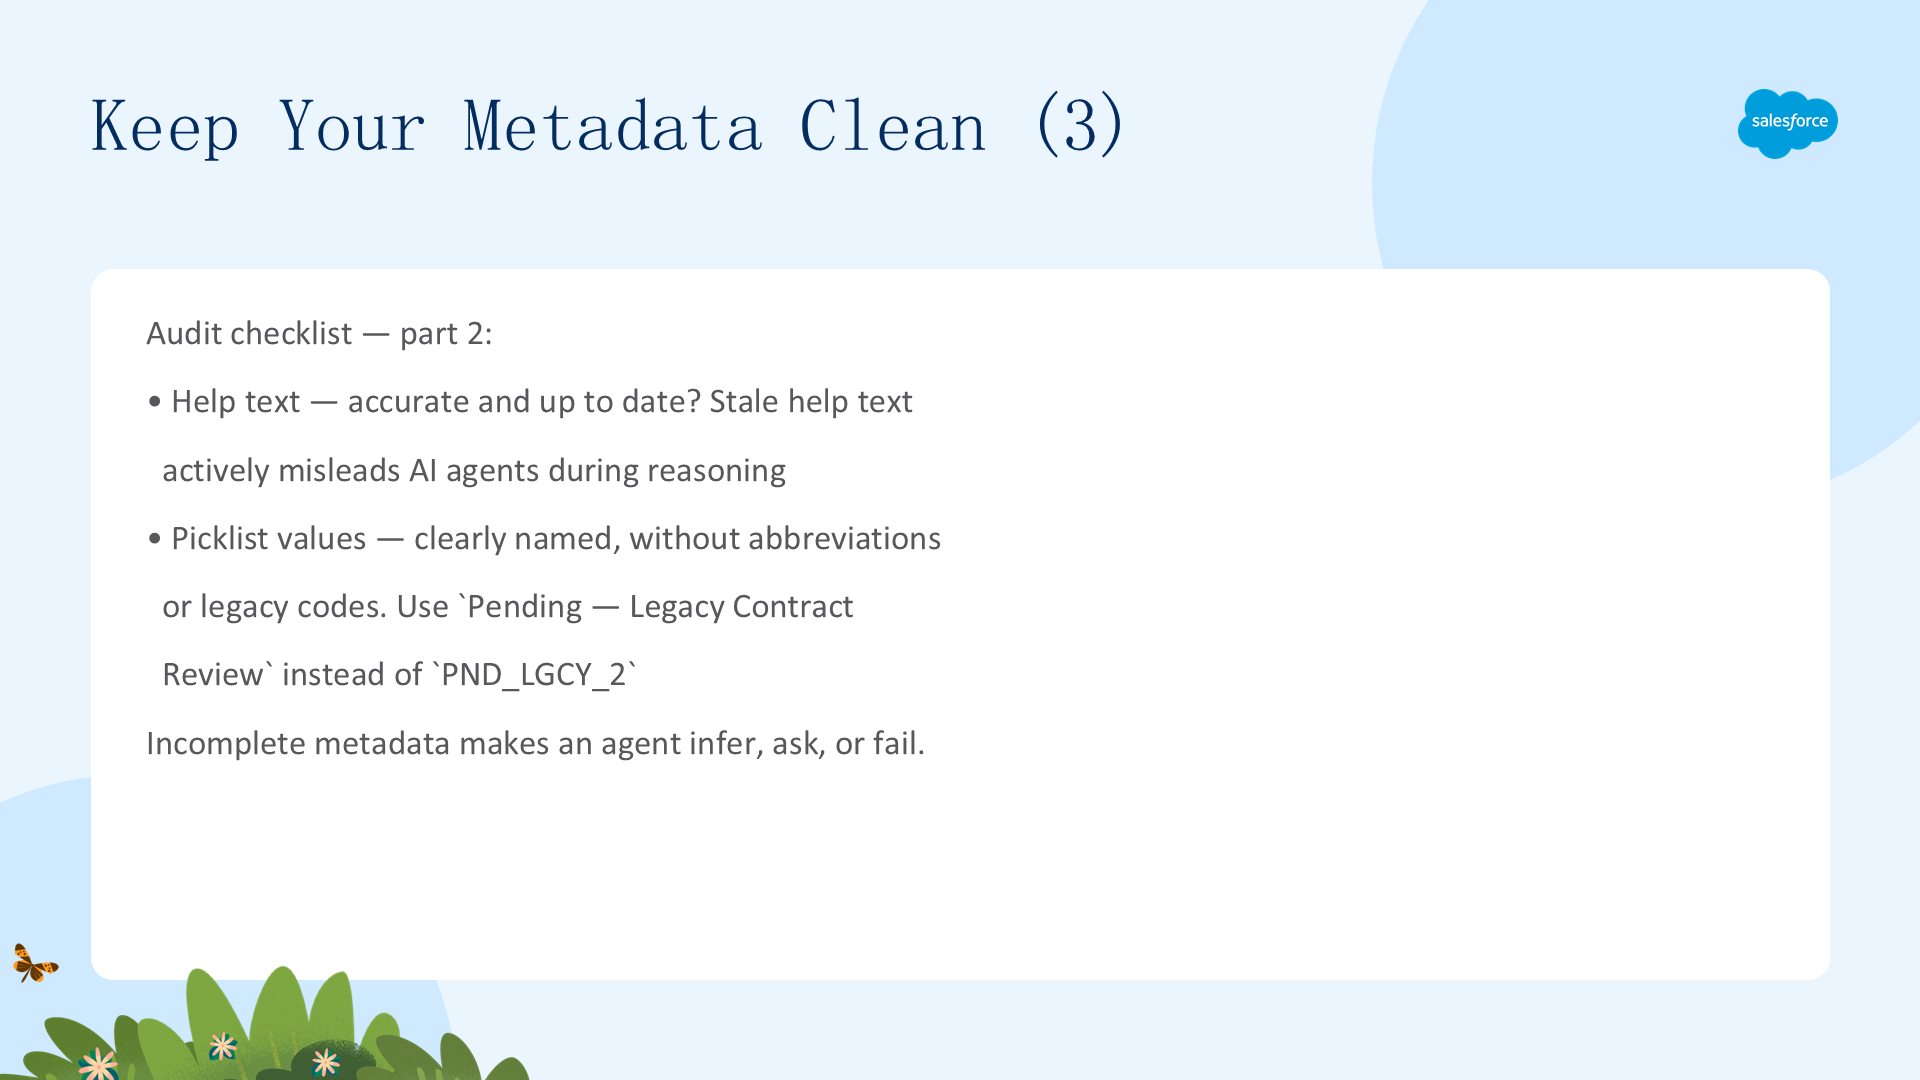
清单的后两项:
- 帮助文本(Help Text):是否准确、最新?过时或遗留的帮助文本在推理过程中会主动误导 AI 代理——这比没有帮助文本更糟,因为代理会把它当作权威。
- Picklist 值:是否命名清晰、没有缩写或遗留代码?调用者基于显式名称选择 picklist 值,例如用
Pending — Legacy Contract Review而不是PND_LGCY_2。
当元数据不完整时,代理可能会推断意图、请求澄清,或无法完成动作——而未经支持的推断可能造成静默错误。维护良好的元数据层能减少歧义,但可靠的动作还取决于有效的权限、验证、自动化、错误处理和应用逻辑。
上线之前(Before You Go Live)
在连接第一个外部工具或代理之前,确认你已完成这些步骤——强大的数据基础需要审慎的准备,而不只是「激活」。
- 设置与认证:在 Setup > Salesforce Hosted MCP Servers 中激活 Salesforce Hosted MCP Server;使用 OAuth 2.0 with PKCE,配置一个带
mcp_api scope的 External Client App 用于认证。 - 集成用户:审查分配给集成用户的权限集和角色层级。
- 集成用户与权限(续):为每一个连接程序化工具的 profile 应用 FLS,以脱敏或隐藏敏感字段——这是阻止代理暴露用户不该看到的数据的控制手段。
- 元数据:在所有高流量自定义对象上审计对象标签和描述;审查关键字段(尤其是自定义字段和 picklist)的字段标签、字段描述和帮助文本;用清晰、显式的名称替换 picklist 值中的缩写和遗留代码。
- 错误处理:确认自定义 Apex 代码、Flow 和验证规则返回显式的错误字符串,而非泛化的系统异常——这样外部代理才能程序化地处理错误响应、优雅恢复,并在不失败的情况下重试。
安全是基础的一部分(Security Is Part of the Foundation)
当程序化工具连接到 Salesforce 时,它不会绕过你的安全模型——它继承与每个用户相同的 FLS、对象权限和共享规则。这一治理层正是让你的基础可信的原因。
具体而言:每一次 MCP Server 事务都以认证用户的身份运行,通过使用 mcp_api scope 的 External Client App 进行作用域限定。标准 CRUD、FLS、共享规则、profile 权限和权限集全部直接适用。所有动作都会记录在审计跟踪中,并归属到认证用户——这意味着你既保留了控制力,也保留了责任可追溯性。
接下来(What’s Next)
在下一单元,你将学习 Data 360 和跨云 MCP 如何扩展这一基础,让任何调用者获得你企业数据的完整、统一图景。元数据 Grounding 是必要的,但它只覆盖 Salesforce 内部的东西;下一单元覆盖其外部的一切。
二、为 Enterprise 级用例扩展你的数据基础(Extend Your Data Foundation for Enterprise-Scale Use Cases)
学完本单元,你将能够:解释 Data 360 如何作为 headless 工作流的「上下文系统(system of context)」;描述跨云 MCP 服务器如何把数据基础扩展到你的整个技术栈;为你的用例识别合适的数据基础方法。
超越元数据(Beyond Metadata)
在上一单元,你构建了让每个代理会话建立上下文的元数据基础。但企业数据并不都在一个 org 里——客户记录在你的 CRM,交易历史在你的数据仓库,分析数据在另一个独立系统中。当代理需要跨所有这些实时地推理、并应用治理时,光有元数据是不够的。
这就是数据基础的第二、第三根支柱登场的地方:Data 360 和 跨云连接。
Data 360:上下文系统(Data 360: The System of Context)
Data 360 是实时层,把你企业数据统一成一个单一、可信的代理上下文来源。当工具通过程序化连接调用 Salesforce 时,它命中的不是过时的快照或孤立的表,而是一个保持最新、受治理、被对账(reconciled)的活跃真相来源。Data 360 在实时更新的真相来源上交付编排的业务逻辑。
Data 360 通过以下四种关键方式驱动 headless 工作流:
- 统一你的企业数据:Data 360 使用身份解析和零拷贝联邦,把企业内结构化与非结构化数据汇聚起来而无需移动它们——你配置连接和映射,Data 360 把不同系统的记录匹配合并成一条权威客户档案。
- 实时激活:Data 360 监控事件并自动触发触发器,你不必等待批处理作业或人工报告;它在 3 分钟内交付上下文,让代理始终基于当前数据而非昨天的快照工作。
- 把 AI 建立在受治理的数据之上:你配置基于策略的治理、自动化打标和动态脱敏,每一次调用都遵守这些规则,为敏感业务信息提供健壮保护。
- 静态数据加密:Shield Platform Encryption 把保护扩展到静态的 Data 360 数据;借助自带密钥(BYOK),你控制包裹数据加密密钥的根密钥,让密钥材料在每个阶段都处于你的管理之下。
跨云 MCP:连接你技术栈的其余部分(Cross-Cloud MCPs)
跨云 MCP 服务器把外部系统连接到 headless 环境,让调用者获得完整、统一的图景,而无需为每个来源构建自定义集成。作为数据基础的一部分,Salesforce 提供三个跨云 MCP 服务器。
Informatica MCP Server:把工作流连接到 Informatica Intelligent Data Management Cloud(IDMC)。管理员连接一个现有 IDMC 实例,让调用者获得 Informatica 的数据质量、去重、血缘、治理和 MDM 能力——无需在 Salesforce 内部重建这些规则。最后这句是关键:规则留在它们本来的地方。
MuleSoft MCP Server:把工作流连接到你现有的集成、API 和整个技术栈中的代理。代理无需任何代码改动就能从外部系统拉取数据,让你现有的集成保持原位、同时变得对 headless 工作流可访问。
Tableau MCP Server:把 AI 生态连接到可信的分析和受治理的语义层。代理可以基于 Tableau 语义定义——指标、计算、业务逻辑——而非原始数据来推理,从而获得对你业务更丰富、更准确的理解。
这三个 MCP 服务器共同意味着:headless 设置中的代理不再局限于 Salesforce 内部的东西——它能访问干净的数据、集成,以及你的企业已经在运行的分析。
把三大支柱付诸实践(Put the Three Pillars into Action)
这是一个真实请求贯穿三大支柱的例子:「为什么这个账户上个月用量下降了,他们有流失风险吗?」
- 流程从元数据和上下文 Grounding 开始——通过 Headless 360 MCP server 对
Account和Opportunity对象运行Discover和Describe调用,识别相关字段并确认访问权限。 - 工作流随后查询 Data 360:零拷贝联邦拉取客户的统一档案——数据仓库中的支付历史、CRM 中的支持工单量、外部系统中的合同数据——而不移动任何数据;身份解析把所有记录匹配到同一位客户。
- 最后,工作流查询 Tableau MCP Server 获取受治理的
usage trend指标——使用业务实际运行的确切计算;如果系统检测到过期的联系人数据,它会调用 Informatica MCP Server 检查数据质量标志,再返回结果。
一个请求。三大支柱。一个完整、受治理的答案。
总结(Summary)
你的工作流只有其底层数据基础一样可靠。当你正确构建基础时,工作流会准确执行、保持受治理,并安全地扩展——这正是本模块的核心论点:工具是简单的部分,基础才是真正需要下功夫的地方。
接下来(What’s Next)
要深入了解平台如何处理安全与信任,接下来学习 Secure and Trusted Headless Foundation 模块。本模块讲了数据需要呈现的样子;那个模块讲平台如何端到端地保护它。