一、认识 Data 360 中的搜索索引类型
用 Data 360 搜索来扎根 AI
将 AI 扎根(ground)在客户特定数据上,能提升生成式 AI 在 Salesforce 平台各应用、分析和自动化工具中的价值。扎根可以通过非结构化、半结构化或结构化数据实现——利用用户查询检索相关的 CRM 数据来扎根 AI 模型,使 Agentforce、Tableau、Flow Builder 等应用的输出精准贴合用户意图。
在 Data 360 中,你可以对任何数据(包括知识库中的非结构化数据)构建搜索索引。Data 360 支持以下三种搜索索引类型:
- 向量搜索索引(Vector search index)
- 混合搜索索引(Hybrid search index)
- 增强搜索索引(Enriched search index)
要构建搜索索引,先把数据导入 Data 360:Data 360 摄取非结构化数据,将其映射到标准数据模型对象(DMO)或非结构化数据模型对象(UDMO),从数据中创建有意义的内容块,再创建向量嵌入来构建搜索索引,帮助应用理解数据之间的语义和词法相似性。
选择搜索索引类型
在决定哪种搜索索引最适合你的具体用例和数据集之前,先深入了解这些搜索类型的区别,以及哪些搜索查询能带来最相关的响应。
向量搜索索引
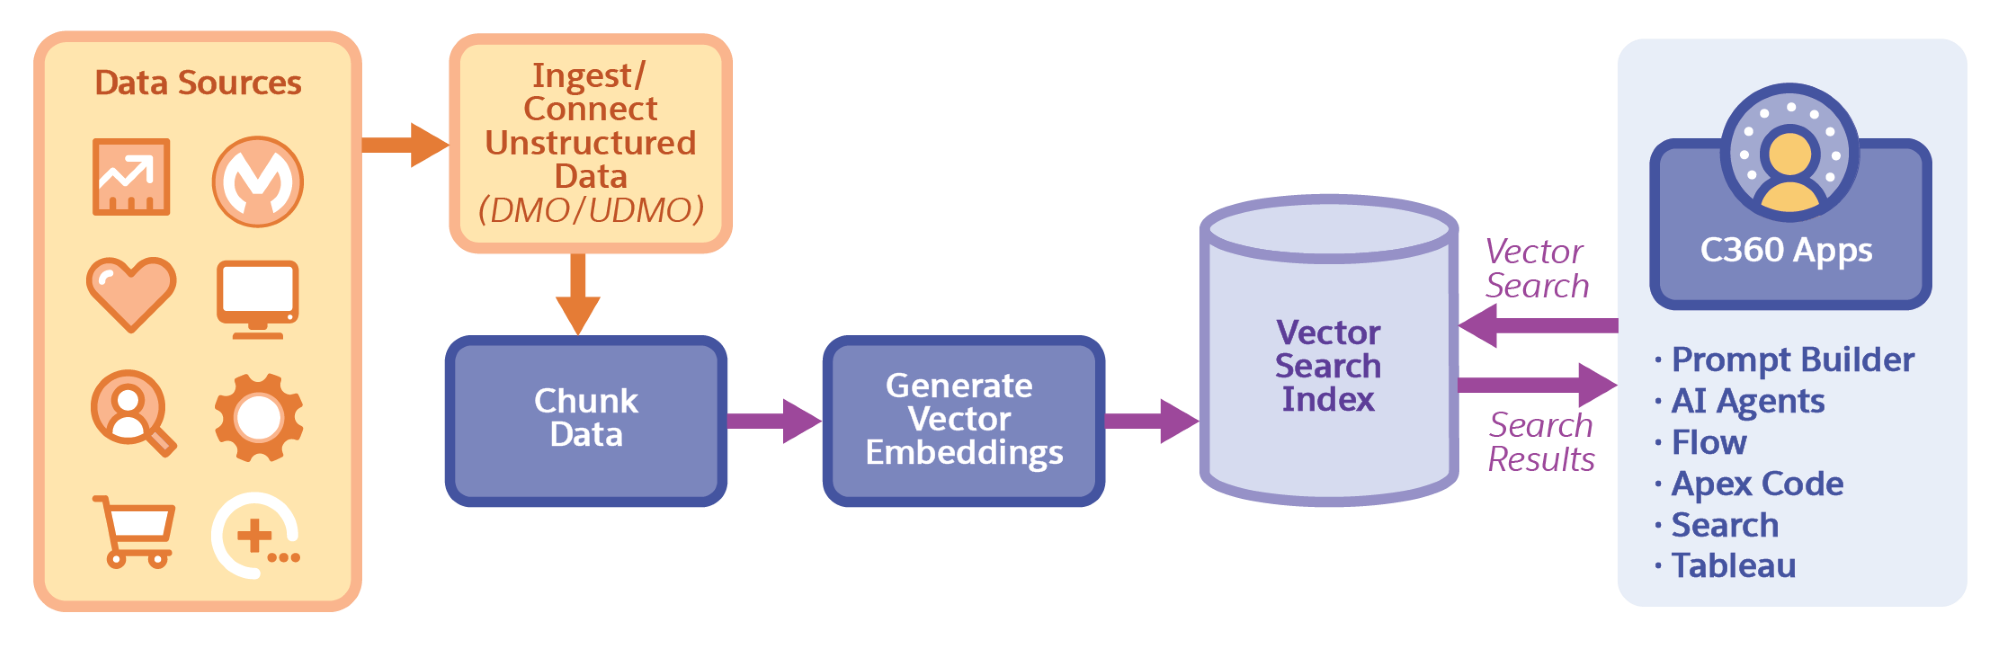
向量搜索(又称语义搜索)为给定的搜索查询检索语义相似的数据(或数据块)。这些数据还可以包括视频、音频和通话记录。向量搜索的检索方式是:对数据分块、创建向量嵌入,然后搜索与查询在语义上最接近的向量嵌入。
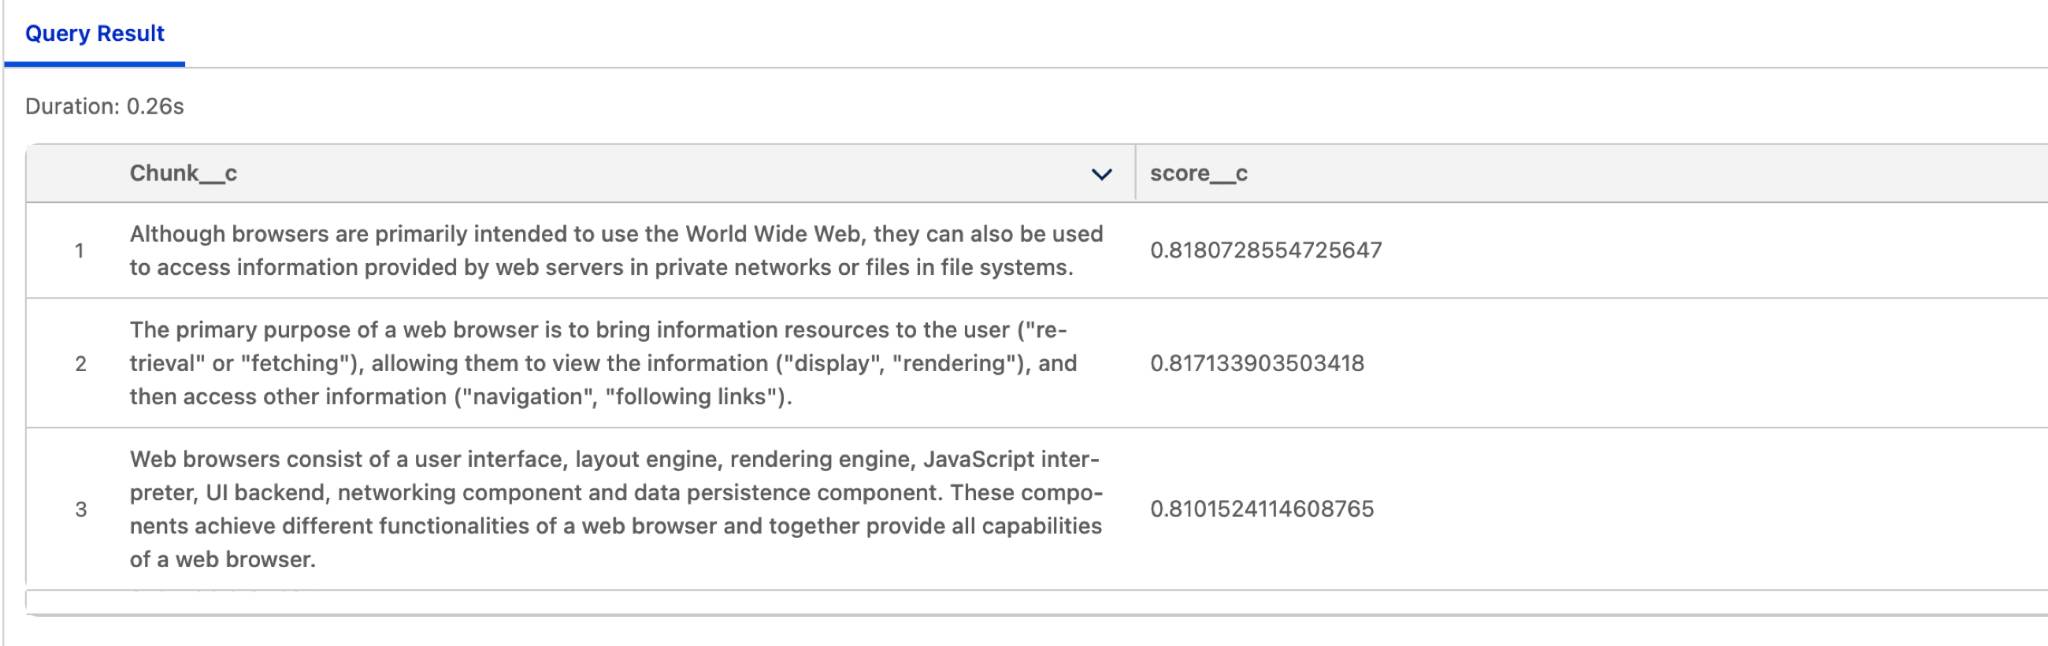
向量搜索非常适合长文本查询——即用户寻找一般信息的场景。查询会检索向量搜索分数最高的数据,对应语义上最接近的匹配。
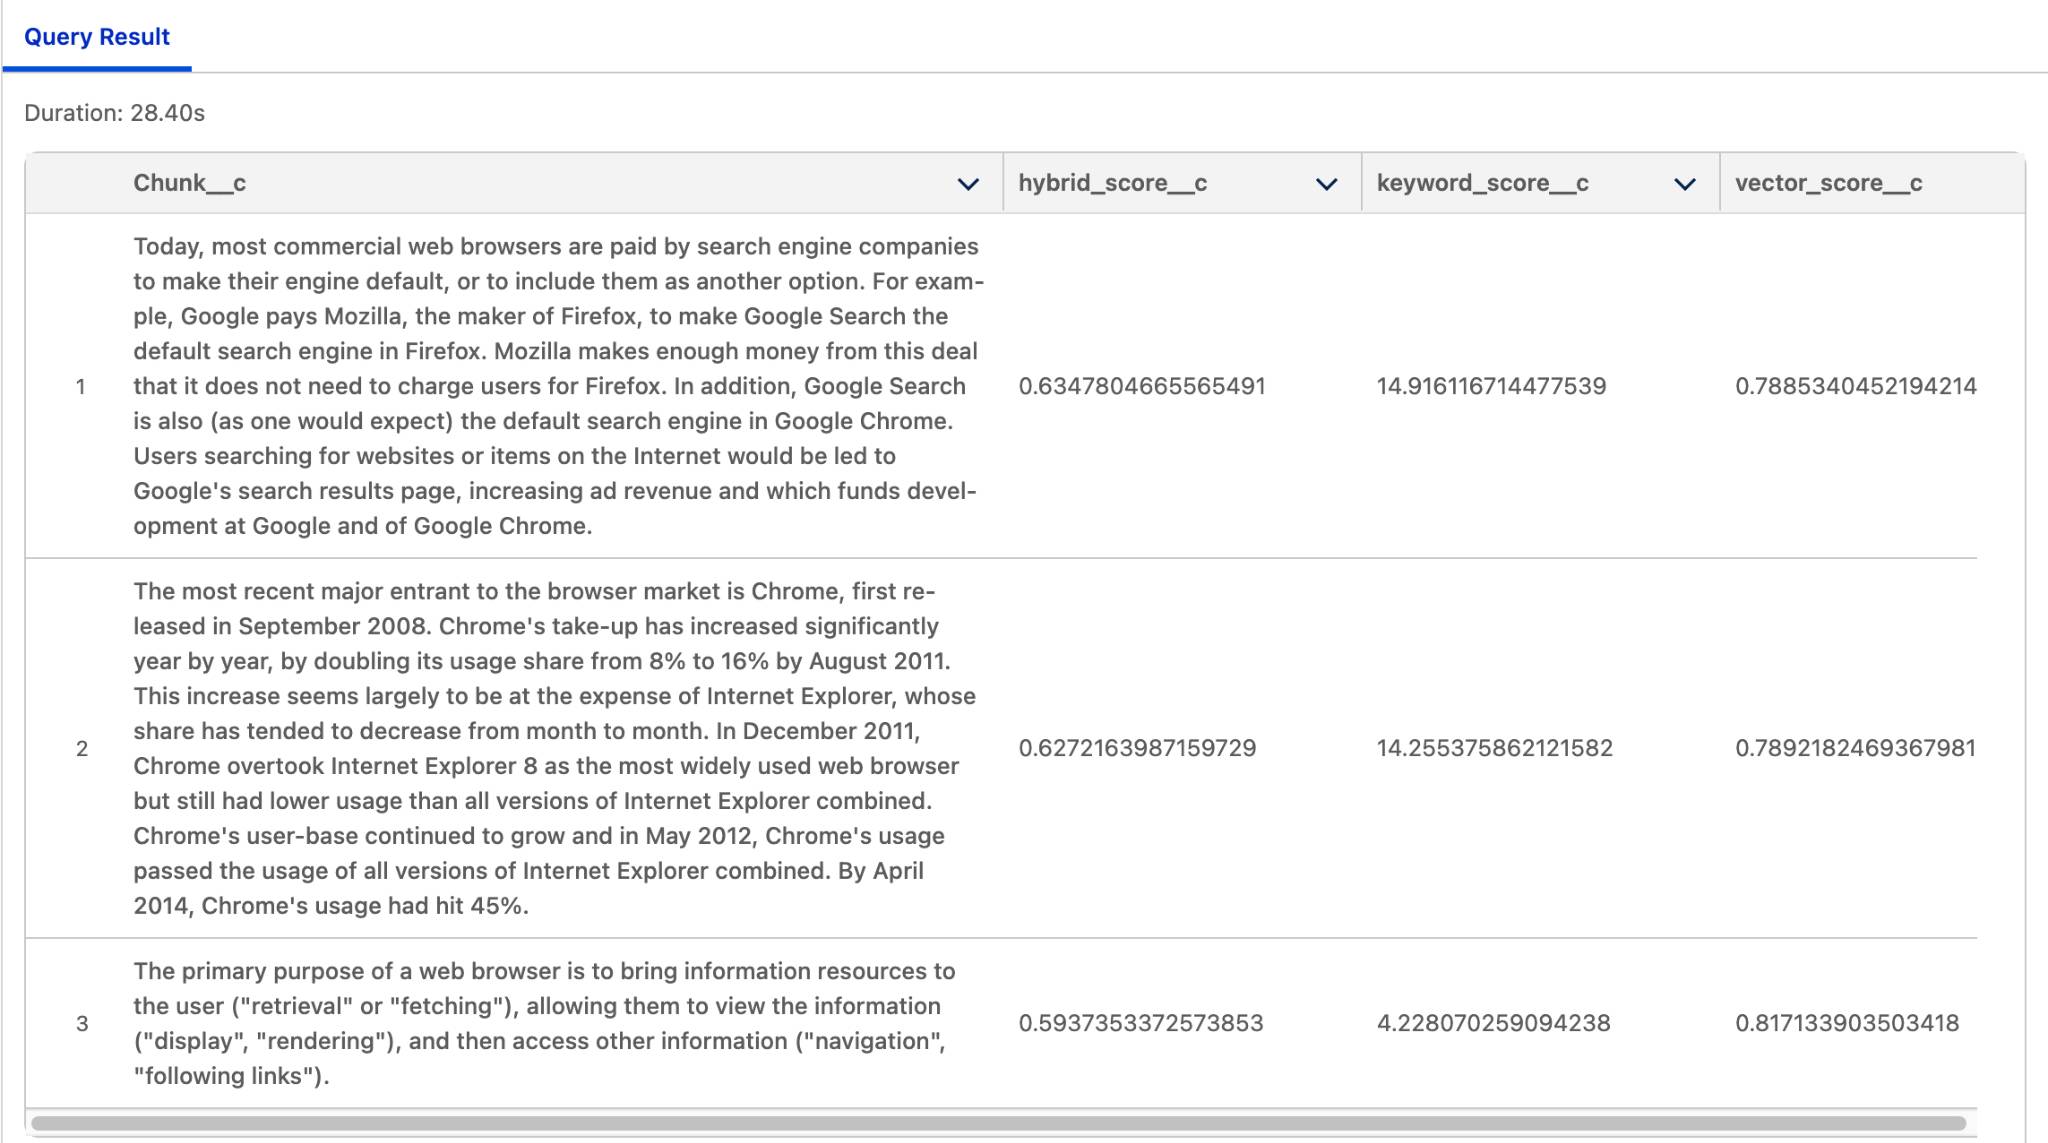
例如,一个关于"Google Chrome 浏览器如何工作"的查询,会检索向量搜索分数最高的块(即与查询语义最接近的匹配):
混合搜索索引
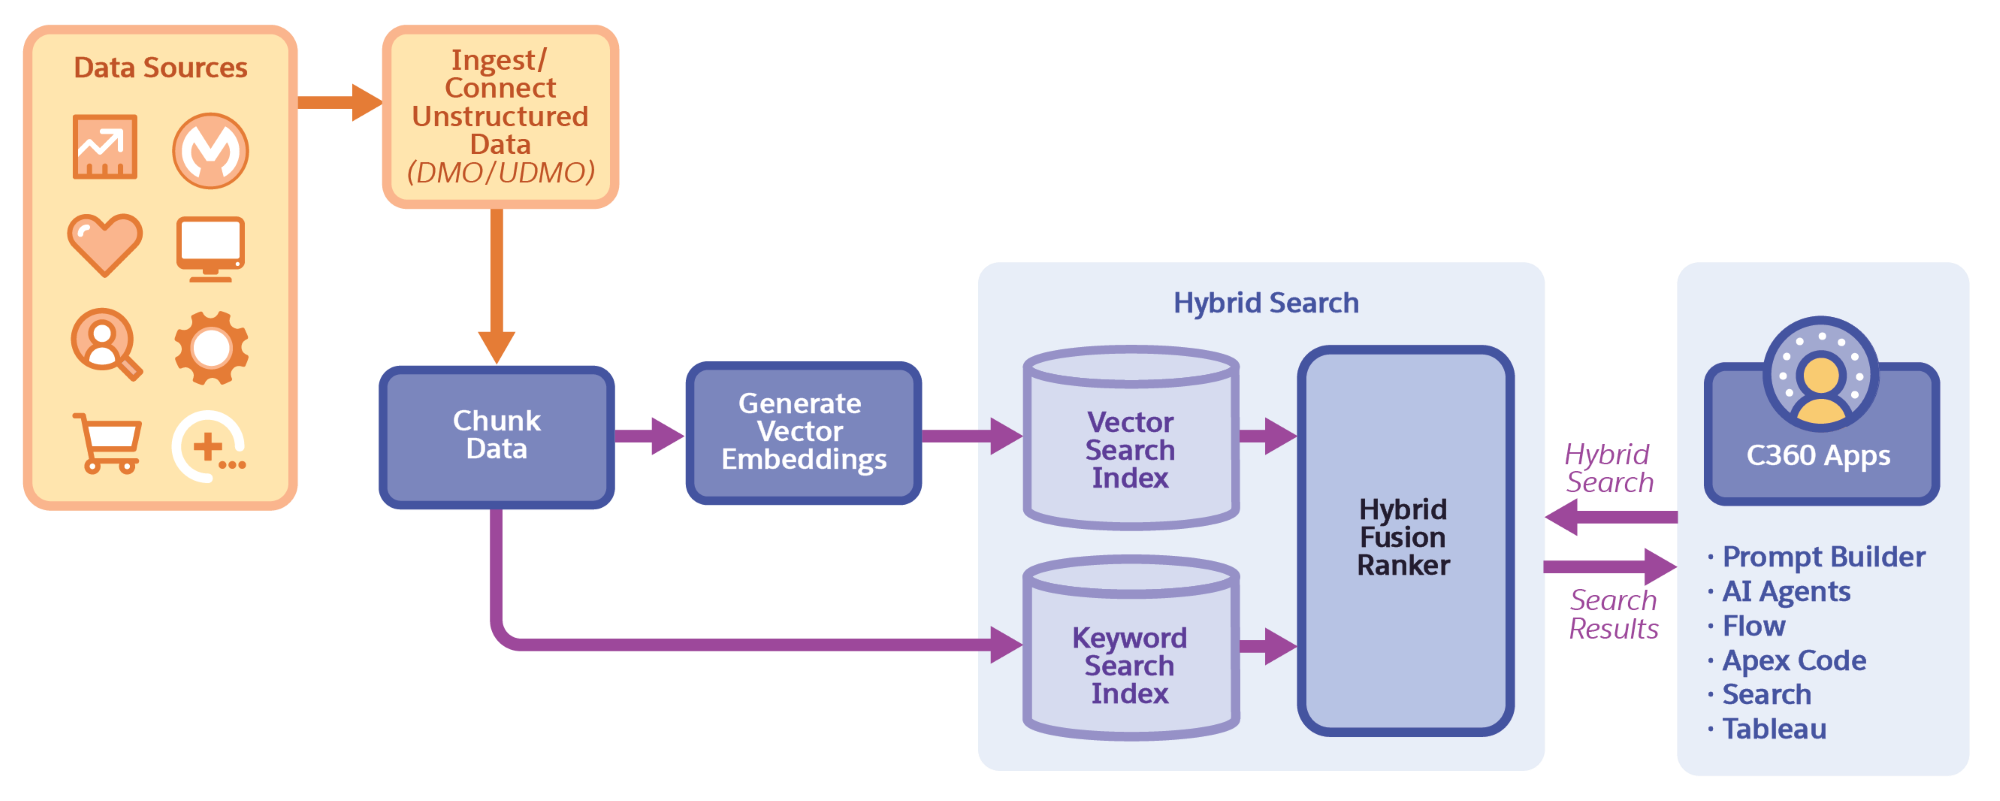
混合搜索结合了语义感知的向量搜索与关键字搜索处理领域词汇的能力。它合并两种搜索检索到的信息,再用融合排序函数(fusion ranker)对结果排序,展示最相关的信息。
默认的混合搜索融合排序函数在内部基准上针对多种搜索任务进行了优化,训练和评估数据来自 Einstein Search 和 Einstein Search Answers 等 Gen-AI 应用实际捕获的查询。
混合搜索非常适合包含特定搜索词的长文本查询:检索的关键字分数对应精确的关键字匹配,向量分数对应最接近的语义匹配,最终得到混合搜索分数最高、最相关的结果。
对于前面向量搜索中相同的查询示例,关键字搜索会把更相关的内容提升到更高排名,从而为 LLM 提供更好的扎根:
增强搜索索引
增强搜索索引为标准内容块增加额外的元数据和问题块,从而增强向量或混合搜索索引在检索增强生成(RAG)中的表现。
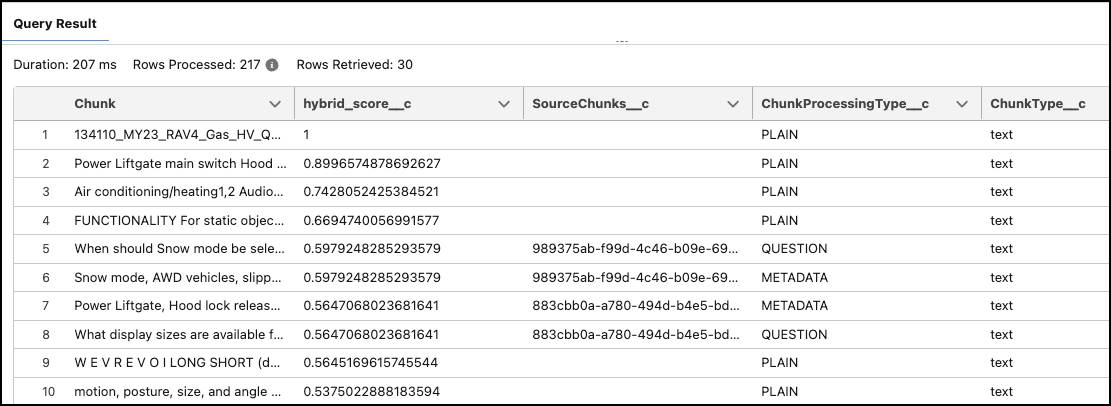
自动从内容块中提取关键字、实体、主题概述、内容所回答的问题、内容摘要等元数据,能显著提升检索准确性。这种 LLM 生成的增强是对人工整理的替代方案,让 AI 代理在回答问题时更容易识别最相关的信息。
使用方法:在创建向量或混合搜索索引时开启增强块(enriched chunks)。构建索引时,Data 360 会生成三个新块:一个包含原始块文本的普通块、一个包含元数据文本的元数据块、以及一个包含该块能回答的问题的问题块。然后在 AI Models 中为增强搜索索引创建检索器(retrievers),用于 prompt 模板和代理的 RAG 与代理工作流。
注意:在 Data 360 中使用此功能会消耗 Flex Credits,具体参见增强索引的计费注意事项。
总结
在 Data 360 中构建搜索索引,可将 AI 扎根于你组织的非结构化、半结构化或结构化数据。
选择最适合终端用户和应用查询的搜索类型:
- 如果用户的查询主要关于一般信息,或查询较长(超过 5 个词),向量搜索就足够了——它能在查询含上下文内容(通常是较长查询)时提供相关结果。
- 要获得结合语义匹配和关键字匹配的最准确、最相关结果,创建混合搜索索引。
- 当更高的检索准确性能带来可衡量的价值、足以抵消用 LLM 生成额外块的更高成本时,用额外的元数据和问题块增强搜索索引。