一、为 AI 处理内容
Agentforce 与 Data 360
想象一下,客服代理向 Agentforce 提问:"对于这个客户的错误代码,我应该建议哪些故障排查步骤?" Agentforce 无需扫描几十篇知识文章或案例记录,而是从 Data 360 检索正确内容,用经过验证的知识将 AI 回复扎根(ground),并即时生成清晰、有上下文的答案。结果是更快的案例解决、更少的手动搜索、更准确的客户支持。
Data 360 中的非结构化数据
非结构化数据(Unstructured Data)指不遵循一致格式、无法轻易放入关系型数据库、字段表或电子表格的信息。这类数据形式多样:文本、图像、音频、视频、邮件、聊天记录、PDF、知识文章、案例记录、支持工单、法律文档等等。
虽然更难组织,但它富含结构化数据无法捕捉的上下文,如客户反馈、情绪、语气和洞察。这为 Agentforce 等 AI 应用提供了加深上下文、改善客户互动的宝贵知识库。
数据连接器
非结构化数据需要与结构化数据不同的处理方式。借助 Data 360,你可以通过预构建连接器摄取非结构化内容,并创建搜索索引配置,把文本、图像或表格等内容转换为块(chunks)和数值向量(vectors)。Data 360 索引这些块和向量,供 AI 应用、分析仪表板和工作流自动化进行快速搜索与检索。
Data 360 支持多种连接器类型和数据格式来处理非结构化数据。你也可以使用 Document AI 来处理非结构化(或半结构化)数据。
Document AI
使用 Document AI 可以从 PDF、发票、合同和报告中提取关键细节,存入数据湖对象(DLO,Data Lake Objects)——这些对象代表提取数据的模式(schema)。
本质上,Document AI 识别客户姓名、日期、地址、金额等字段,并将其转换为 Data 360 中结构化的、可搜索的数据,使内容可用于 AI 提示、分析和自动化。
例如,酒店连锁的 Service Cloud 管理员可以用 Document AI 从调查问卷中提取客户反馈,然后让 AI 代理基于提取的数据创建客户记录并安排后续跟进。
用例:整合到一起
Get Cloudy Consulting 是一家全球咨询公司,依赖分布在各地区和业务线中的数千份提案、研究报告和客户演示来做业务。一位顾问在准备客户会议时,需要快速了解过去针对零售行业数字化转型的建议。
由于团队此前已用 Document AI 从非结构化的演示稿和报告中提取了框架、案例研究和基准数据,顾问只需向 Agentforce 查询,就能检索到最相关的建议和支持数据点。
顾问无需翻遍文件夹或依赖记忆,就能即时获得准确、富含上下文的洞察,从而交付个性化、高影响力的客户演示。通过把非结构化内容转化为结构化知识,Get Cloudy Consulting 让团队能够提供更快、更个性化、更可信的体验。
二、探索 Data 360 内容解析与预处理方法
解析内容
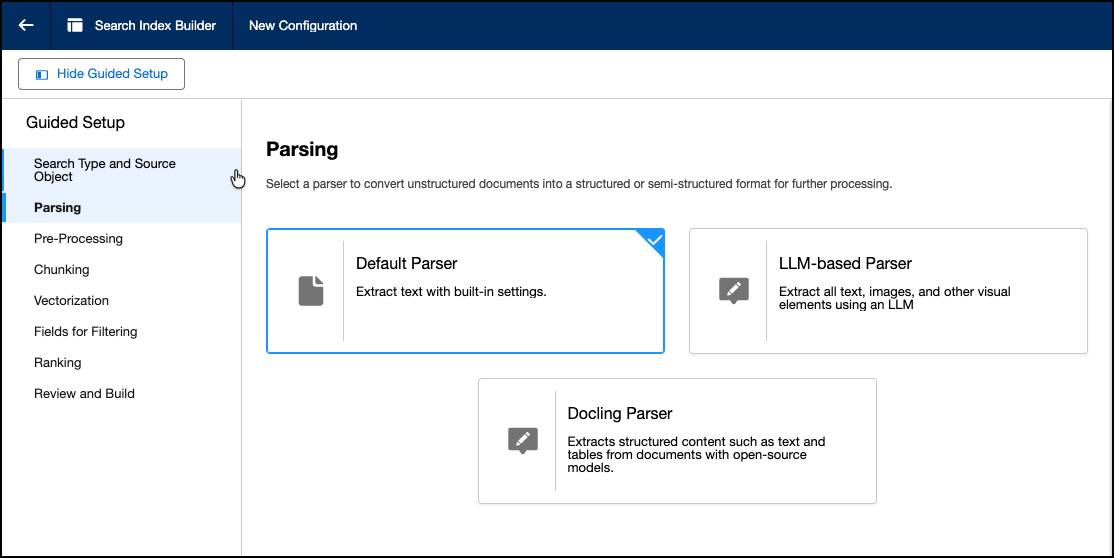
解析(Parsing)把非结构化文档——如 PDF、手册和报告——转化为 AI 系统可以轻松检索和分析的结构化数据。你选择的解析策略至关重要:它决定了文档结构、关系和视觉上下文的保留程度,直接影响系统的回答准确性、整体性能和运营成本。
Data 360 提供三种内容解析选项:
- 默认解析器(Default Parser):用内置设置将文本提取为结构化、可搜索的数据。
- 基于 LLM 的解析器(LLM-based Parser):使用 LLM 提取文本、图像和其他视觉元素。
- Docling 解析器(Docling Parser):使用开源模型,通过版面理解提取文本和表格。可将 Docling 解析器与 LLM 图像处理结合,处理流程图和图像等视觉内容。
默认解析器
默认解析器是一种高度可扩展、成本高效的方案,专为文本密集型资源设计,如知识库文章、政策文档、开发文档和内部 wiki。它优化了对干净、线性文本的提取——含义主要通过段落、列表和标题传达。
这使它成为大规模摄取结构化复杂度最低的精选文本知识的理想选择。
基于 LLM 的解析器
对于高度复杂、多模态的文档,完整的基于 LLM 的解析能提供在文本、表格和视觉内容之间最全面的解读。它通过对多样化内容类型的整体语义理解,提供无与伦比的上下文感知。
这种深度分析非常适合高级合规分析或工程诊断等场景——在这些场景中,最大化理解能力是首要目标,可以接受额外的处理成本。
Docling 解析器
Docling 解析器专为版面和结构关系重要的企业文档设计,如财务报告、合规文档和运营报告。与标准解析器不同,它通过解读多级标题、合并单元格和嵌套表格等复杂元素,提供卓越的结构保真度。这种深入的版面感知保留了确保下游检索和 AI 回答高度准确所需的关键上下文。
当处理系统架构图、组织结构图或治理工作流等视觉复杂的企业文档时,标准文本提取力不从心。为 Docling 启用图像处理可以弥补这一差距——通过高级 LLM 有选择地分析方向流、标注连接和结构依赖,从而在不牺牲处理效率的前提下,深入理解视觉化流程的上下文。
预处理
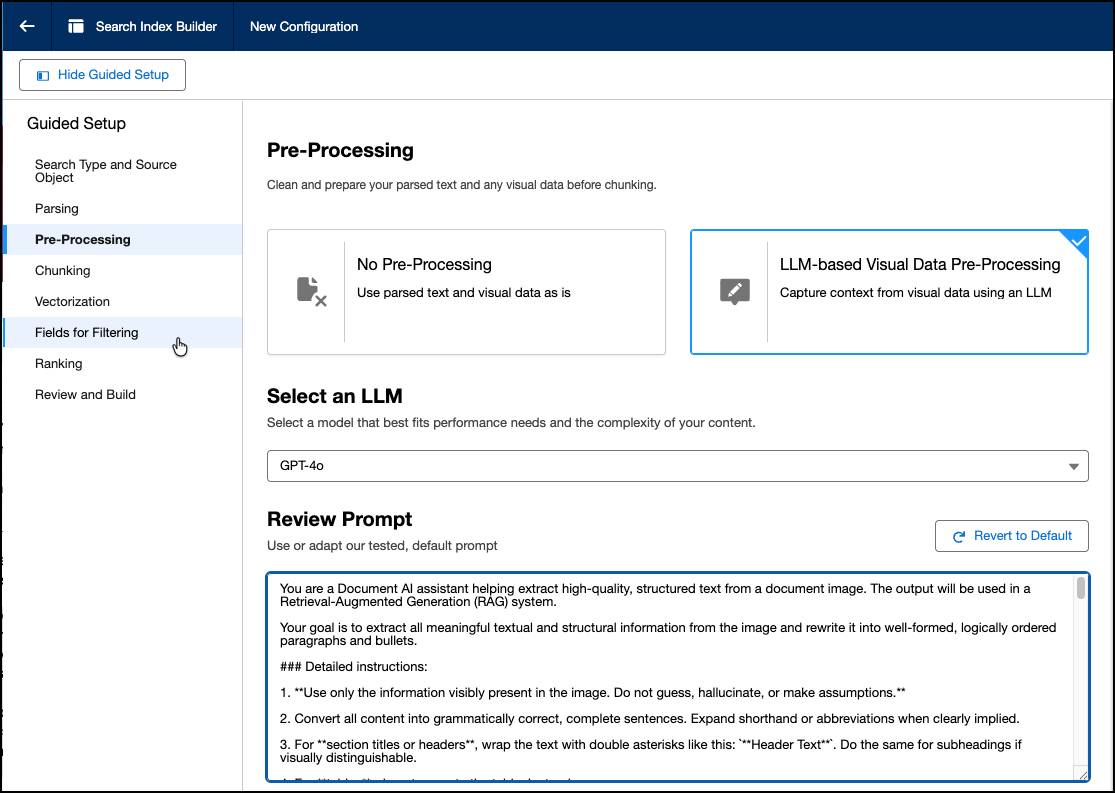
你还可以在默认解析器中启用基于 LLM 的视觉数据预处理(LLM-based Visual Data Pre-Processing),用 LLM 从视觉数据中捕捉上下文。预处理为图像、表格等多模态元素进行分块(chunking)做好准备——例如,从图像中提取上下文、从表格中提取数据,同时保持表格数据内的上下文和关系。
注意:不能同时为某个搜索索引选择"基于 LLM 的解析"和"基于 LLM 的视觉数据预处理"。对于通篇包含丰富视觉内容(如图像、图表和表格)的文档,应使用基于 LLM 的解析——对这些文档整体处理能提供更好的上下文和理解。
总结
解析和预处理是将 PDF、报告等非结构化文档转化为 AI 系统可分析的结构化数据的关键过程。Data 360 提供了多种选项,让你将解析策略与最大的上下文理解、规模和效率对齐。你选择的策略直接影响系统的准确性、性能和成本。
下一步,探索 Data 360 中的搜索索引类型,为你的用例确定要构建的正确搜索索引。