一、了解影响规模扩展的因素
当你的 Salesforce 组织要处理数百万条记录、成千上万的用户和复杂的集成时,性能不再是可选项,而是生死攸关的问题。本模块诊断最常见的规模化陷阱:Apex 触发器缺乏批量化、治理失败导致的锁争用、批量任务设置不当导致的超时、角色层级设计拖垮报表、以及无法扩展的搜索方案。通过真实的企业场景,你将学会在用户发现问题之前识别、诊断并修复这些性能瓶颈。
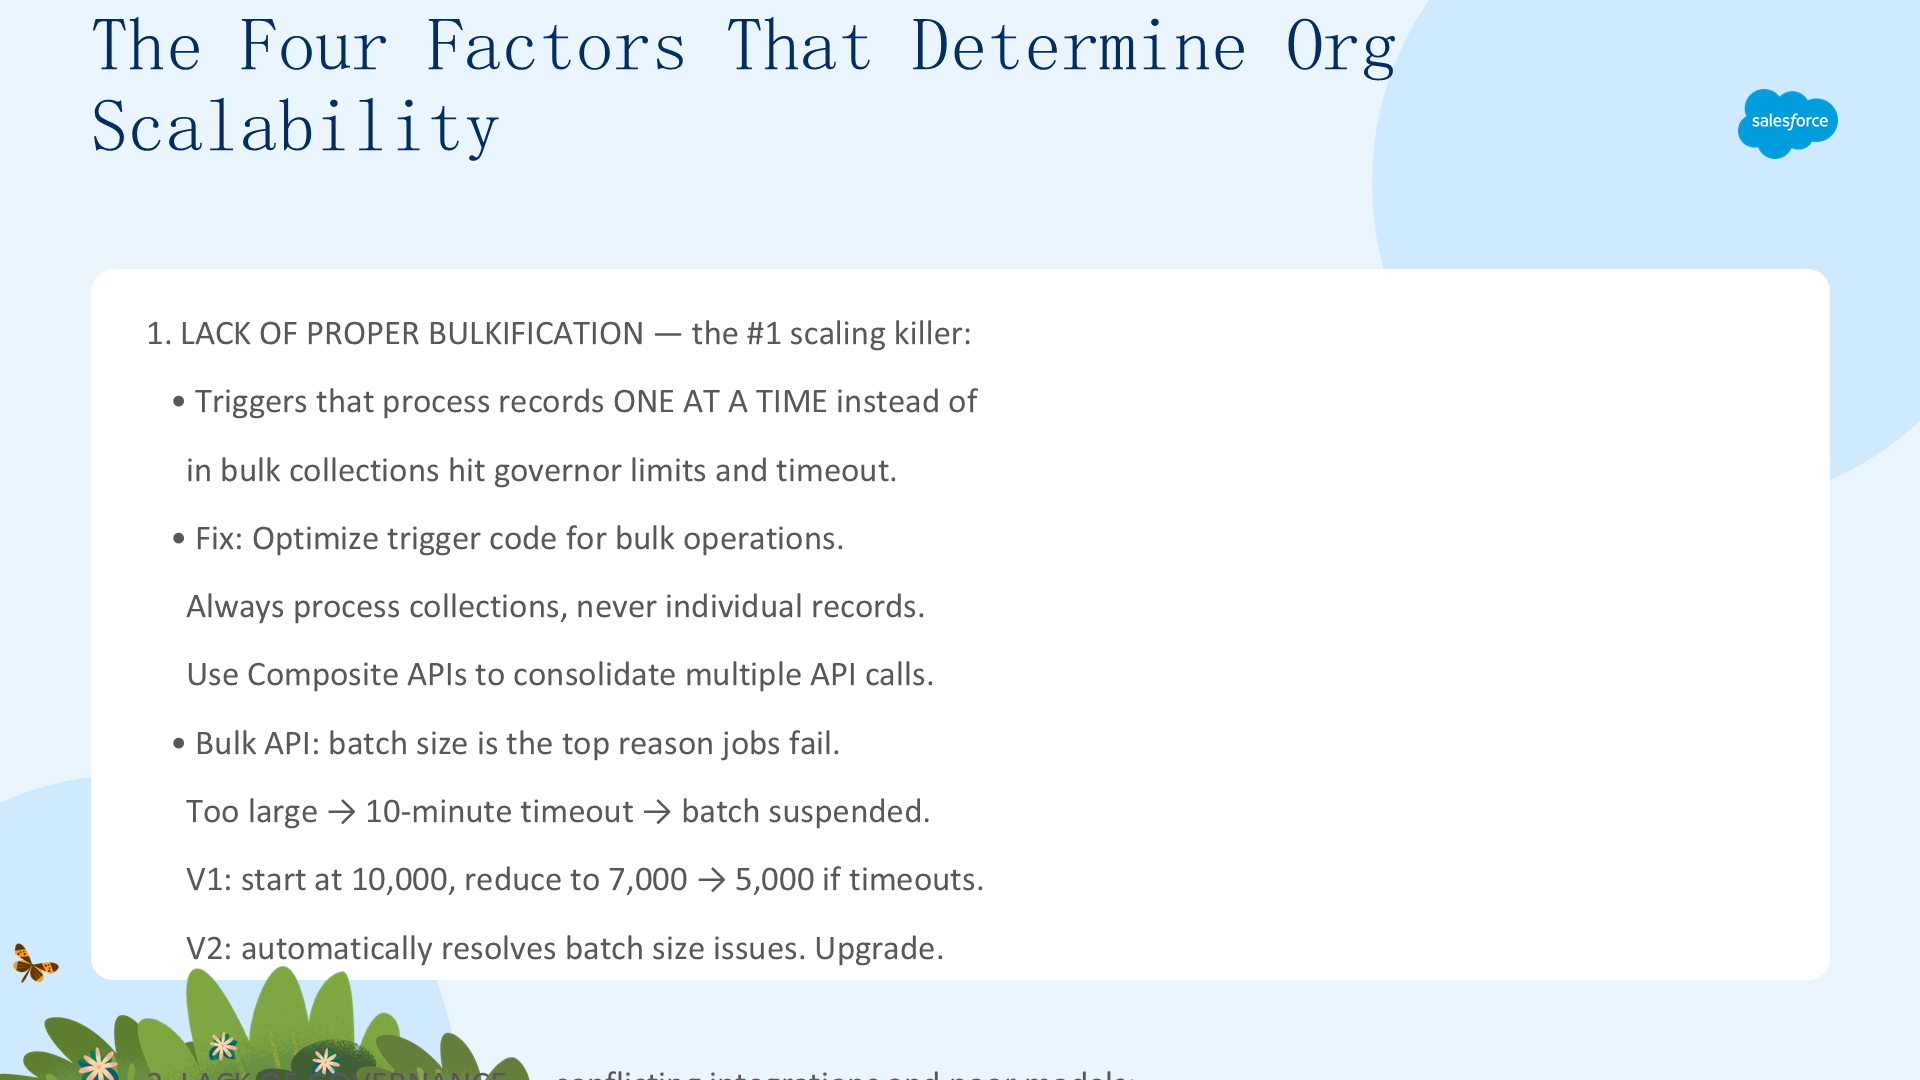
决定组织可扩展性的四大因素
设计解决方案时,要着眼长远:如果你能支持一个客户,就应该考虑支持数百万客户。细节决定成败——如果组织缺乏适当的批量化与治理、存在锁问题、使用了繁重的 Apex 后处理,都会直接影响其扩展效果,进而影响客户的成功。下面逐一剖析这些陷阱。
1. 缺乏适当的批量化(Lack of Proper Bulkification)
批量化事务能改善响应时间与资源消耗,并帮助你避免触及限制。相反,缺乏适当的批量化(尤其是触发器代码)会阻碍扩展。团队中需要有优秀的开发人员,他们应当:养成优化触发器代码的习惯、遵循 Apex 最佳实践、如果使用 Bulk V1 则确保使用最佳批量大小来改善批量化。
使用 Composite API 把多个 API 调用合并为一次调用。使用 Bulk API 时,优化批量大小以避免限制重试与超时——批量大小是批量任务失败的首要原因。如果批量过大,系统无法在 10 分钟的规定时间内处理完,批量就会被挂起。Salesforce 会超时处理超过 10 分钟的批量。如果组织使用 Bulk API 2.0,它会自动解决批量大小问题;而如果使用 V1,客户通常从较大的批量(10,000)开始,遇到超时后再逐步调小。
如果 Bulk V1 仍在运行,可以先把批量降到 7,000、再降到 5,000,以此类推,确保批量不超时。减小批量会降低吞吐量,但同时消除了锁并最小化重试次数。如果超时问题持续存在,就迁移到 Bulk API 2.0。
2. 缺乏治理(Lack of Governance)
在治理方面,有两条影响可扩展性的途径:运行多个相互冲突的集成,以及糟糕的数据/共享模型。
- 避免并行运行多个相互冲突的集成。例如,一个集成正在为「Account 1」插入 Cases,而另一个集成同时在为同一个「Account 1」插入 Contacts——这类冲突集成会导致锁。当多个职能与技术团队在同一应用上工作、却缺乏对构成应用的集成的整体视图时,这种治理缺失很常见。
- 糟糕的共享模型也会影响可扩展性。数据与共享模型是应用的基础,如果设计不佳,其他一切——包括集成、报表甚至单点登录(SSO)——都注定失败。
与客户保持持续沟通,有助于理解他们现在和未来的所有需求。判断数据事务是需要实时还是近实时,是避免触及调控器限制(governor limits)的关键。明确了这一点,就能把大量查询、更新和插入卸载到未来,还能简化集成选型。如果数据不需要常驻在平台上,使用 Salesforce Connect 之类的技术(虚拟化)就变得可行。
3. 记录锁定(Locking)
客户常常在上传大量数据的同时,还维护着与其他系统的集成来更新数据。如果多个集成同时更新同一条记录,就可能导致记录锁定。记录级的数据库锁定是为了在更新进行时保持数据完整性。这些锁不像组织级锁那样有相同的性能风险,但仍可能导致更新失败。重要的是避免在不同线程中对同一条记录运行冲突更新。
来看一个例子:Cloud Kicks 是一家定制鞋制造公司,有 15 万个从新球鞋营销活动中产生的联系人,但这些联系人没有关联到任何业务账户。把这些新联系人都分配到一个「占位账户」看似简单,但单个父账户下的最优子记录数是 10,000。如果 Cloud Kicks 把 15 万个联系人都分配到一个账户,维护时就会引发性能问题。
4. 繁重的 Apex 后处理(Heavy Apex Post-Processing)
执行顺序的重要性人尽皆知。你可能见过开发人员在同一个对象上写 12–15 个触发器——这会导致严重的递归,纯粹因为糟糕的设计让数据集成耗时更长。如果试了各种模式仍没达到期望吞吐量,先别急着怪模式,Apex 后处理可能才是拖累吞吐量的元凶。花点时间检查 Apex 后处理、流程(process flows)和触发器,确保它们是最优的。
要验证 Apex 后处理是否已最小化——这是使用 Bulk API 时的关键因素。一个识别客户是否在侵占资源的办法,是弄清楚每个批量耗时多少。如果你在做批量加载,但批量一直比平时更慢,你就能发现繁重 Apex 后处理导致延迟大幅上升。
评估你需要的集成:为了准确评估如何扩展,需要做出四项决策,这些决策也有助于定义服务级别协议(SLA):
- 源与目标(Source and Target):明确哪个系统发起集成、哪些系统与源集成。
- 类型(Type):集成发生在表示层、业务流程层还是数据层?
- 数据量(Data Volume):各系统预计的数据量与事务量是多少?不要只考虑数据行数,还要考虑数据大小,因为需要理解可处理的吞吐量。
- 时机(Timing):时机决定你选择的模式——源是等待实时响应(同步),还是发起请求后继续处理(异步)?
在此基础上,再回答这些额外问题:1) 是否必须移动数据?2) 是否只是只读需求?3) 数据需要多久移动一次?4) 使用哪个对象?5) 每小时及峰值时的数据量是多少?6) 预计总数据量是多少?理解源与目标、集成类型、数据量与时机,将帮助开发人员或架构师明确前进方向。
下一步:扩展的关键在于比用户更早地定位瓶颈。通常 API 的构建方式以及数据的后处理才是罪魁祸首。牢记细节、最大化 API 性能,才能为客户的成功走上正轨。
二、缓解失败的数据加载并优化搜索
在第 2、3 单元中,我们把概念应用到真实企业场景:一个零售商每天 1200 万条的 upsert 频繁超时;一个拥有 10 万许可证的公司却无法让搜索和报表可靠运行。这些并非假设——它们基于真实的 Salesforce 客户案例,解决方案都是实用、立即可用且经过验证的。
企业场景:诊断真实的性能问题
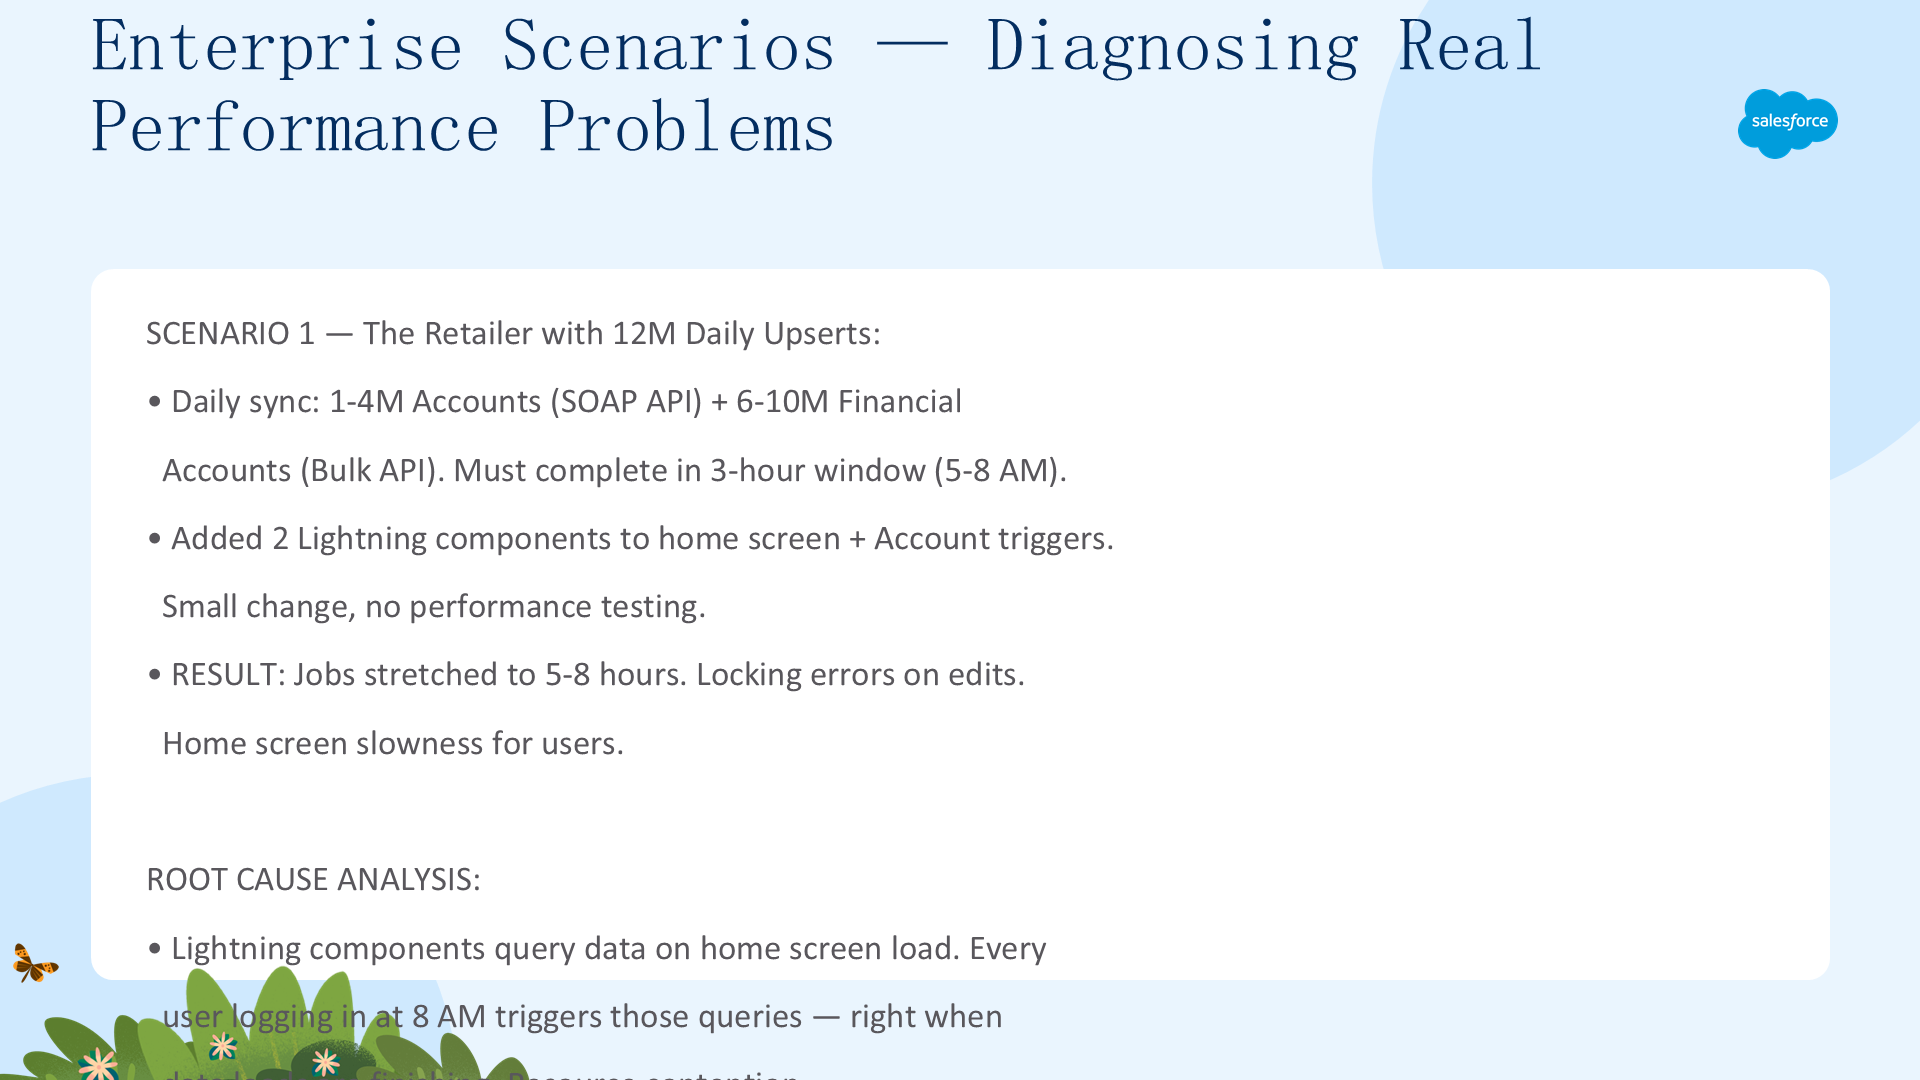
场景 1:征服超大批量(Conquering Large Batch Sizes)
一家经营 100 年的大型零售商拥有忠诚的客户群。其每日同步流程向 Salesforce upsert 接近 1200 万条记录,同步 Accounts(100 万–400 万)与 Financial Accounts(600 万–1000 万)等对象的变化。零售商对客户财务账户加载使用 Bulk API,对账户加载使用 SOAP API。同时还有几个批处理 Apex 任务在相近时间启动,对 Accounts 做后处理。客户要求所有任务在 3 小时窗口(美东时间 5–8 AM)内完成——这个时间至关重要,因为必须在美东第一位业务用户登录前完成更新。
一个月前,零售商做了一次代码部署,在主页屏添加了两个新的 Lightning 组件,并为 Accounts 添加了一些触发器来覆盖全新功能。由于这是一次小更新,部署前没有做重大性能测试。渐渐地,每日任务开始耗时 5–8 小时,突破了 3 小时 SLA,业务用户对此不满;部分用户在编辑数据时遇到锁定错误,还有用户抱怨访问主页时变慢。
分析这个场景,可以归纳出以下反模式(anti-patterns)与最佳实践:
- 反模式:没有在沙箱中预先评估批量加载时间。 最佳实践:使用 Bulk API 前,先在 完整副本沙箱(full copy sandbox)中测试,以识别加载模式、加载顺序以及可能出现的锁定问题。
- 反模式:夜间加载超过 50 万条记录仍用 SOAP API。 最佳实践:加载大量记录(超过 50 万或更多)时使用 Bulk API,小数据集才用 SOAP。从外部系统同步数据时,只同步满足业务用例所需的数据量;用虚拟化技术「查看」外部数据,避免同步大量非关键数据。选择 SOAP 还是 Bulk API,数据集大小是决定因素。
- 反模式:批处理 Apex 与数据加载并行运行。 最佳实践:理解 Salesforce 锁定机制及其对批量数据加载的影响。为减少并行加载批次之间的父记录锁争用,按父 ID 预排序子记录——这样属于同一账户的所有联系人更可能落在同一批次,大大降低锁的可能性。
- 反模式:对异步操作期望严格的 SLA。 最佳实践:异步操作通常对应长时间运行的批量任务,因此没有保证/SLA决定排队任务何时完成。选择 Bulk API 就是让服务器在有资源时再处理记录。同步任务始终优先于异步任务。在无需立即处理时使用异步操作。
- 反模式:部署前没有对自定义 Lightning 组件做性能评估。 最佳实践:如果应用包含自定义功能,部署到生产前必须定义性能测试策略。尽早确定并记录用例与策略、使用哪些工具或参与者、运行哪些类型的测试。常见的性能测试是单用户测试——让一个用户端到端地导航以发现瓶颈,判断是否会触及调控器限制。应在完整副本沙箱中测试,按生产预期的数据量加载合成数据,让测试环境在数据量与形态上与生产保持平行,从而获得真实的性能视图。如果账户与商机之间存在所有权关系,也要保持相同的比例与数据画像。对于集成,最好把虚拟用户数模拟到生产预期的 50%(例如预期 1000 用户登录,就模拟 50% 或沙箱允许的最大容量)。由于 Salesforce 是多租户平台,最好在非高峰时段测试。
场景 2:定位角色层级与报表问题(Pinpointing Role Hierarchies and Reporting)
一家公司近期购买了 10 万个 Salesforce 许可证,希望 Salesforce 最终取代其遗留系统,但目前所有数据仍在 Salesforce 之外托管。公司有 15 层深的组织层级,因为上线初期只有少数业务单元使用 Salesforce,他们不知道未来需要哪些角色,于是把整个组织层级复制过来供未来复用。公司在 Salesforce 中有近 2 亿个账户,每个代理可以访问其代理机构服务的所有账户;为提供无缝客户体验,代理需要为走进机构的任何客户提供服务。他们实现了一个自定义 SOSL 搜索方案,让代理按姓名搜索客户后再创建账户记录。他们发现该搜索大多数时候返回空结果,即使 Salesforce 中已存在客户记录,导致大量不必要的重复记录。公司还开放了报表与仪表盘,让每个代理都能创建自己的报表——代理们总共创建了近 10 万个报表,随后 IT 部门接到大量投诉,说报表超时或执行极慢。
该场景的反模式与最佳实践:
- 反模式:模仿组织层级来建立角色层级,并为未来创建临时占位角色。 最佳实践:为提高性能,限制角色层级的层数,只创建满足当前需求的角色,明确每个角色的用途。组织层级不必匹配角色层级。检查组织有多少共享规则——如果共享规则很多,可能意味着角色层级性能不佳,此时应删除那些对已在角色层级内共享的记录再授予访问权限的共享规则。
- 反模式:根据报表需求来确定 Salesforce 中所需的最大层级。 最佳实践:报表返回的记录数取决于共享模型,这会直接影响性能。
- 反模式:在大型组织中使用带通配符的全局搜索来实现自定义 SOSL 搜索方案。 最佳实践:使用 SOSL 时避免通配符,确保搜索词非常具体。搜索的数据越多,查询执行越慢。
- 反模式:使用没有任何适当过滤器的报表。 最佳实践:更高效地使用过滤器与范围(scope),减少报表查询的数据量、更快返回数据。关键是教育用户如何构建能随公司增长而扩展的高效报表。
- 反模式:尽可能不使用日期过滤器与索引字段。 最佳实践:尽可能使用日期过滤器与索引字段,而不是公式字段;使用相对日期值(如「本周」「下周」「下月」);用
equals而不是contains(因为 contains 会执行通配符搜索);最好避免not contains和not equals。 - 反模式:对常见操作使用「罐头报表」(缺乏治理)。 最佳实践:尽早启动治理流程以保证一致性与易维护性。把用户按分析需求与用例分组,再用过滤器最佳实践为每个用户组创建标准报表。
拥有快速定位集成可能出现问题之处的工具,会让你成为团队中的宝贵资产。充分理解边界与限制、恰当地扩展,能减少花在解决批量化、治理、锁定与后处理相关反模式上的时间。