认识团队与概念验证范围
认识 Luna Stone(数据架构师)和 Charlotte Liu(Salesforce 架构师)——Northern Trail Outfitters(NTO)的两位架构师。
NTO 启动了一个 AI 概念验证(Proof-of-Value)试点:一个 Case Deflection Agent(工单转移代理)——通过自动回答客户问题来降低支持负载,答案基于 NTO 的产品文档和支持历史。
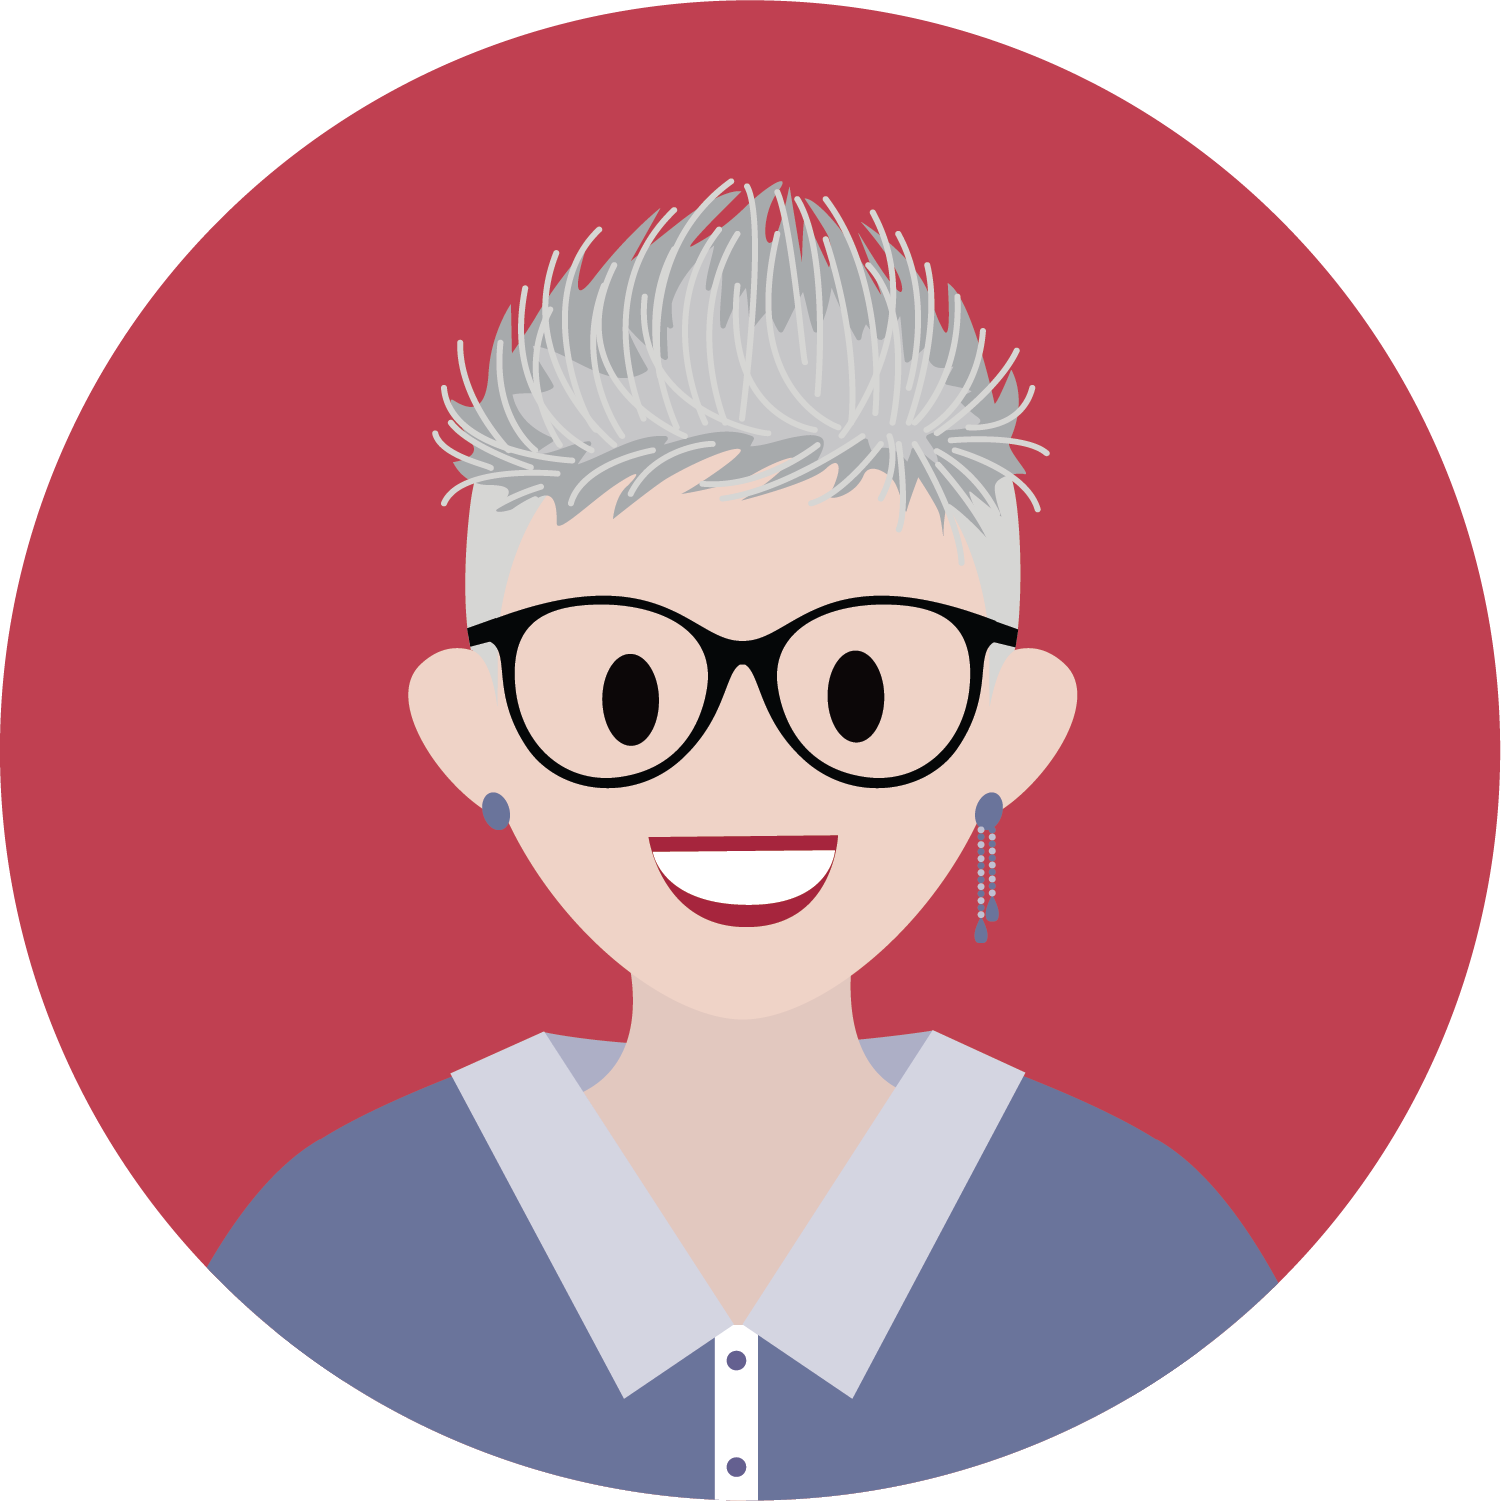
试点范围:回答常见产品问题、故障排查步骤和退货政策咨询。目标:证明 AI 能处理简单工单,让人类客服专注复杂工单。高管还明确指示:快速推进,同时确保方案可信、可扩展、建立在扎实的数据之上。但试点揭示了意想不到的情况……
试点发现与正确的问题
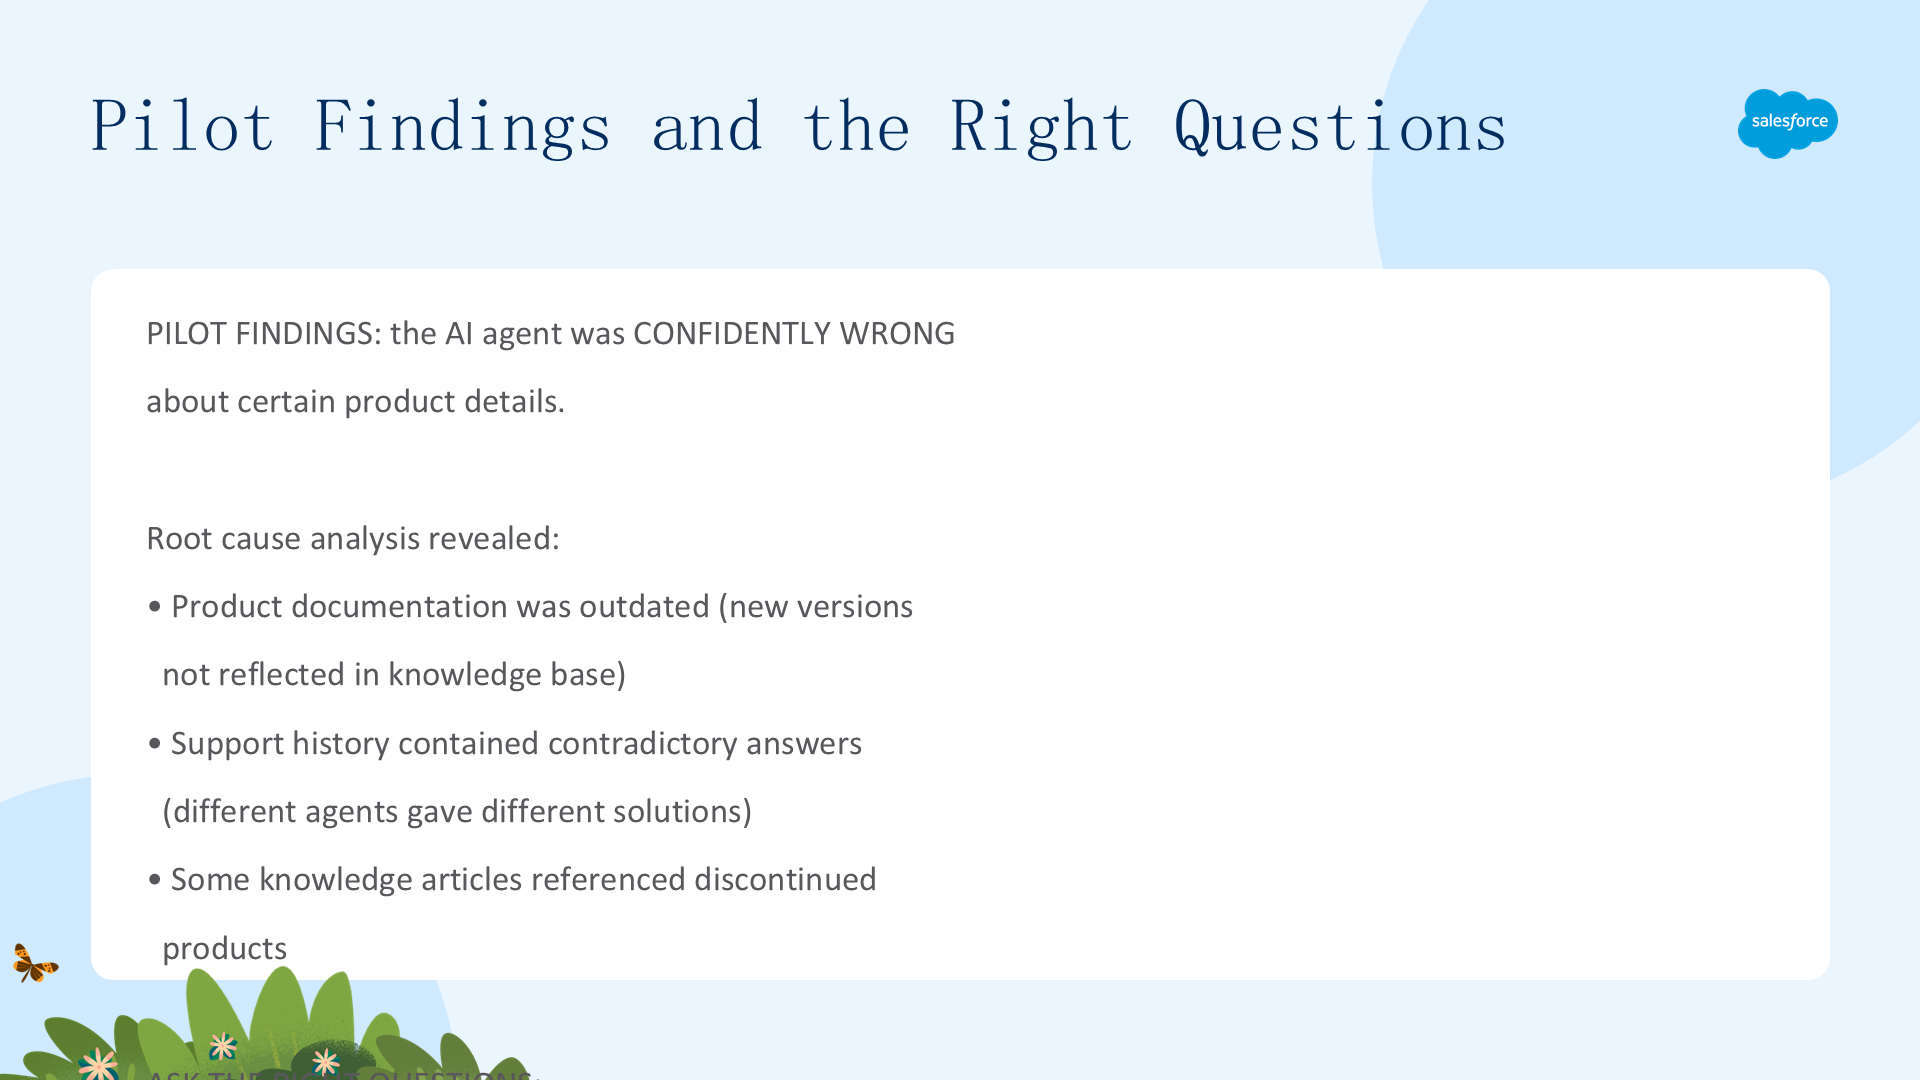
试点发现:AI agent 对某些产品细节自信地犯错。根因分析揭示:
- 产品文档过时(知识库里没有反映新版本)。
- 支持历史包含矛盾答案(不同客服给出不同解决方案)。
- 部分知识文章引用了已停产的旧产品。
Luna 和 Charlotte 先不急着调 prompt 或加数据,而是问正确的问题:
- 数据对 AI 可访问(Accessible)吗?
- 完整(Complete)吗(覆盖无缺口)?
- 有上下文(Contextual)吗(关联到相关数据)?
- 合规(Compliant)吗(适合 AI 使用)?
- 正确(Correct)吗(准确且最新)?
AI 数据就绪度 = 可访问 + 完整 + 有上下文 + 合规 + 正确。缺任何一个,AI 就会自信地犯错。
NTO 试点的数据可靠性示例
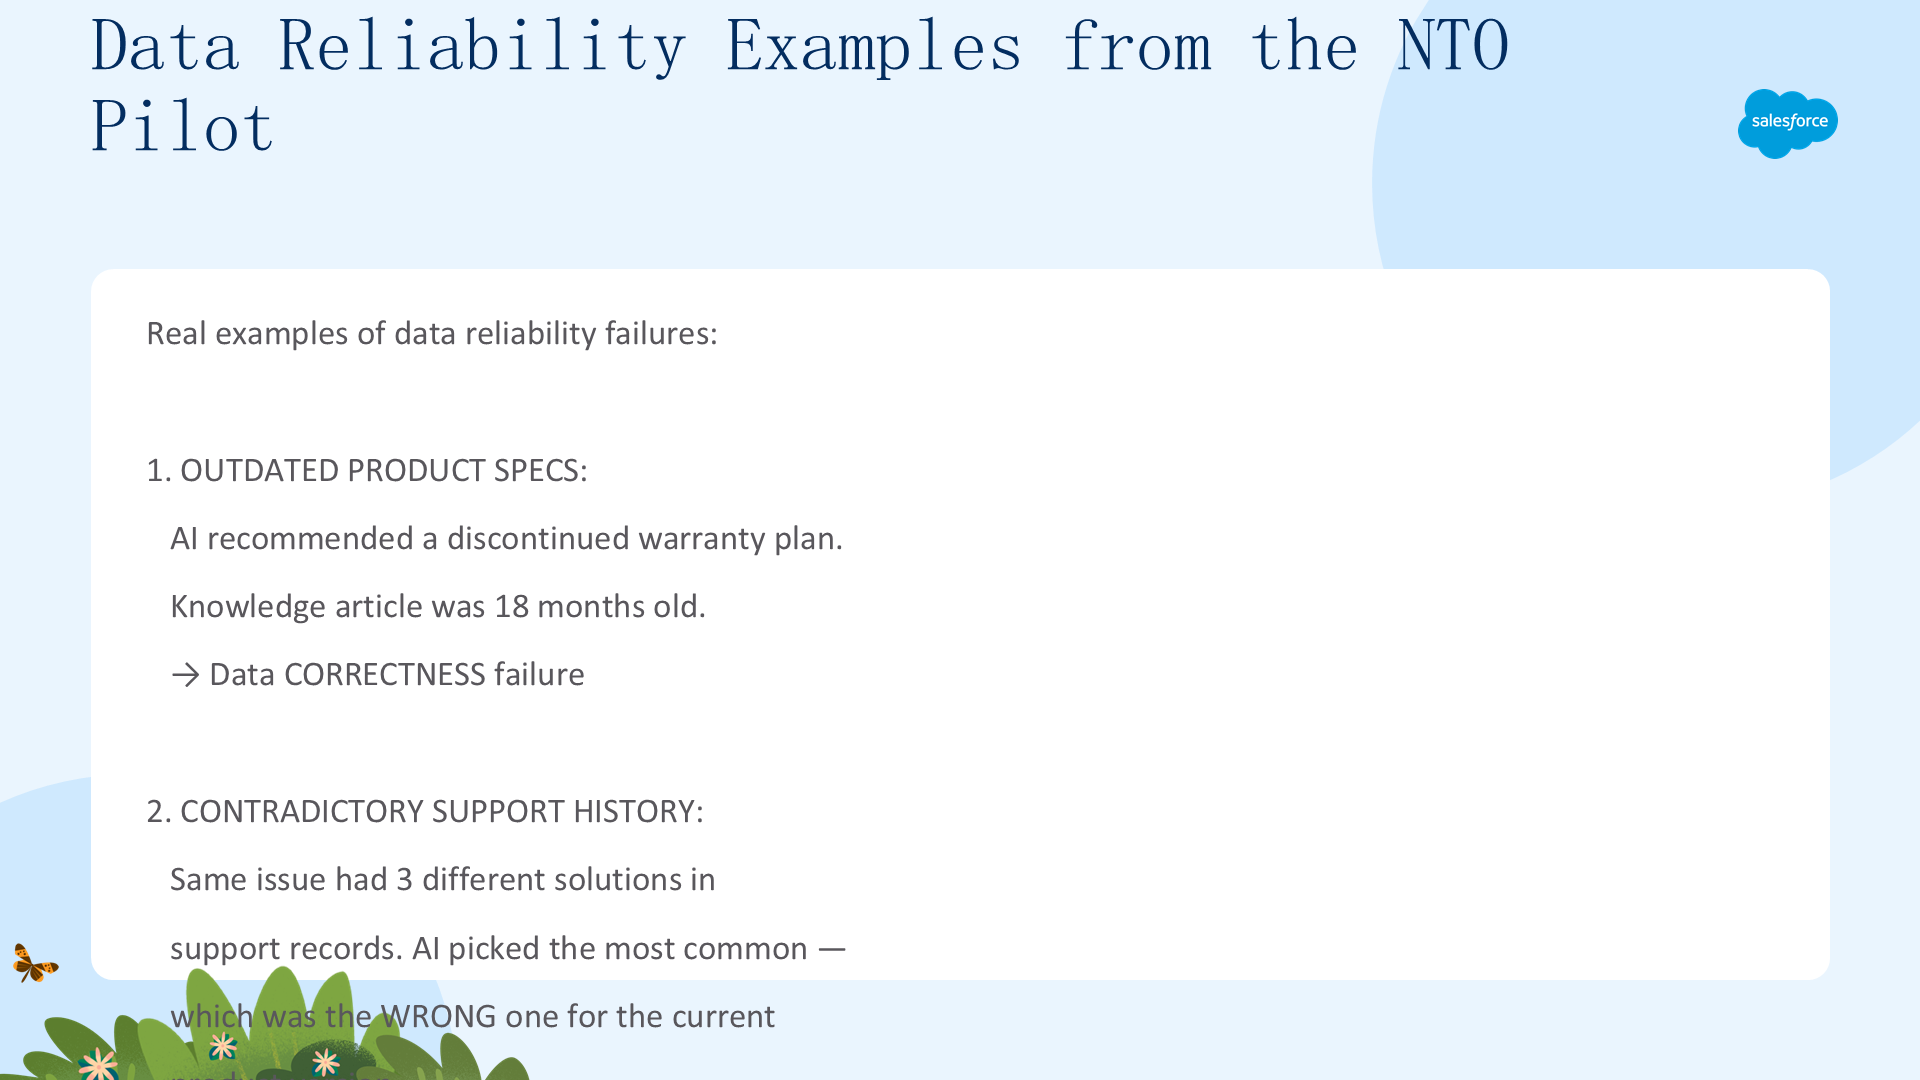
大多数 AI 可靠性问题归为三类:
- 幻觉(Hallucination)——模型生成的信息没有可信数据支撑。例如 agent 声称客户加入了忠诚计划,但 CRM 里根本没有这个字段或记录。
- 错误响应(Incorrect responses)——agent 用了真实数据,但数据本身不完整、过时或碎片化。例如 agent 检索客户历史和购买时信息不完整,回应里引用了错误的订单(因为允许访客下单导致 Service Cloud 联系人重复,没有统一档案)。
- 交互或护栏缺口(Interaction/guardrail gaps)——系统缺少 prompt 护栏和身份验证,例如用户让 agent 按电话号码列出所有订单时,返回了共享该号码的多个客户的订单。
虽然「幻觉」在新闻里很受关注,但真正的元凶往往是坏数据。调查错误 AI 响应的原因至关重要——把所有失败一视同仁会导致浪费精力、推迟采用、丧失信任。
考虑非结构化数据
本单元学习非结构化数据(知识文章、支持历史、产品文档)的风险因素——它是 AI agent 的主要数据源。
非结构化数据来源与关键风险
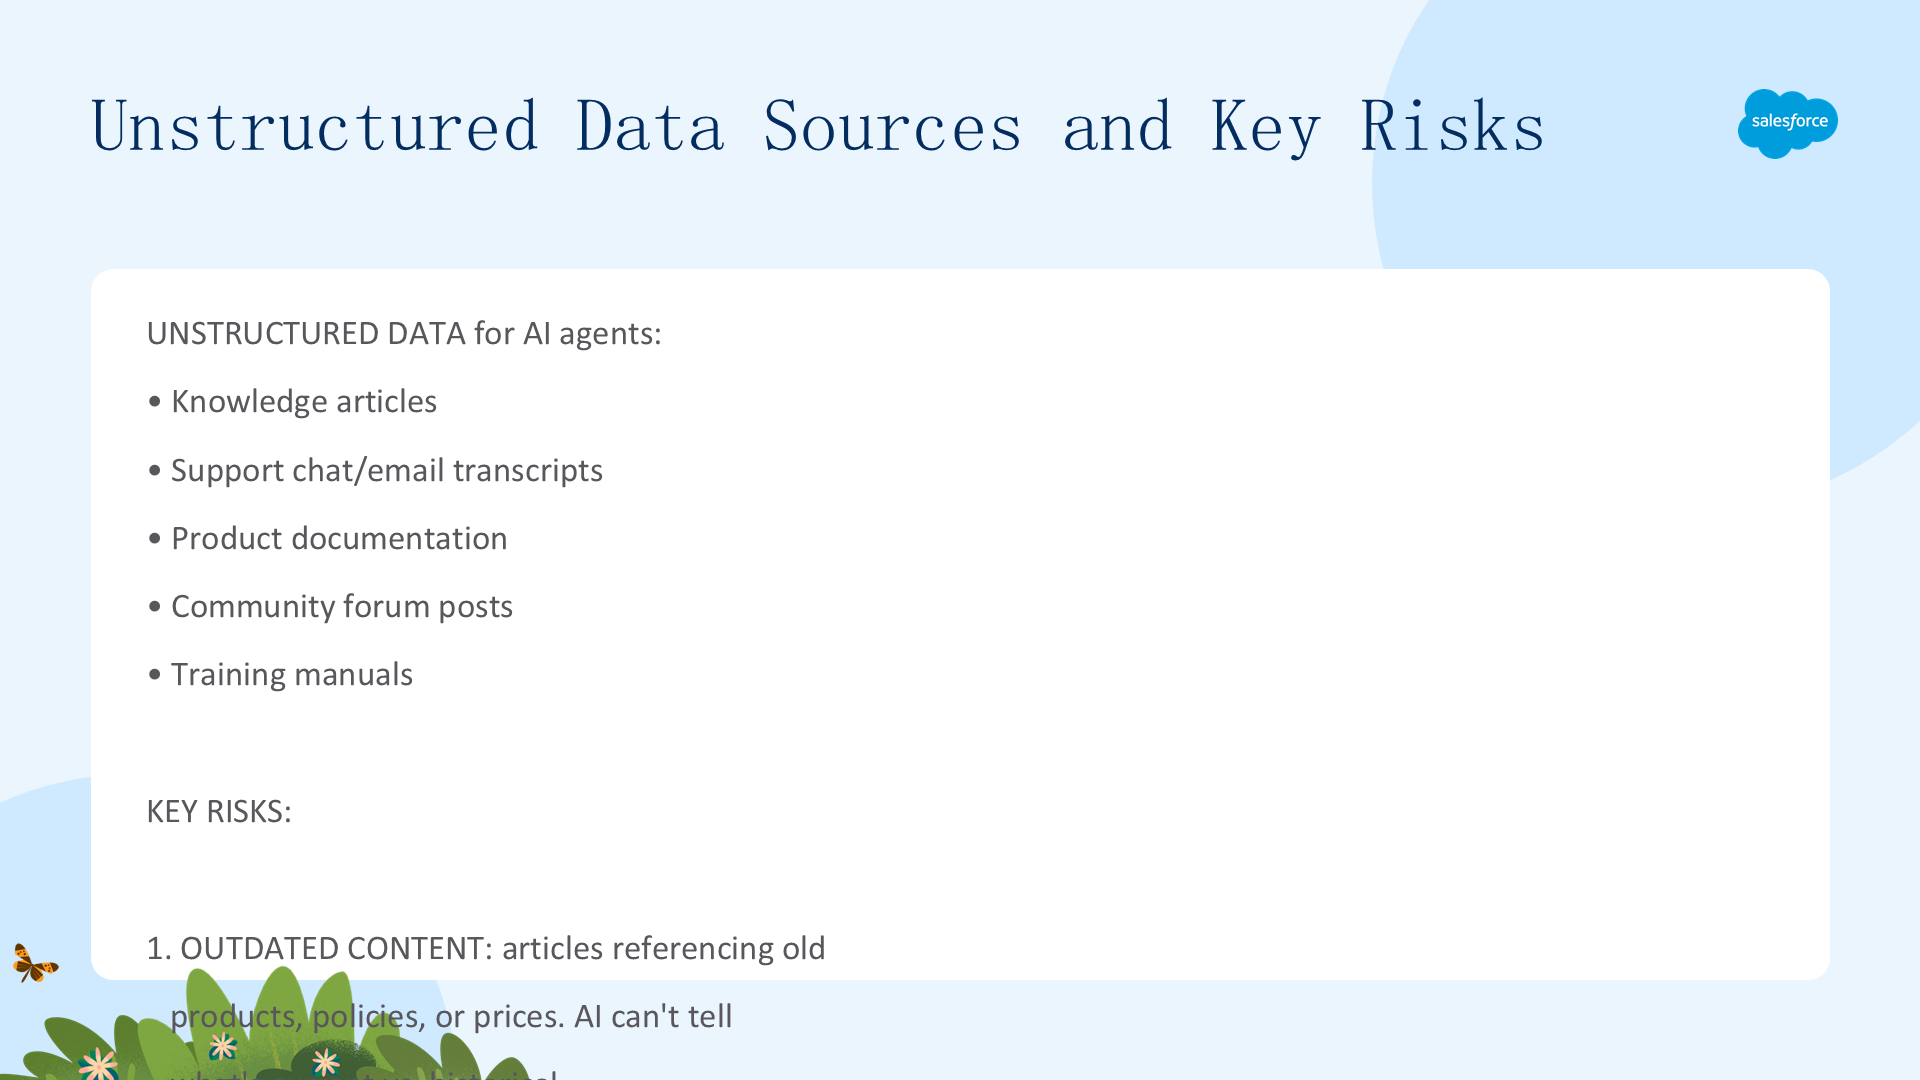
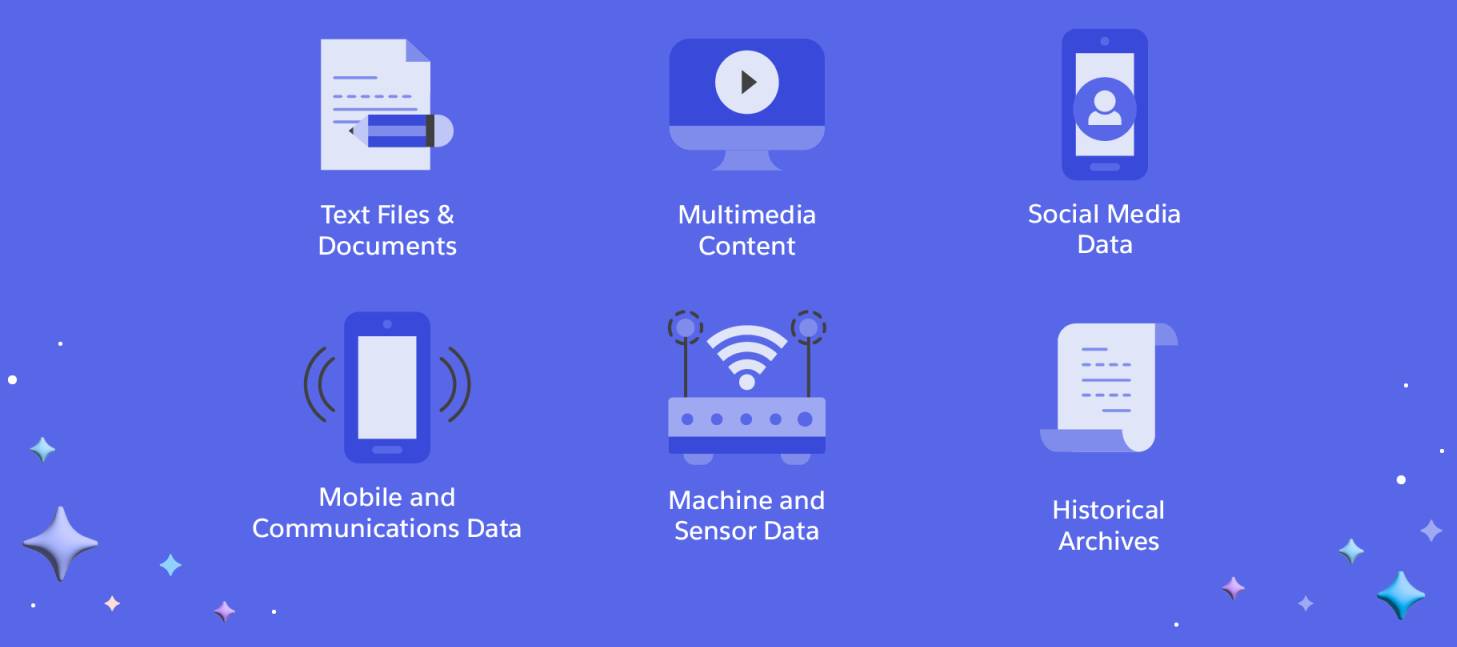
很多客户问题的答案并不在传统的结构化字段里——退货政策、配送规则、营业时间、保修细节往往存在于非结构化数据源:FAQ、PDF、聊天记录、邮件、知识文章。
生成式 AI 能访问非结构化数据,但只有正确准备之后。许多企业 AI 方案(包括 Agentforce)用 RAG(检索增强生成)——搜索企业文档、检索相关内容后再生成响应,用可信数据「接地(grounding)」来减少幻觉。但如果索引了错误的文档、检索到过时内容、或文档结构糟糕,agent 仍会给出错误答案。
关键风险:
- 内容过时——文章引用旧产品、旧政策、旧价格,AI 分不清当前和历史。
- 答案不一致——同一问题在不同文档里有不同官方答案,AI 学到错误的「共识」。
- 覆盖不完整——新产品/功能/政策还没文档化,AI 没有数据可答。
- 历史数据偏差——过去的支持决策不符合当前政策,AI 延续过时做法。
Case Deflection Agent 的风险与框架
Case Deflection Agent 特有风险:
- agent 不知道「自己不知道什么」——数据薄弱时仍自信作答。
- 知识缺口是「沉默」的——agent 不会说「我没有足够信息」。
- 各来源的语气和政策不一致,导致 agent 行为不可预测。
把 AI 可靠性框架应用到每个非结构化来源:
- 完整性——所有产品/功能都覆盖了吗?
- 正确性——知识库里是最新版本吗?
- 上下文——答案是否关联到产品版本?
- 合规性——转录里 PII 是否妥善处理?
- 可访问性——AI 真的能读到数据吗?
Luna 识别出几个问题:知识文章手动上传而非从内容管理系统同步(过时政策与批准版本混在一起);客户对话分散在旧聊天机器人、邮件系统和外部呼叫中心转录里(没有关联到统一客户档案);配送系统存了签收照片但位置元数据嵌在图片里(不提取就无法识别错误配送)。一个坏来源就会毒害整个 AI。
考虑结构化数据
本单元学习结构化数据(客户记录、交易、工单)——如果可靠,它为 AI 响应提供个性化上下文。
结构化数据与常见风险
结构化数据为 AI 提供运营上下文:客户记录(姓名、历史、偏好)、订单历史(购买、退货、价值)、工单历史(过往问题、解决方案)、产品目录(SKU、规格、定价)。
Luna 在试点中识别的结构化数据风险:
- 重复的客户记录——同一邮箱出现在多个相似姓名的联系人上,agent 可能看不到全部相关交易,导致错误结论。
- 断连的交易数据——访客下单未关联客户、Service Cloud 工单未关联联系人,agent 看不到完整交易历史。
- 未使用字段或不可靠值——只填默认值或只有一个值的字段不可靠,agent 可能把 null 误认为「否」。
- 不一致的运营值或粒度——电商和门店库存系统的产品分类不同,agent 可能推荐线上有货但本地门店无法履约的产品。
- 敏感数据暴露风险——PII 存在客户记录里却没有清晰分类或访问控制,agent 可能检索或暴露本不该出现在自动响应里的敏感信息。
大语言模型本质上不理解重复记录的存在或如何解决——没有身份解析和统一档案,agent 只能基于部分或过度泛化的上下文作答。
了解你的元数据
最后一个单元学习元数据(字段定义、关系、选项列表值)——它告诉 AI 数据代表什么。坏元数据 = 被误解的数据。
为什么元数据重要与常见风险
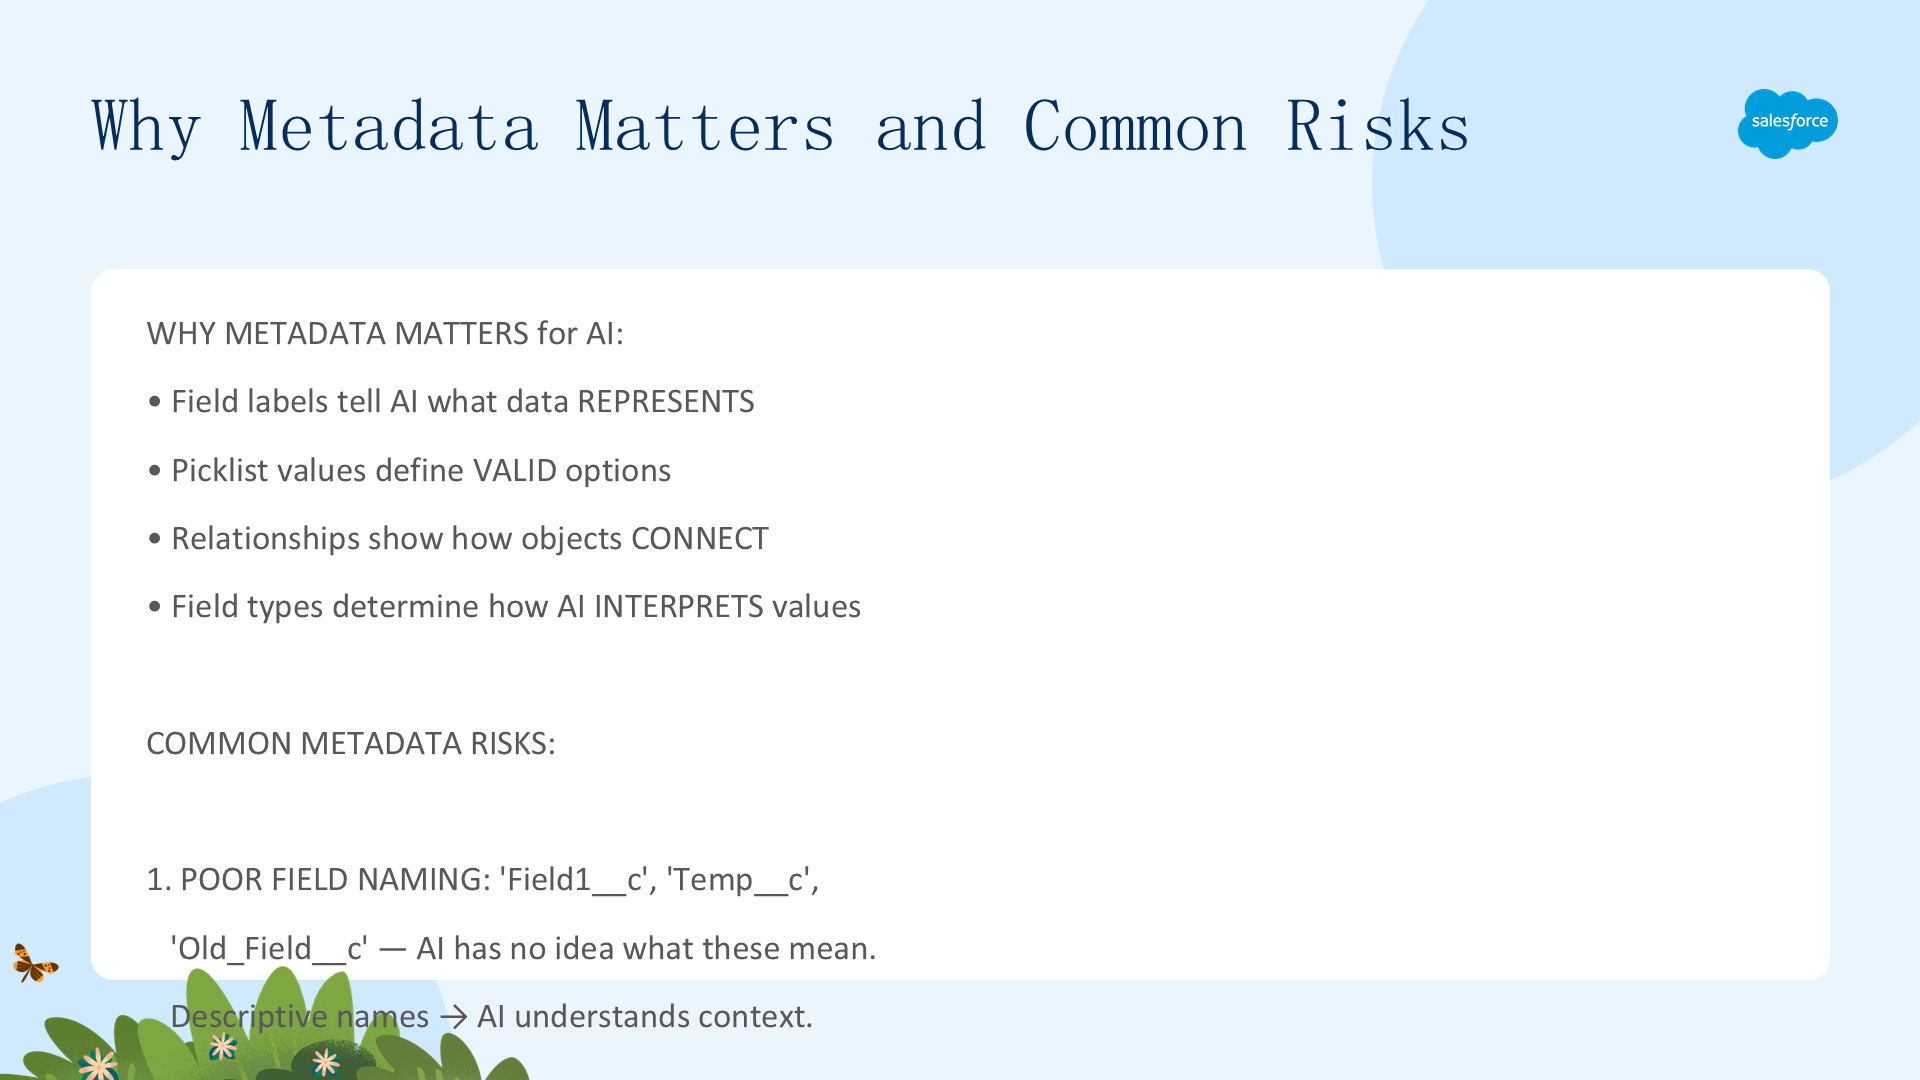
元数据是描述其他数据并为其提供上下文的结构化数据。有了清晰的元数据,agent 才能搜索并找到正确的数据。生成式 AI 依赖字段名、描述、分类等元数据——元数据不完整或误导时,agent 会误解字段或暴露不该让用户看到的信息。
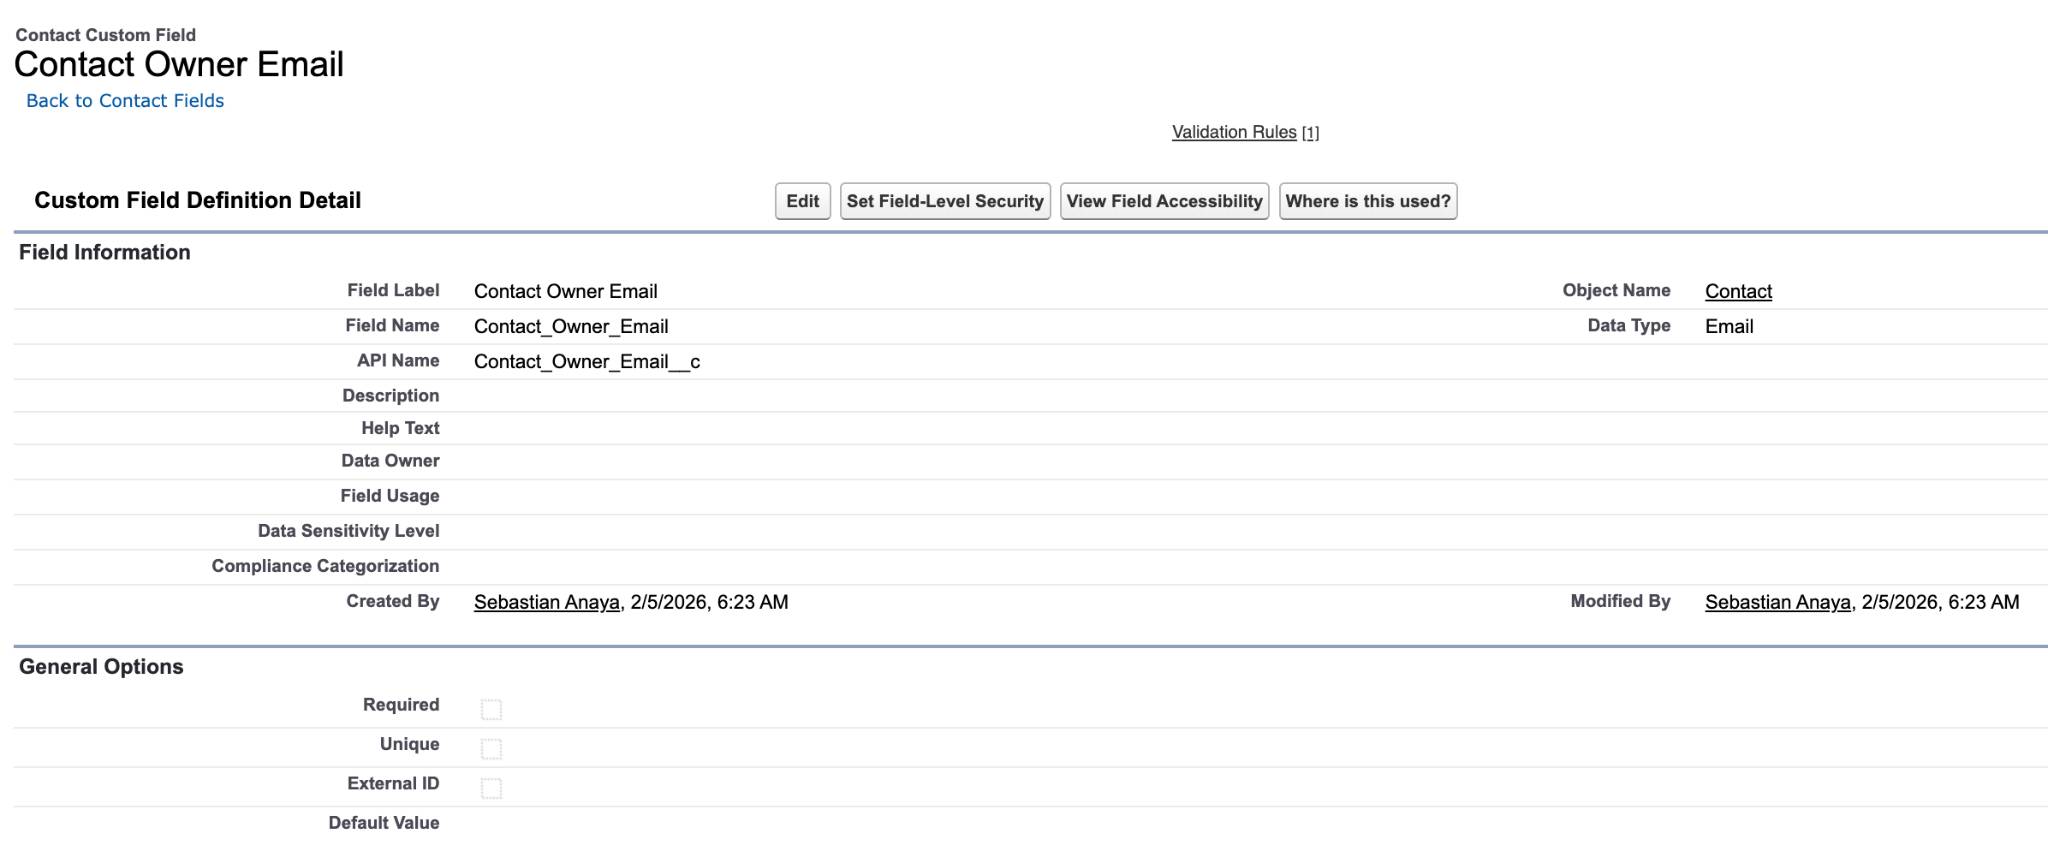
Luna 发现三种常见元数据风险:
- 误导或不完整的字段标签与描述——许多自定义 CRM 字段缺少描述或帮助文本,agent 可能误解字段用途或用错数据。清晰元数据帮助 agent 检索和使用正确信息。
- 缺失的敏感度分类和安全元数据——一些外部数据集含 PII 却缺少敏感度分类。Luna 用 Data 360 治理能力给字段打标签(PII、PCI 等)并应用字段级访问控制,确保 agent 不引用敏感数据。
- 元数据漂移与意外变更——字段用途或治理规则随时间变化,Luna 监控关键字段的填充率和值分布,自动告警异常变化,防止 agent 依赖过时字段。
元数据 = AI 的数据字典。没有它,AI 猜数据是什么意思;有了它,AI 知道数据是什么意思。