学习目标
完成本模块后,你将能够:
- 解释为什么数据清洗是数据质量的基础。
- 识别数据清洗所处理的常见数据问题类别。
- 描述数据清理的最佳实践。
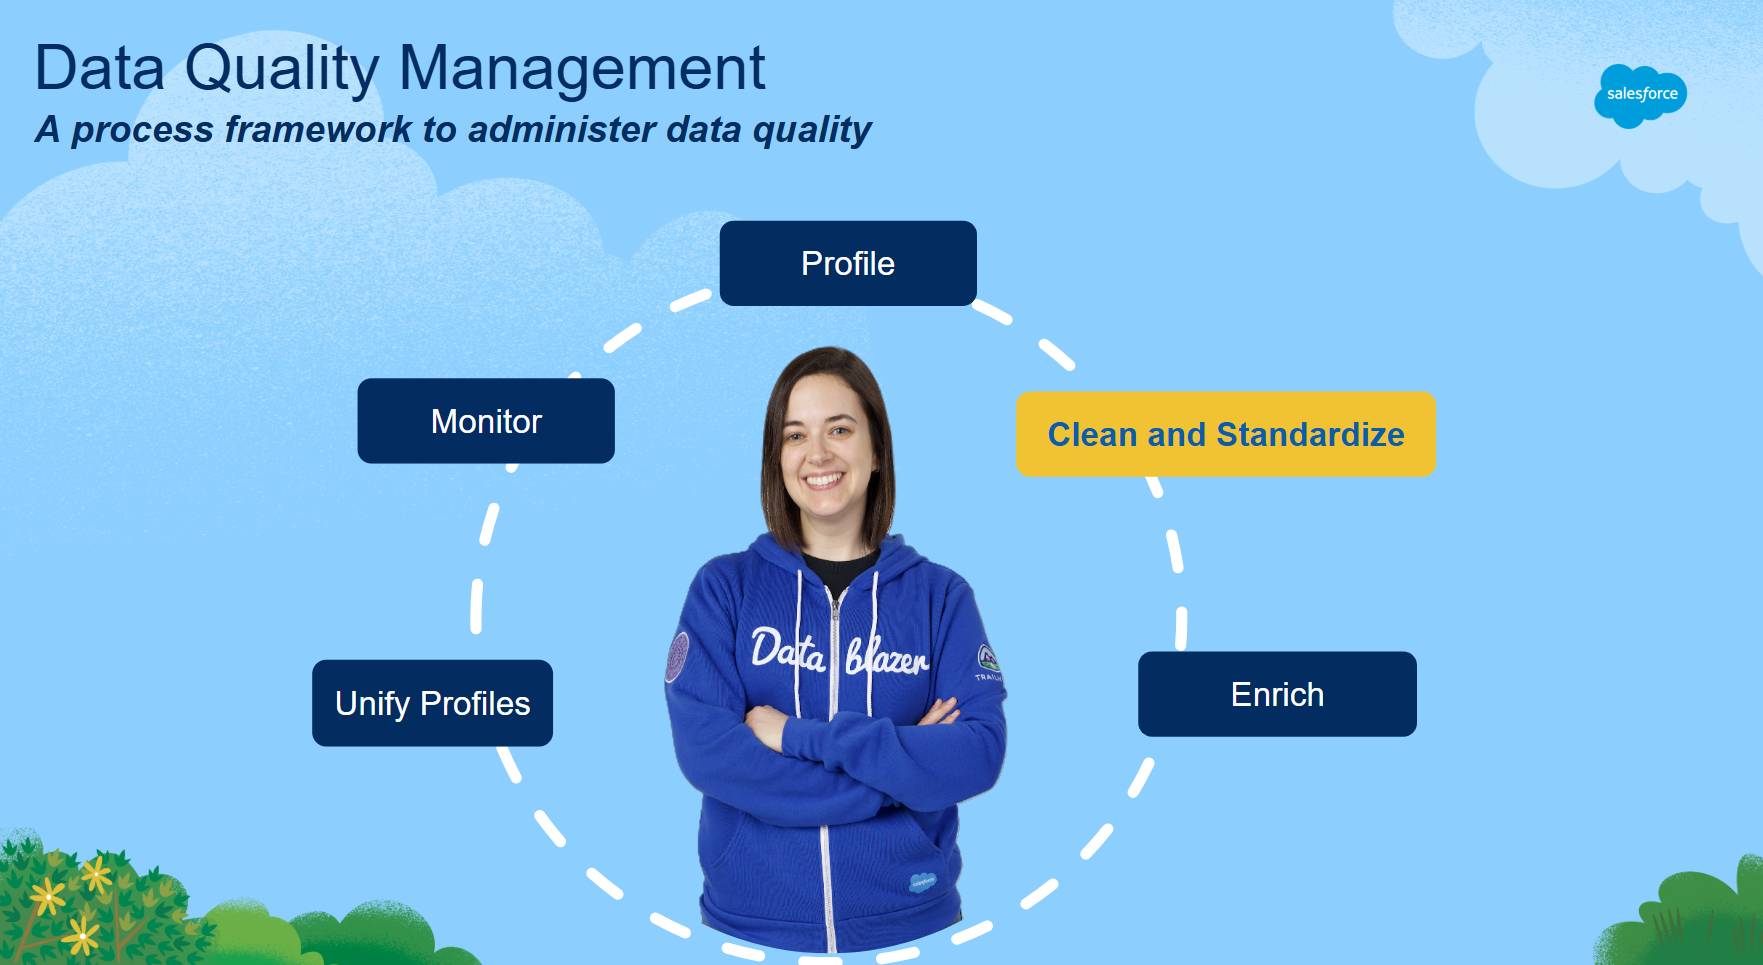
在 Salesforce 数据质量管理框架中,数据清洗是继数据画像(profiling)之后的第二步——先搞清楚问题出在哪里,再优先修复最可能导致错误的问题。在丰富数据或统一档案之前先做清洗,能让你更高效地工作、降低可避免的风险。
什么是数据清洗?
数据清洗(Data Cleansing)是让数据适合业务用途的关键流程:纠正错误、标准化不一致的值、移除或过滤不相关的数据,并处理会带来下游风险的情况。
清洗放在数据画像之后是有原因的——一旦你理解了问题发生在哪里,就应该先修复最可能引起错误的那些问题。在丰富数据或统一档案之前先清洗,能提高效率、降低可避免的风险,并立刻看到业务和技术上的收益。
探索示例:准备 NTO 的客户支持数据
Northern Trail Outfitters(NTO)正准备推出一项新的客户服务计划:帮助客服代表更快地解决工单、提供更个性化的支持,并在合适时推荐相关产品。NTO 还计划用 AI agent 回答常见问题。
数据架构师 Luna 加入后运行了数据画像评估,发现了几个可能拖慢计划的问题:
- 未使用或很少使用的字段让界面杂乱、拖慢客服代表。
- 重复的客户记录让代表难以找到正确信息、难以理解完整的客户关系。
这些发现表明 NTO 需要在扩展自动化或 AI 能力之前先改善数据的质量和结构。脏数据 → 脏 AI;干净数据 → 可信 AI。
需要数据清洗的常见问题 (1)
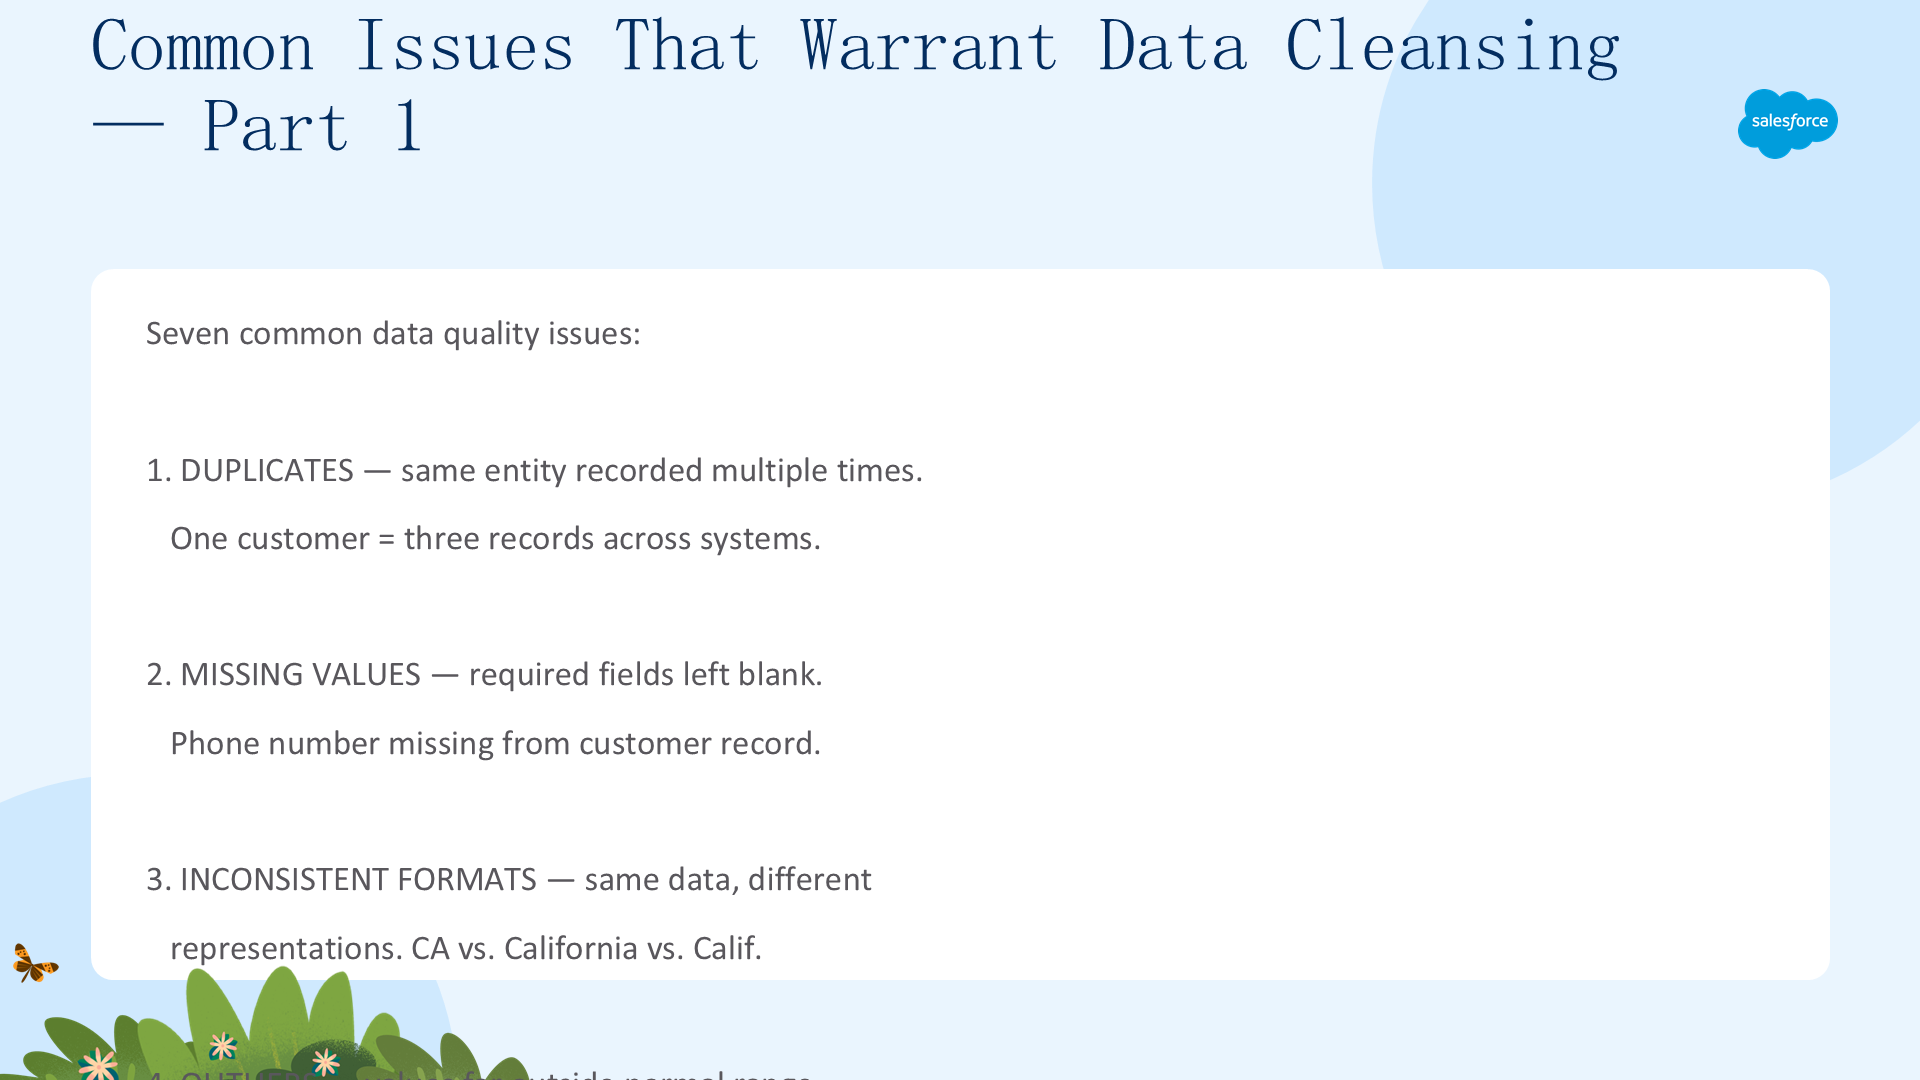
数据清洗不是单一任务,而是针对不同类别数据问题的一组方法。常见的数据质量问题前四类:
- 重复(Duplicates)——同一实体被记录多次,一个客户在多个系统里有三条记录。
- 缺失值(Missing Values)——必填字段留空,例如客户记录缺少电话号码。
- 不一致的格式(Inconsistent Formats)——相同数据有不同表示,如 CA vs. California vs. Calif。
- 异常值(Outliers)——远超出正常范围的值,例如办公用品类别里出现 100 万美元的咖啡订单。
需要数据清洗的常见问题 (2)
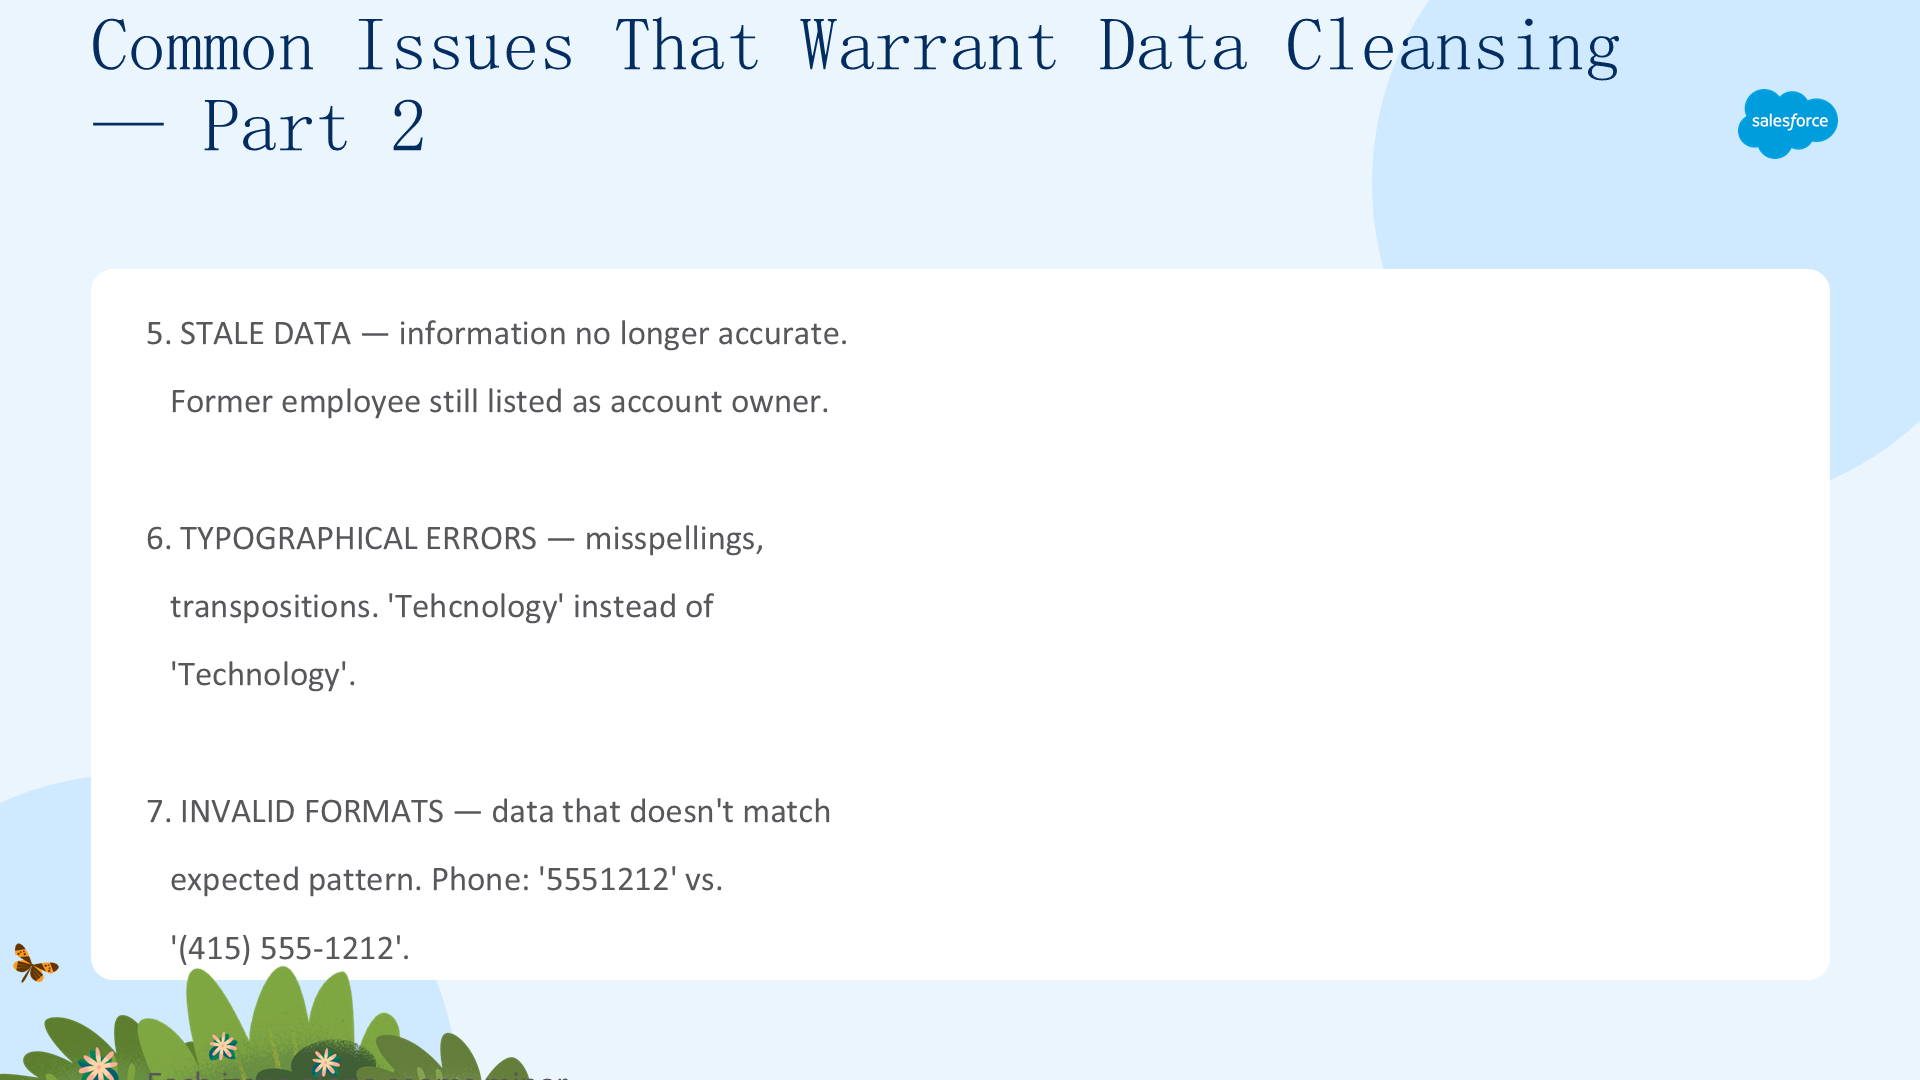
其余三类常见问题:
- 过时数据(Stale Data)——不再准确的信息,例如前员工仍被列为账户负责人。
- 拼写错误(Typographical Errors)——拼错或字母颠倒,例如把「Technology」写成「Tehcnology」。
- 无效格式(Invalid Formats)——不符合预期模式的数据,例如电话号码「5551212」vs「(415) 555-1212」。
每个问题单独看都不起眼,但累积起来会侵蚀数据的可信度:用户不再信任报表、AI 产生不可靠的输出、决策建立在错误信息之上。
数据清洗最佳实践
无论具体目标是什么,数据清洗都是循序渐进的流程。遵循这些实践能避免代价高昂的错误、返工或白费力气。核心是「先画像 → 再优先 → 然后标准化 → 自动化 → 记录 → 测试 → 持续监控」这条生命周期。
最佳实践清单
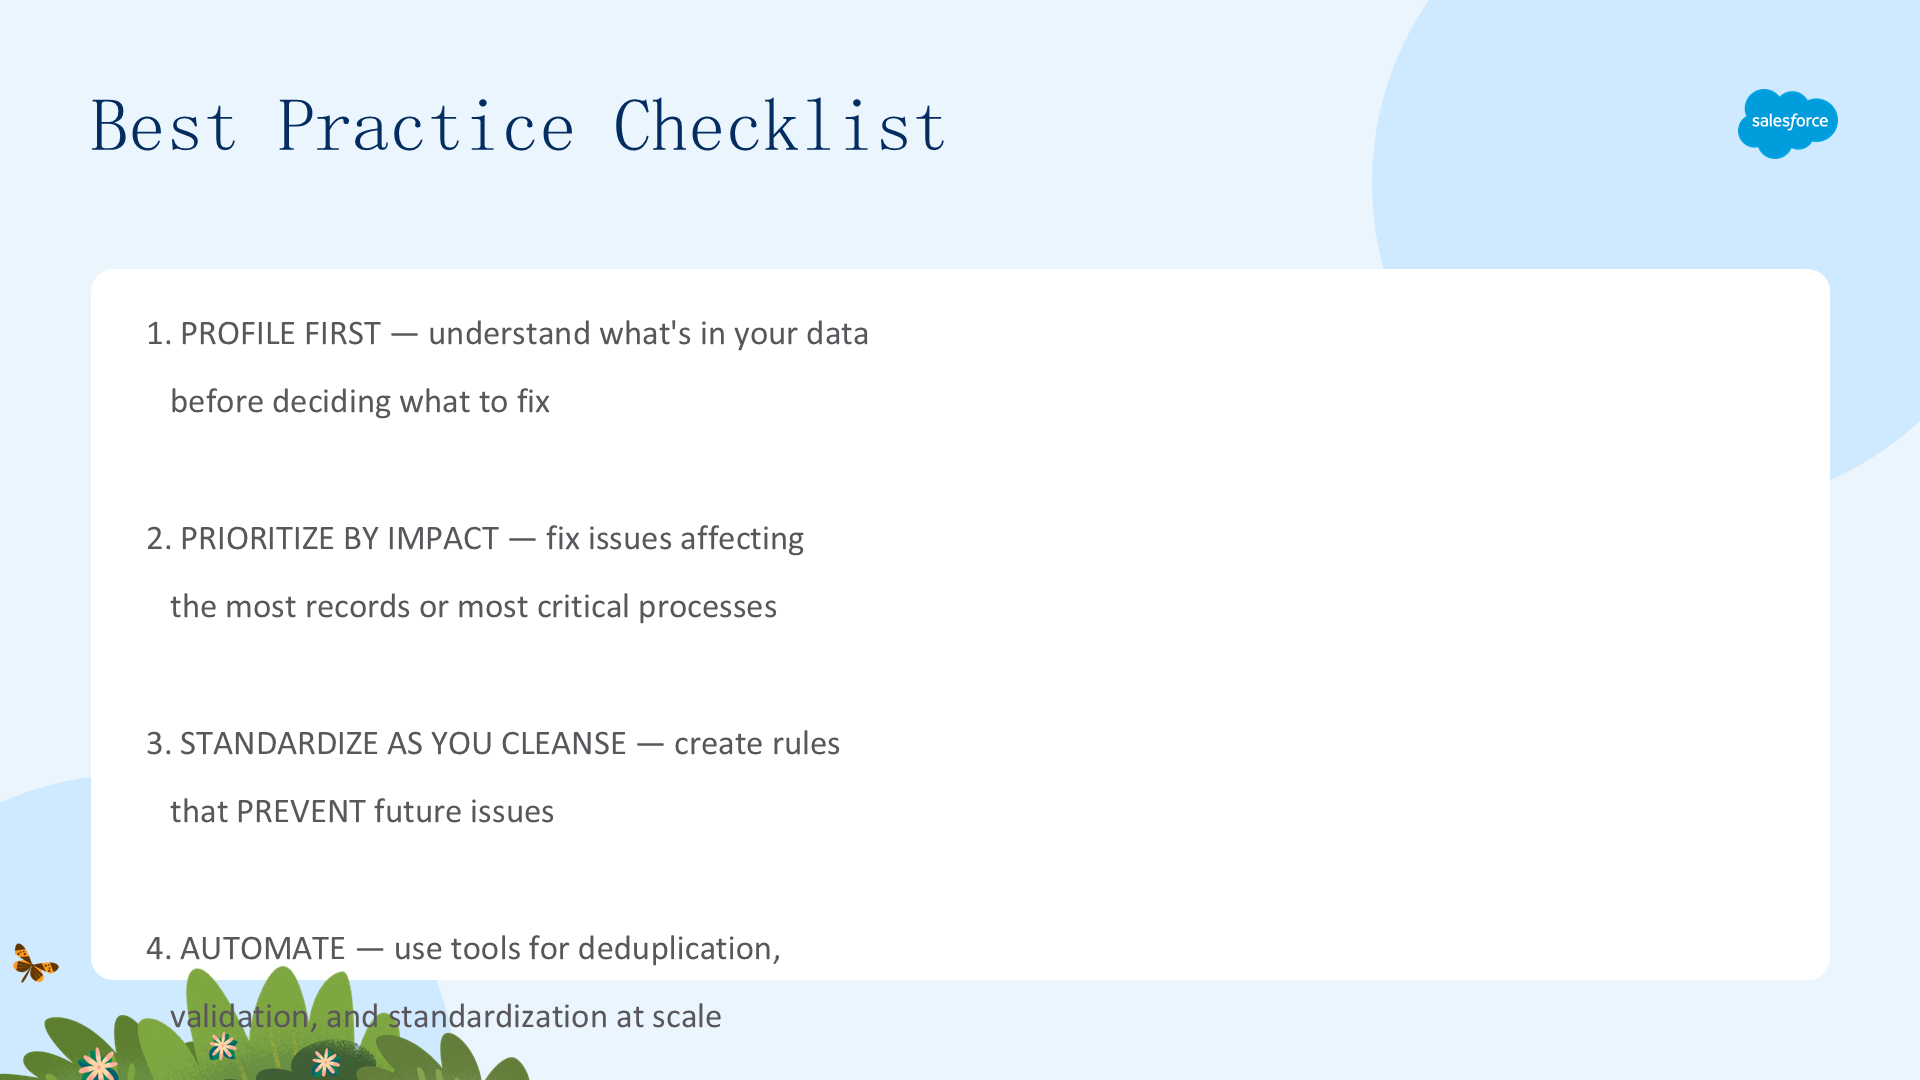
数据清洗最佳实践清单:
- 从业务需求出发——明确是什么驱动了清理计划(可用性投诉、即将到来的 AI、数据迁移或 Data 360 分析项目)。
- 画像以识别问题和根因——用数据画像审查范围内对象。
- 按数量和影响排序——聚焦影响最多数据、对报表/自动化/分析/AI 影响最大的问题。
- 记录决策并对齐干系人——清洗决策常影响服务、运营、数据治理等多个团队。
- 按问题类型选择正确的补救方法——标准化不一致值、移除坏数据,但不要只因「看起来像重复」就合并记录。
- 用证据验证(前后对比)——在沙箱里跑画像设基线,应用变更后再画像确认改进。
识别并管理重复记录
本单元探索重复记录、钥匙环 vs 黄金记录的区别,以及错误匹配(false match)的风险。
构建客户上下文的挑战
客户数据分散在多个系统里:CRM、ERP、电商、支持系统——每个系统对同一个人只有部分数据,没有一个系统有完整画像。构建客户上下文需要把这些碎片连接成统一视图。
挑战在于:不同系统用不同的标识符、不同的格式、不同的完整度。Luna 要开始一个叫身份解析(identity resolution)的流程——匹配记录以统一客户档案。统一的客户档案作为单一事实来源,让团队看到清晰、完整、最新的客户视图。
碎片化数据 → 不完整的客户理解;连接起来的数据 → 360 度客户视图。
探索重复与断连风险 (1)
重复(Duplication)是同一实体被记录多次。原因包括:多个数据录入点(网页、POS、呼叫中心)、系统迁移和并购带来的重叠数据、导入时缺少匹配规则、以及人为错误(姓名/地址的拼写差异)。
无意重复(Unintentional duplicates)——两条或多条记录代表同一实体,应视情况在记录系统里合并。有意重复(Intentional duplicates)——出于治理或运营原因有意区分的记录,不应合并,而应统一(如渠道隔离)。
探索重复与断连风险 (2)
断连(Disconnection)是相关的记录没有连接起来。例如客户的工单存在支持系统里,却没有连到同一客户在订单系统里的订单历史。
重复和断连的风险:
- 客户数量虚高(一个人被算三次)。
- 沟通不一致(同一个人的不同版本收到不同邮件)。
- 分析和报表不准确。
- 客户体验差(「你们不是已经有我的信息了吗?」)。
- 错过交叉销售机会。
还有隐形重复(Invisible duplicates)——两条记录因各自字段稀疏(一条只有电话、另一条只有邮箱)而在单个对象内无法匹配,只有结合其他数据源才能发现。
为什么 NTO 的订单头也是客户数据
订单头(order header)包含客户信息:客户姓名、收货地址、联系电话、购买历史。这本身就是身份数据,而不仅仅是交易数据。
把订单头当作客户数据看待,就不会错过这个丰富的身份信息源。订单能告诉你:客户住在哪里(地址)、如何联系他们(电话/邮箱)、他们买什么(偏好、行为)。
每个接触客户的系统都会产生客户数据——要识别它、利用它。例如要正确计算客户终身价值(TLV),所有订单(包括未关联到客户档案的访客订单)都需要匹配并连接到现有客户档案。
区分 Data 360 钥匙环与 MDM 黄金记录 (1)
统一客户数据有两种方法:
钥匙环(Key Ring,Data 360 统一档案):
- 连接所有系统的所有记录,每条记录都是钥匙环上的一把「钥匙」。
- 保留完整的画像,显示数据血缘(每个值来自哪里)。
- 不丢失数据、不丢弃上下文。

每条记录通过 UUID(系统生成的唯一标识)连接,Data 360 能把记录关联起来而不合并它们、不丢失原始上下文。
区分 Data 360 钥匙环与 MDM 黄金记录 (2)
黄金记录(Golden Record,MDM 方法):
- 为每个字段挑选「最佳」版本,创建一条主记录。
- 丢弃其他备选——「John」胜出,「Jon」丢失。
- 丢失来源上下文和数据血缘。
权衡:钥匙环保留一切、智能连接,完整上下文、更多存储、更适合分析;黄金记录挑选赢家、丢弃备选,更简单、更省存储、但丢失细微差别。
Data 360 用的是钥匙环方法——所有记录保留、所有上下文维护。而受监管行业(如医疗、银行)需要单一权威事实来源时,用 MDM 解决方案(可与 Data 360 配合使用)。
检查错误的客户匹配
错误匹配(False Match)——身份解析错误地把属于不同人的记录连接起来。通常是因为用于匹配的数据错误、缺失或误导。
错误匹配很危险,因为它合并了错误的记录,造成客户的错误视图,可能导致:错误的服务决策、错误的分组(细分)、不可靠的 AI 结果。
常见原因:坏数据或误导性数据(如占位邮箱 na@na.com、共享电话号码)、过于频繁使用的异常值(同一地址出现在多个客户)、匹配规则过于宽泛(字段不够唯一)。
预防错误匹配比纠正它更重要——错误匹配的成本通常高于漏匹配。
NTO 的错误匹配
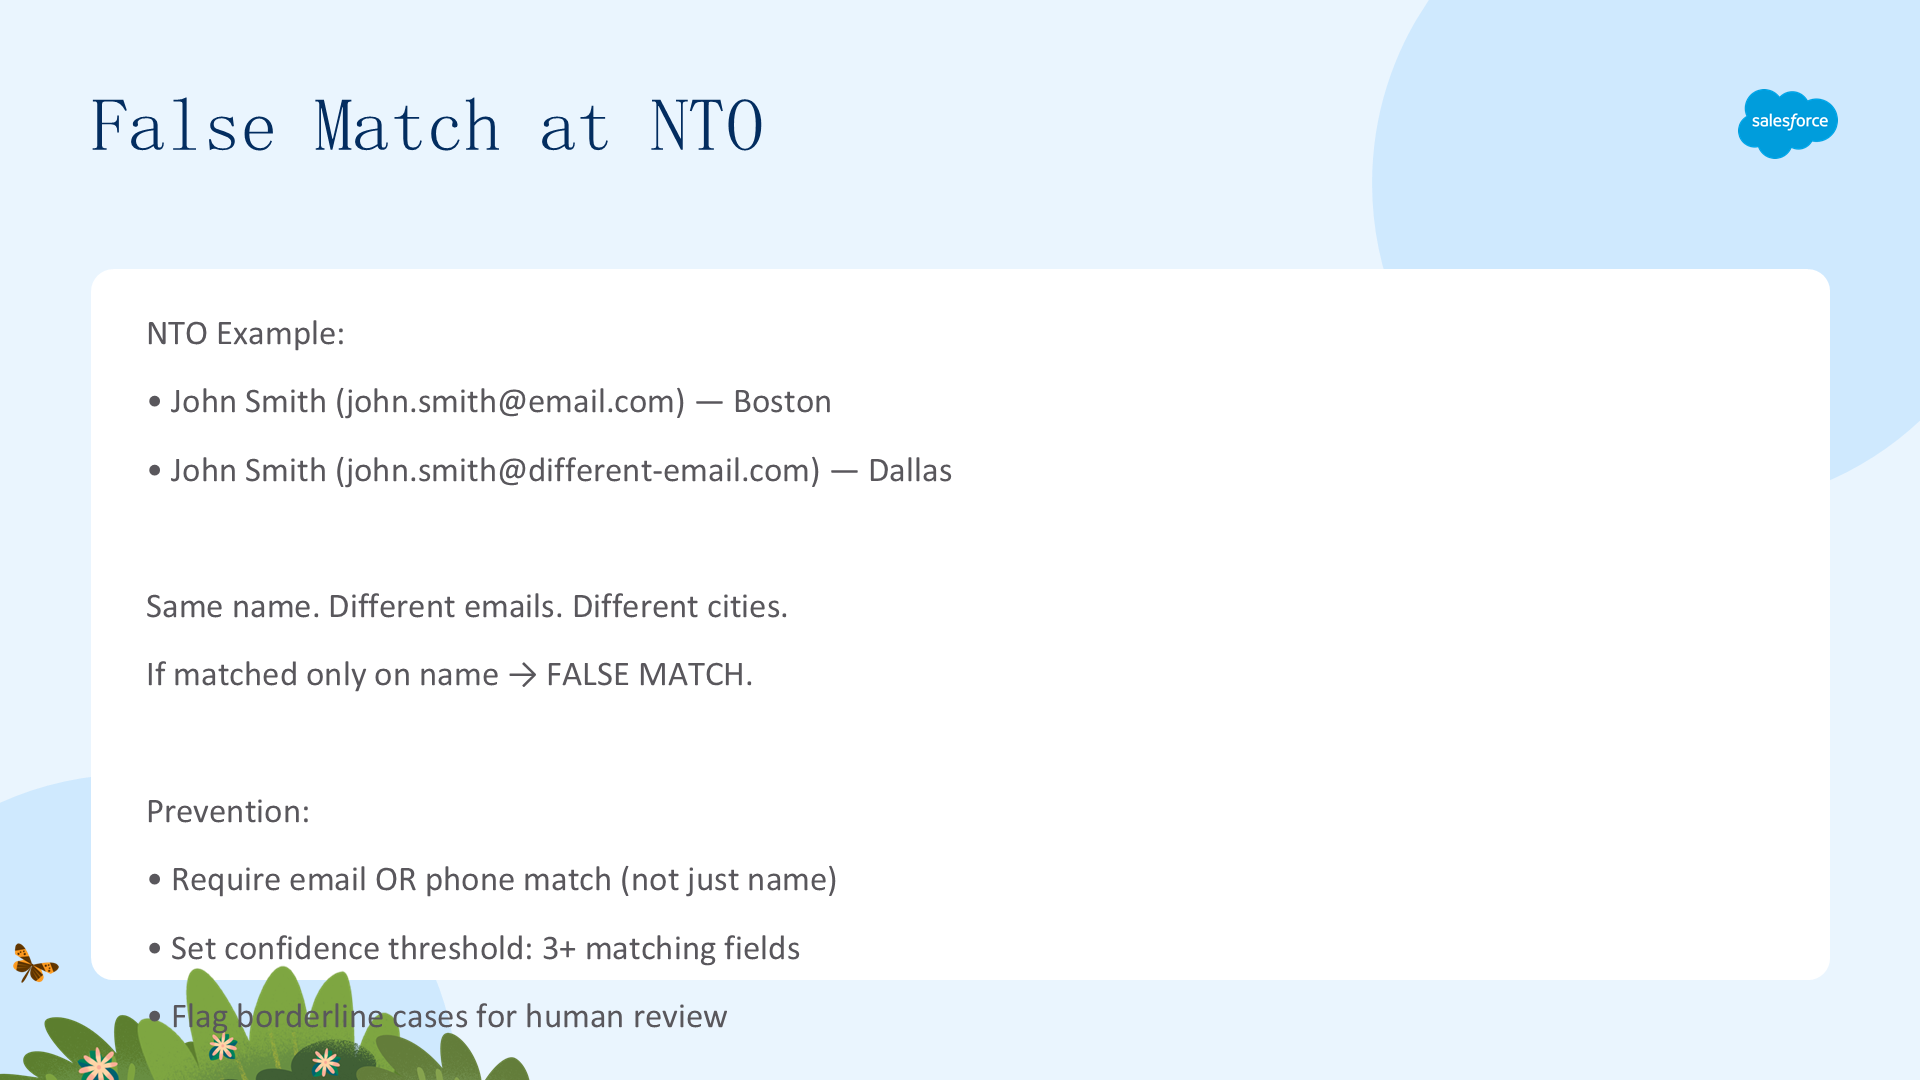
NTO 的例子:Sam Smith 和 Samuel Smith 的邮箱都是 na@na.com。因为这个共享值,他们的记录被合并了——结果客服在服务 Samuel 时可能看到 Sam 的信息,反之亦然。
在医疗或生命科学行业,这类错误可能给客户和组织带来严重后果。
预防措施:
- 要求邮箱或电话匹配,而不是只按姓名。
- 设置置信度阈值(如 3 个以上字段匹配)。
- 把边缘情况标记出来供人工复核。
多因素身份解析就像多因素认证:因素越多,置信度越高。
检测并处理不一致的字段值
本单元学习不一致的字段值——它们看似微小,却会破坏报表、自动化和 AI。
NTO 中影响巨大的小字段问题
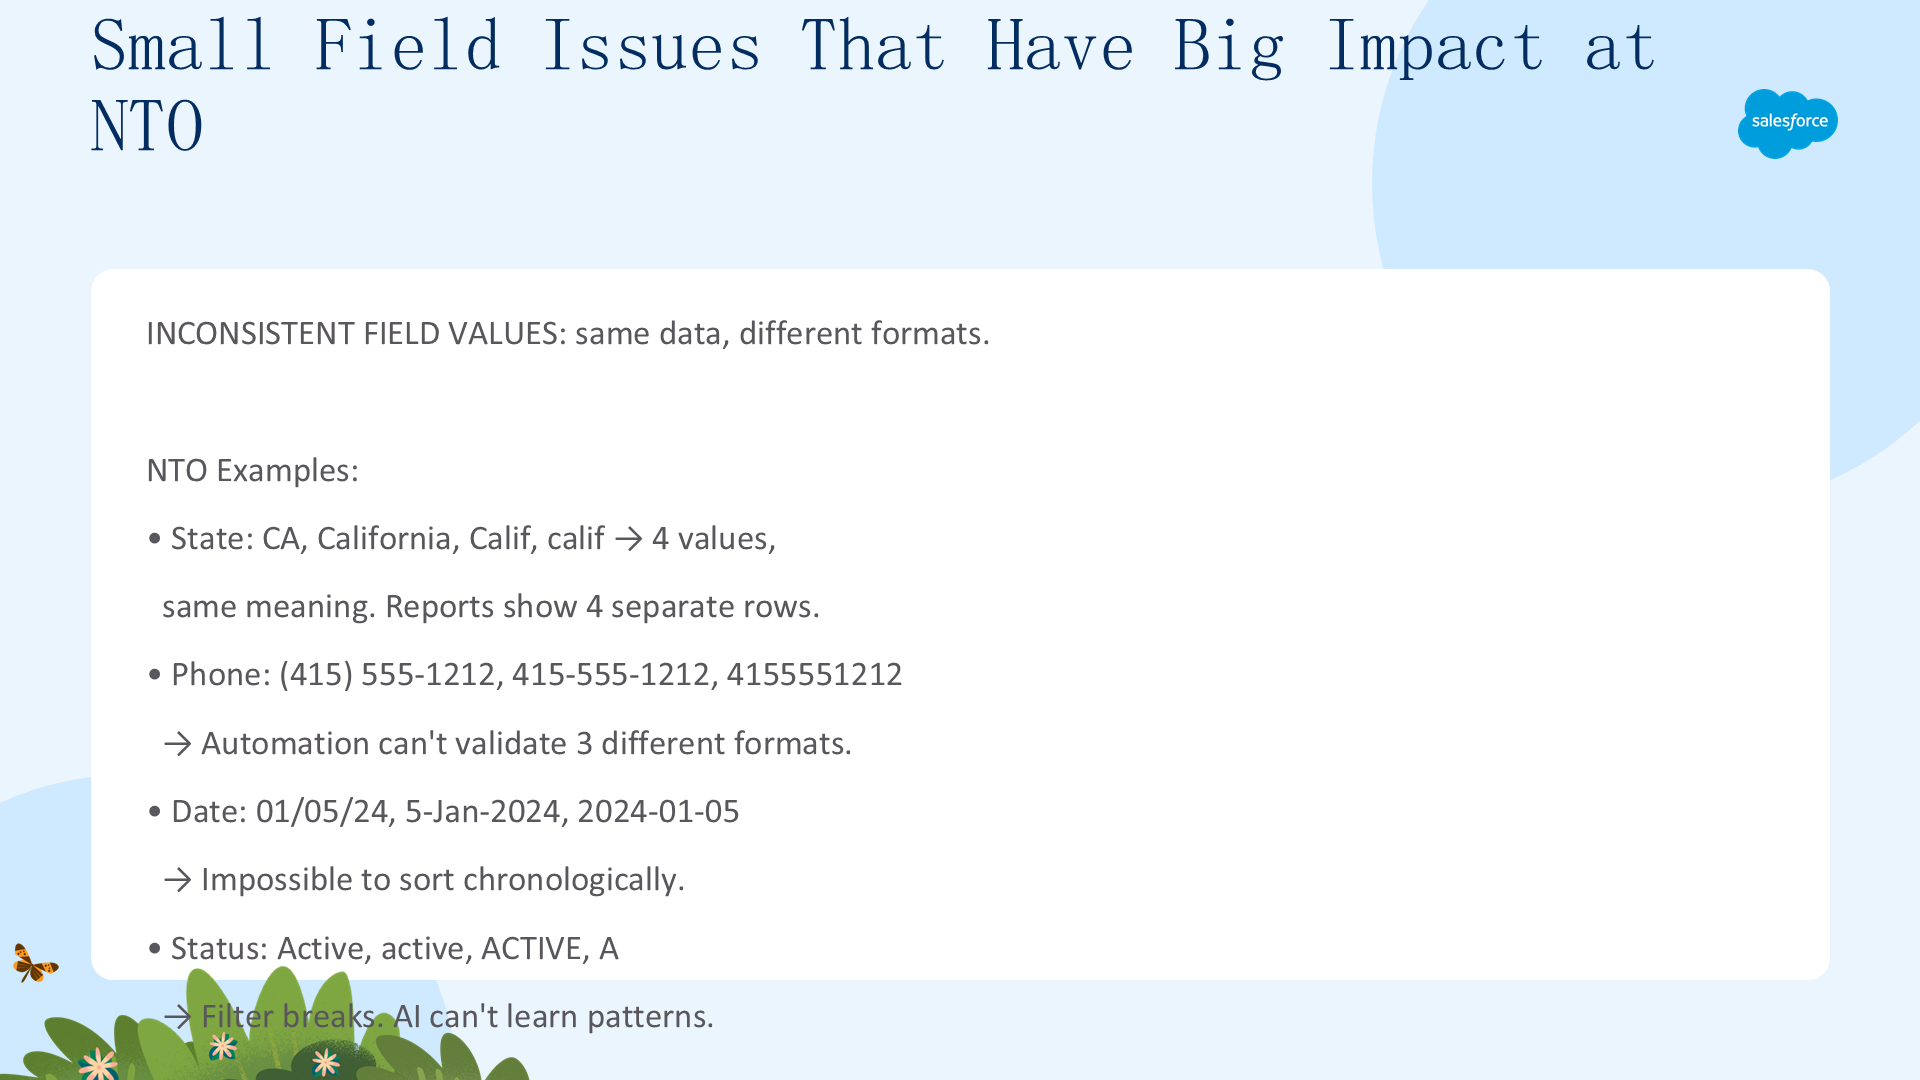
Luna 在画像 NTO 的客户和订单数据时发现,很多问题并不明显,是容易忽略的小问题:
- 同一个意思用不同方式表达,如州名 CA、California、Calif、calif → 报表显示四行。
- 电话号码格式不同:
(415) 555-1212、415-555-1212、4155551212→ 自动化无法验证。 - 日期格式不同:01/05/24、5-Jan-2024、2024-01-05 → 无法按时间排序。
- 状态值 Active、active、ACTIVE、A → 筛选失效,AI 无法学习模式。
每个不一致都很微小,但累积起来对数据质量是毁灭性的:客户和用户沮丧、开发者浪费时间写一次性转换脚本、领导者对 AI 失去信心。
检测与决策:该审查什么 (1)
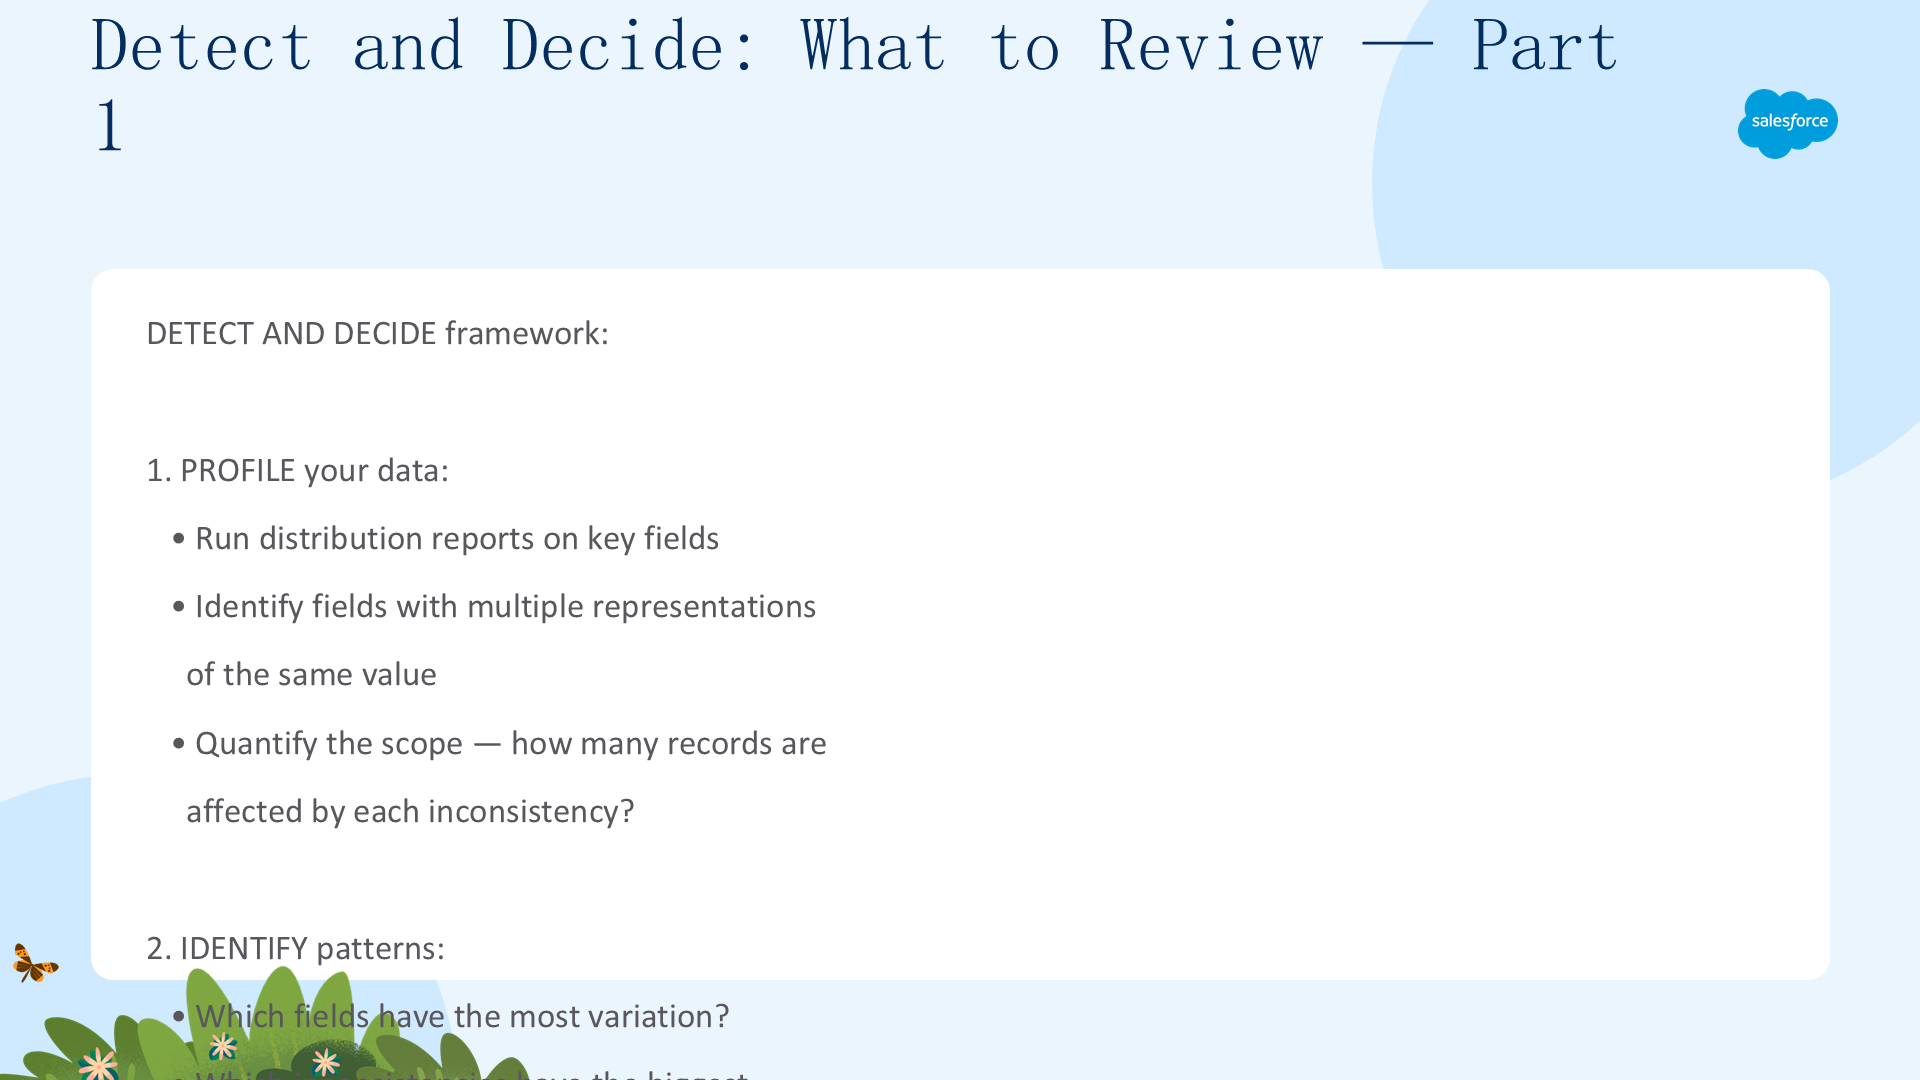
检测与决策(Detect and Decide)框架的第一步是画像数据:
- 对关键字段运行分布报表。
- 识别同一含义有多个表示的字段。
- 量化范围——每个不一致影响了多少条记录?
第二步是识别模式:哪些字段变化最多?哪些不一致对业务影响最大?是否有规律(如导入的记录与手动录入的记录格式不同)?
在动手前先量化范围——影响 5 条记录的不一致,和影响 5 万条的,处理方式不同。
检测与决策:该做什么 (2)
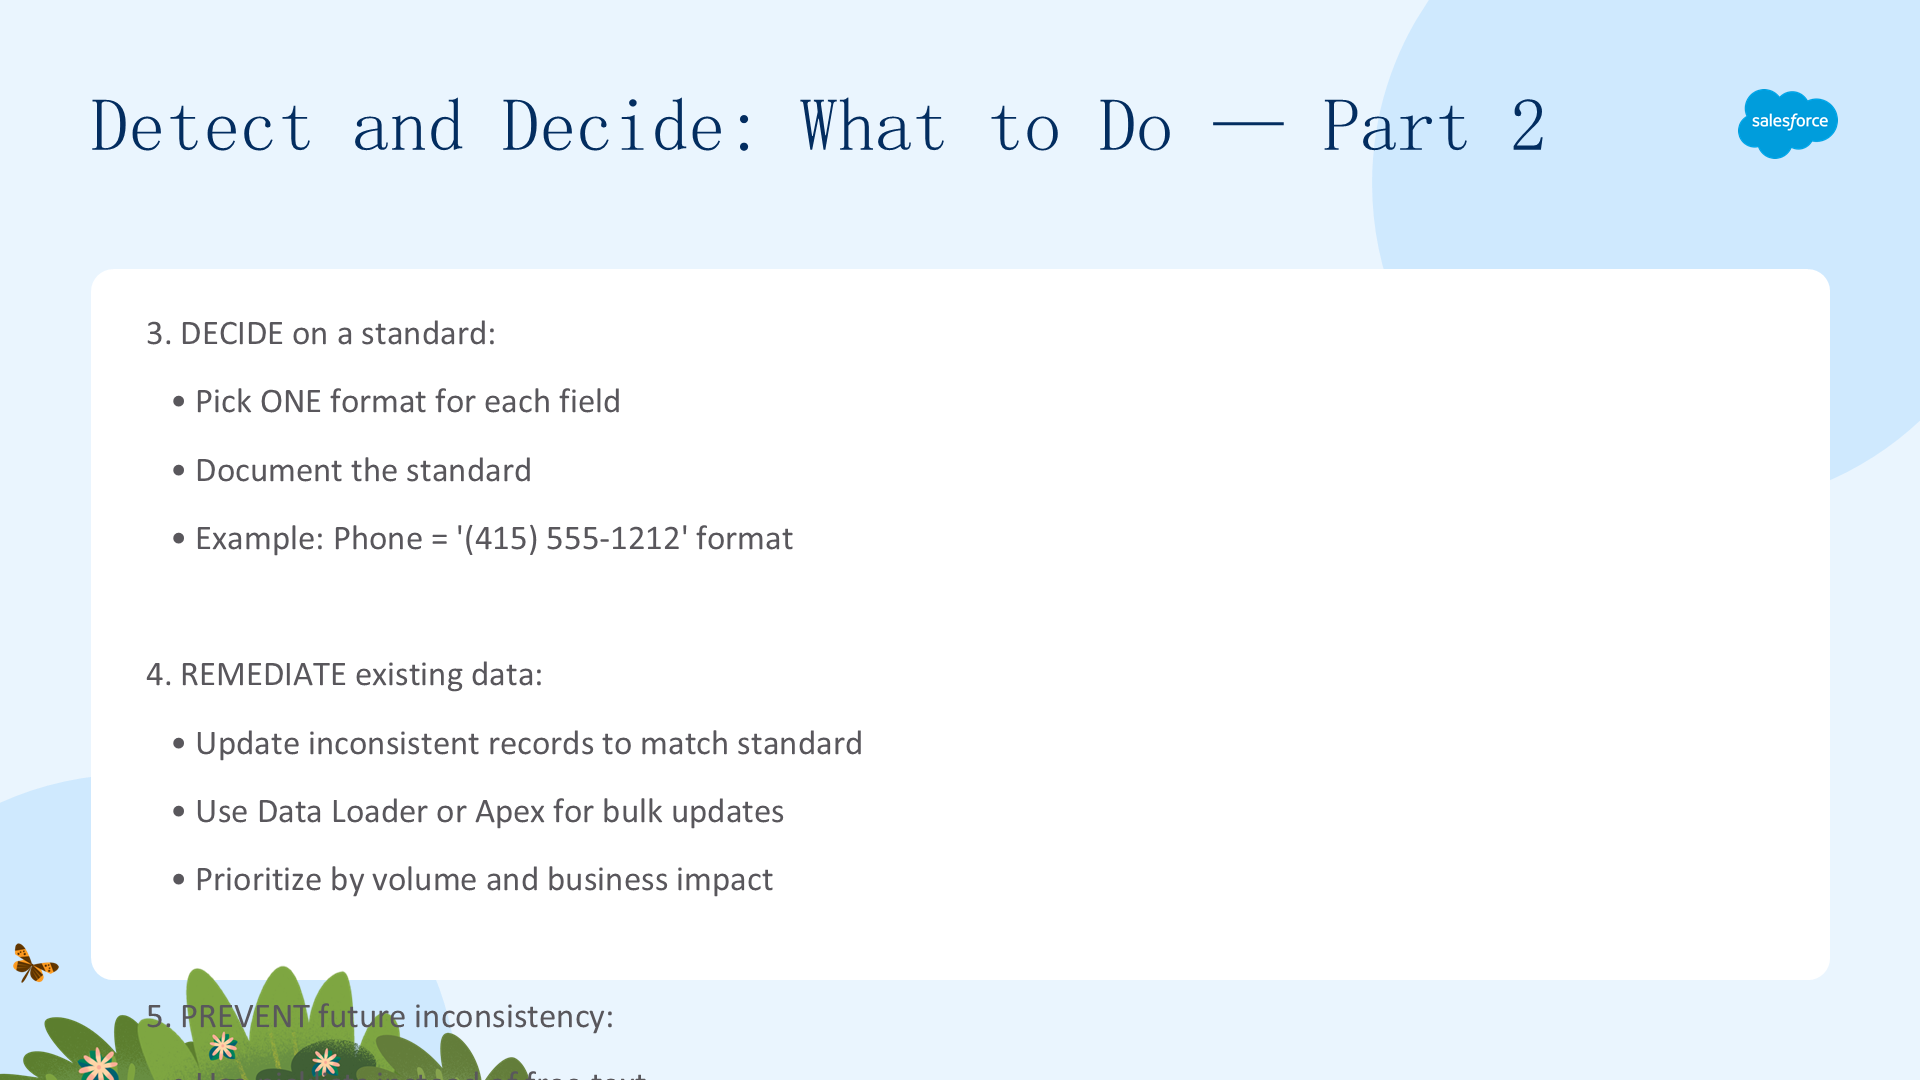
检测之后的行动分三步:
- 决定标准(Decide)——为每个字段挑选一种格式并记录标准(如电话统一为
(415) 555-1212)。 - 补救现有数据(Remediate)——用 Data Loader 或 Apex 批量更新不一致记录,按数量和业务影响排序。
- 预防未来不一致(Prevent)——用选项列表代替自由文本、加验证规则强制格式、在表单上配置输入掩码、导入时自动标准化。
检测 → 标准化 → 补救 → 预防,随着新数据源的出现循环往复。预防是杠杆最高的一步——没有预防,半年后你又要清理同样的字段。
探索归档与清除
本单元学习归档(Archive)、清除(Purge)与备份(Backup)三种策略——管理数据量的同时保留关键上下文。
了解归档与清除为何重要
数据不断累积,存储成本增长,性能下降,合规要求增多。归档和清除就是你管理数据量的方式,同时保留重要的东西。
NTO 的客服负责人想要更快更可靠的支持(尤其是保修期),营销负责人想要准确的终身价值(LTV)视图。Luna 看到共同的隐患——团队「以防万一」保留太多数据,增加成本和复杂度,却仍没能为客服和分析保留正确的客户上下文。
Luna 从把清理决策对齐到 NTO 的数据保留策略和业务需求开始。
定义归档、清除与备份 (1)
归档(Archive):把不活跃的数据移到长期、低成本存储。
- 数据被保留且仍可访问。
- 释放生产存储。
- 为分析保留历史上下文。
- 例如:超过 3 年的工单移出生产但仍可查询。
定义归档、清除与备份 (2)
清除(Purge):永久删除数据。
- 数据永远消失——无法恢复。
- 合规要求:GDPR 被遗忘权、数据保留期限。
- 永久释放存储。
- 例如:客户 PII 超过法定保留期后清除。
备份(Backup):为灾难恢复创建副本。数据被复制而非移动或删除,可在意外丢失后恢复,是与归档/清除分离的独立关注点。
归档 = 保留但搬迁;清除 = 永久销毁;备份 = 安全副本。三种不同策略、三种不同目的。记住:不确定时,按保留策略归档而非删除。
检测与决策:识别归档与清除候选 (1)
识别归档候选的三种标准:
- 基于年龄(Age-based)——超过 N 年的记录(如 3 年),按创建日期或最后修改日期。
- 基于状态(Status-based)——Closed、Inactive、Expired、Archived 状态,已完成的事务不再处于工作流中。
- 基于使用(Usage-based)——X 个月内未被访问或修改,近期活动为零或极低。
结合多种标准能取得最佳效果。
检测与决策:识别归档与清除候选 (2)
识别清除候选的两种标准:
- 基于合规(Compliance-based)——法定保留期已过、被遗忘权请求、法规要求必须删除的数据。
- 基于价值(Value-based)——没有业务或分析价值、不贡献客户上下文、保留成本超过价值。
决策框架:法律要求保留 → 归档;历史有业务价值 → 归档;无价值 + 合规风险 → 清除;被遗忘权 → 清除(强制)。系统化地应用,并记录决策。
保留客户上下文而不杂乱
清理不是删除所有旧数据,而是策展(curation):移除让系统拥堵的东西(过时、冗余、合规到期的数据),保留提供客户洞察的东西(历史模式、偏好、行为)。
Luna 提出「最小可行历史上下文」方法:对订单,保留支持 LTV 的关键详情(订单日期、客户 ID、金额、退换);完整订单历史只保留到支持业务所需的期限(如营销用 3 年);对工单,保留合规所需内容,其余归档。
归档旧工单,但保留它们与客户统一档案的链接;清除保留期后的 PII,但保留匿名化的交易模式用于分析。保留重要的,移除不重要的。
清理未使用的字段与配置
最后一个单元:数据不是唯一需要清理的东西——未使用的字段和被遗弃的配置会造成元数据膨胀。
发现元数据清理的价值
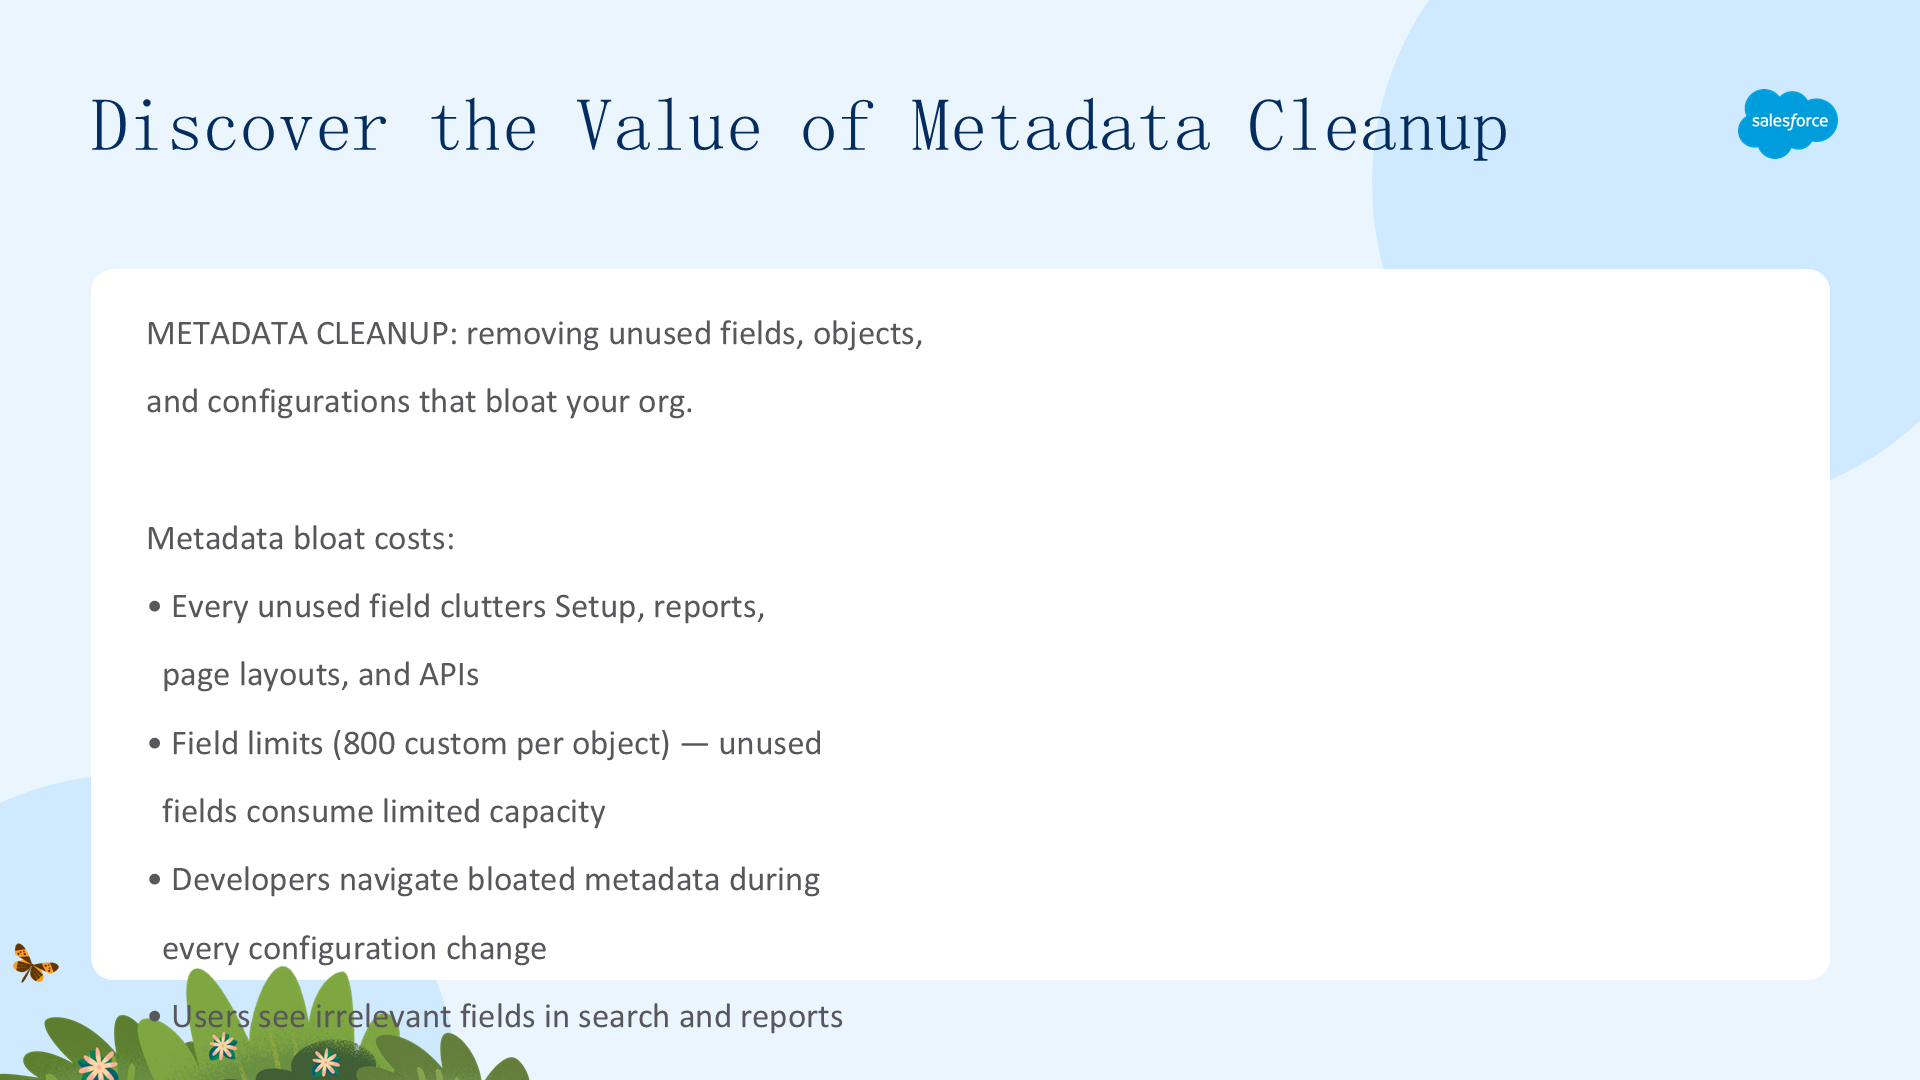
元数据清理(Metadata Cleanup):移除让 org 膨胀的未使用字段、对象和配置。它与数据清理的区别在于——数据清理改进记录里的值,元数据清理改进数据模型和配置。
元数据膨胀的代价:每个未使用的字段让 Setup、报表、页面布局和 API 更杂乱;字段限额(每个对象 800 个自定义字段)被浪费;开发者每次改配置都要在膨胀的元数据里导航;用户在搜索和报表里看到无关字段。
元数据清理 = 组织的春季大扫除,移除不再需要的东西,为重要的东西腾出容量。
了解区别:未使用 vs 已弃用
用清晰一致的术语,让所有人都同意该清理什么:
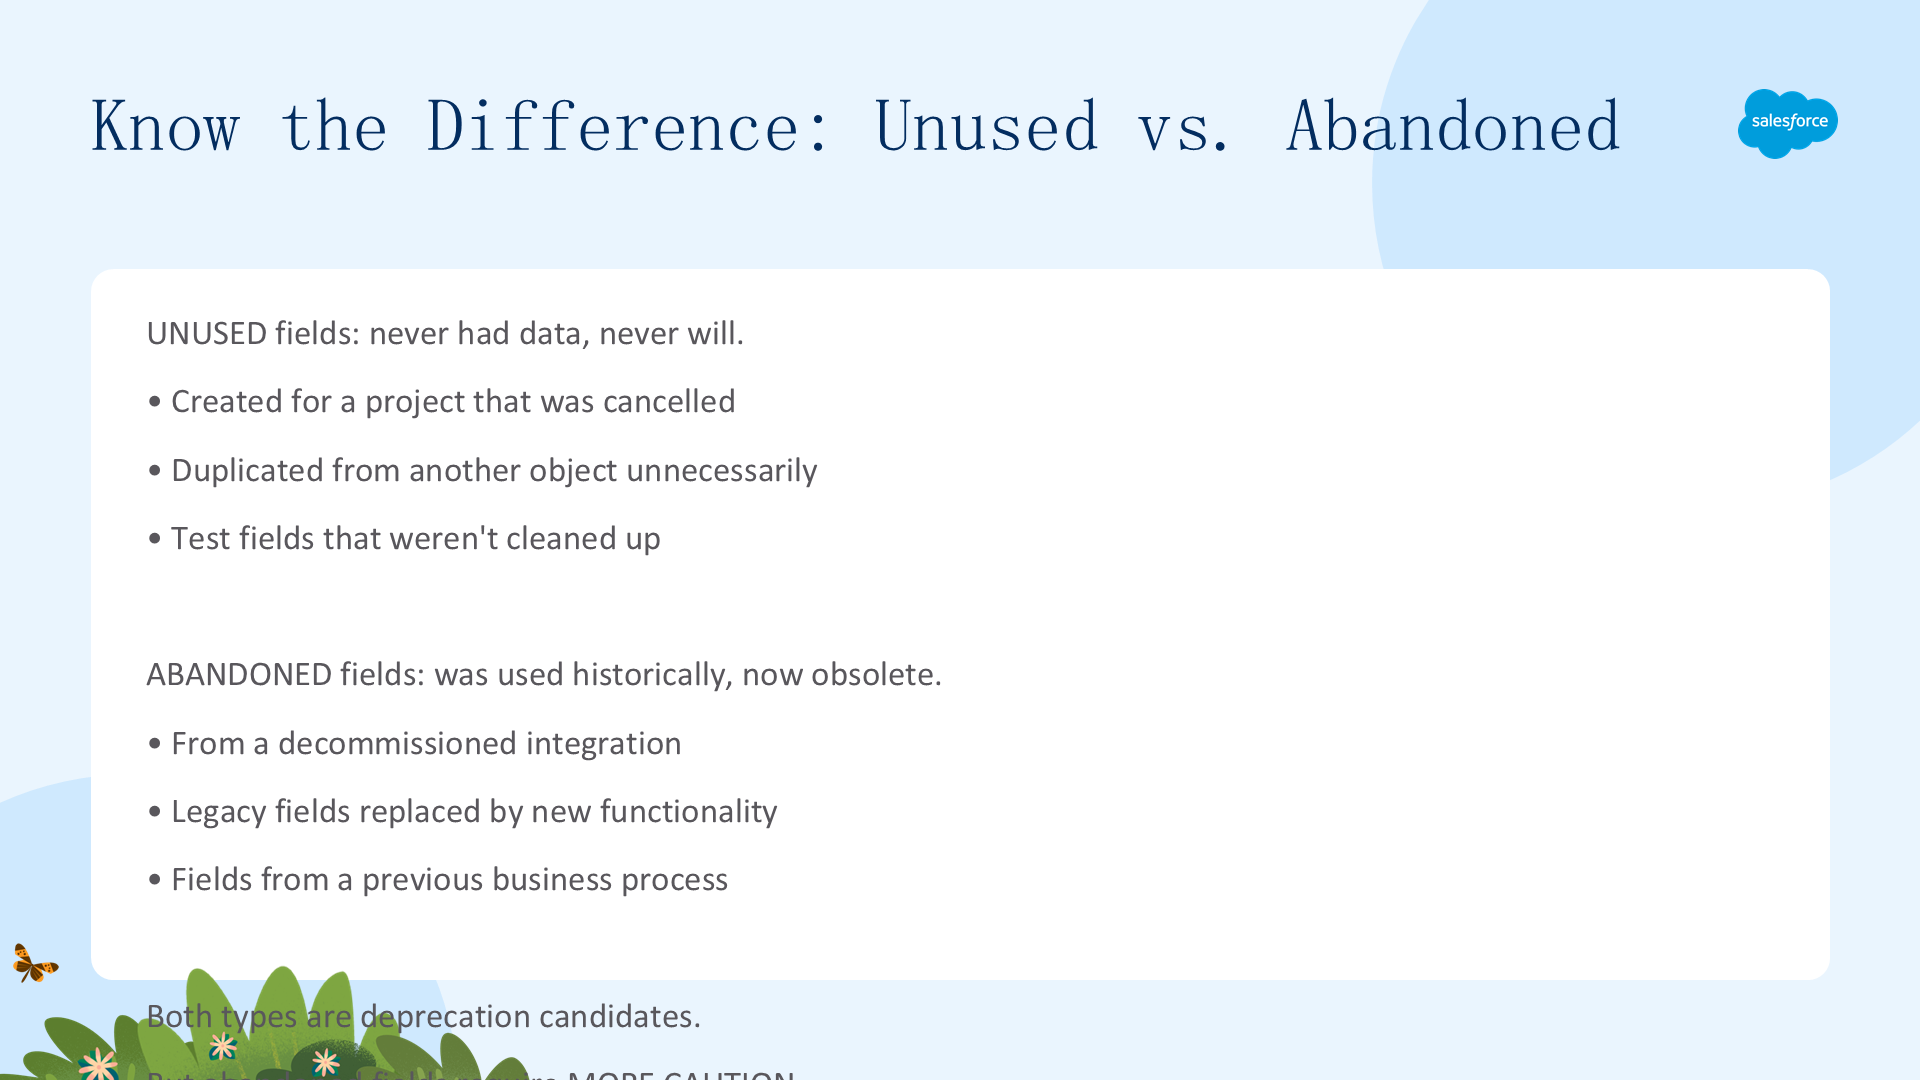
- 未使用(Unused)——从未被使用或填充的字段/选项列表值。例如为已取消项目创建的字段、无谓重复的字段、没清理的测试字段。
- 已弃用(Abandoned)——历史上用过、但在过去 12-36 个月内未再使用的字段/配置。例如来自已停用集成的字段、被新功能取代的旧字段。
两类都是弃用候选,但已弃用字段需要更谨慎——它们可能带着需要先归档的历史数据。
为什么这很重要
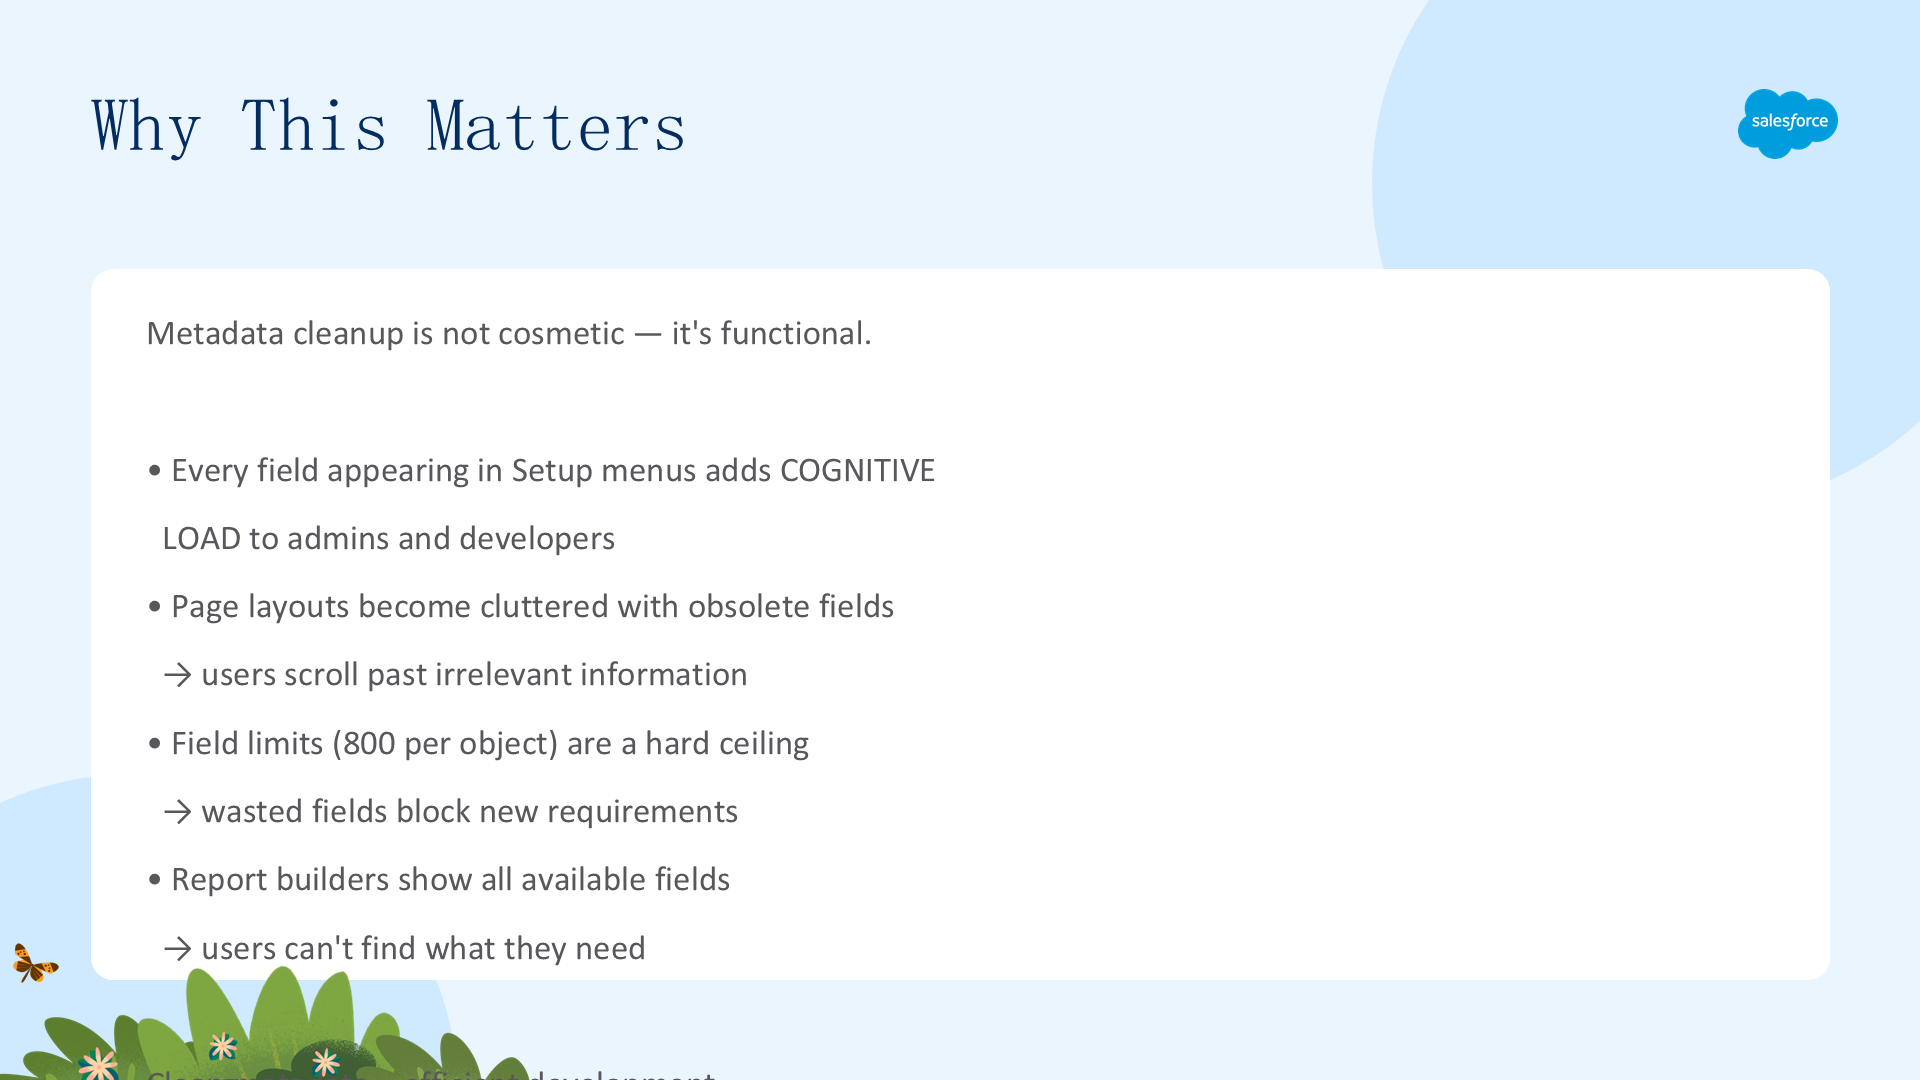
元数据清理不是表面功夫,而是功能性的:
- Setup 菜单里每个字段都增加管理员和开发者的认知负担。
- 页面布局被过时字段填满,用户要滚过无关信息。
- 字段限额(每对象 800 个)是硬上限,浪费的字段挡住新需求。
- 报表构建器展示所有可用字段,用户找不到需要的。
干净的元数据 = 高效的开发;膨胀的元数据 = 缓慢、混乱、受限。
快速信号,巨大节省
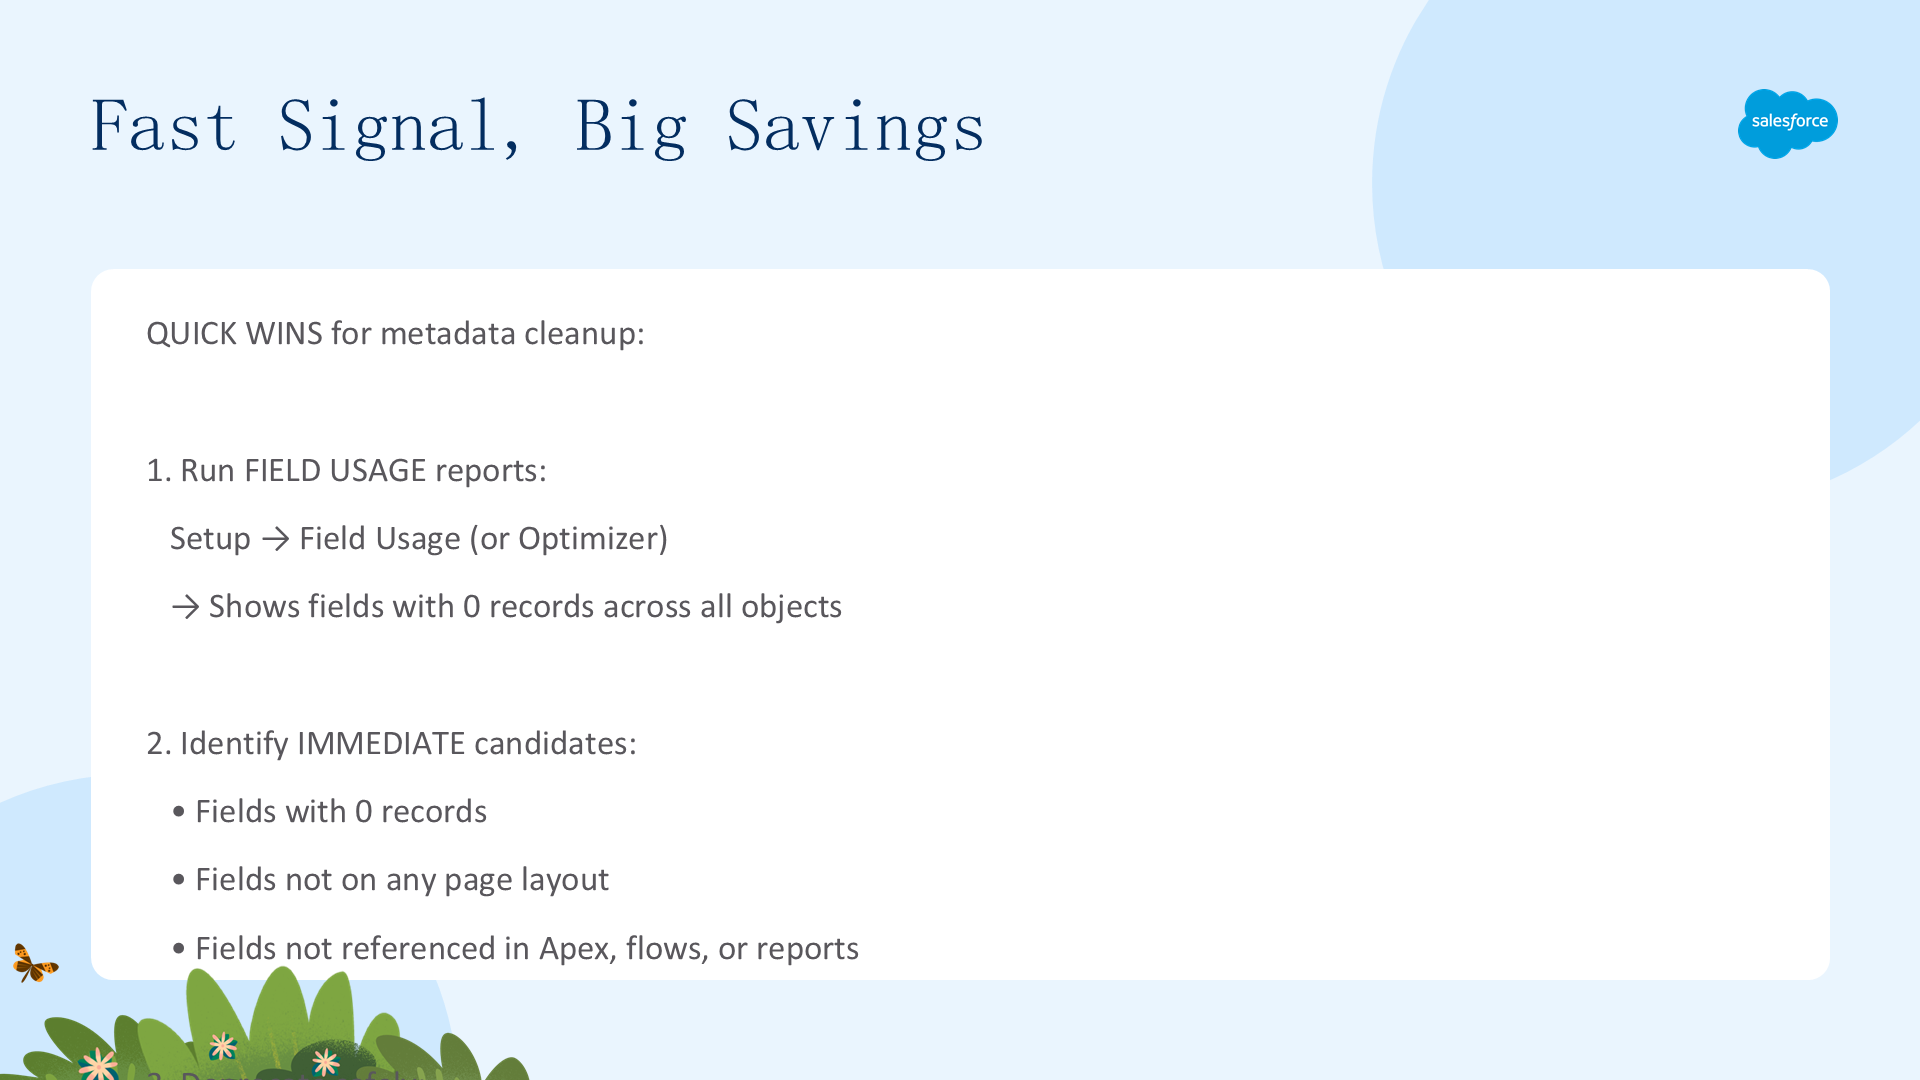
NTO 正在扩张,刚收购了另一家公司。作为遗留系统迁移的一部分,Luna 在 Data 360 里把遗留对象作为安全暂存环境进行画像。
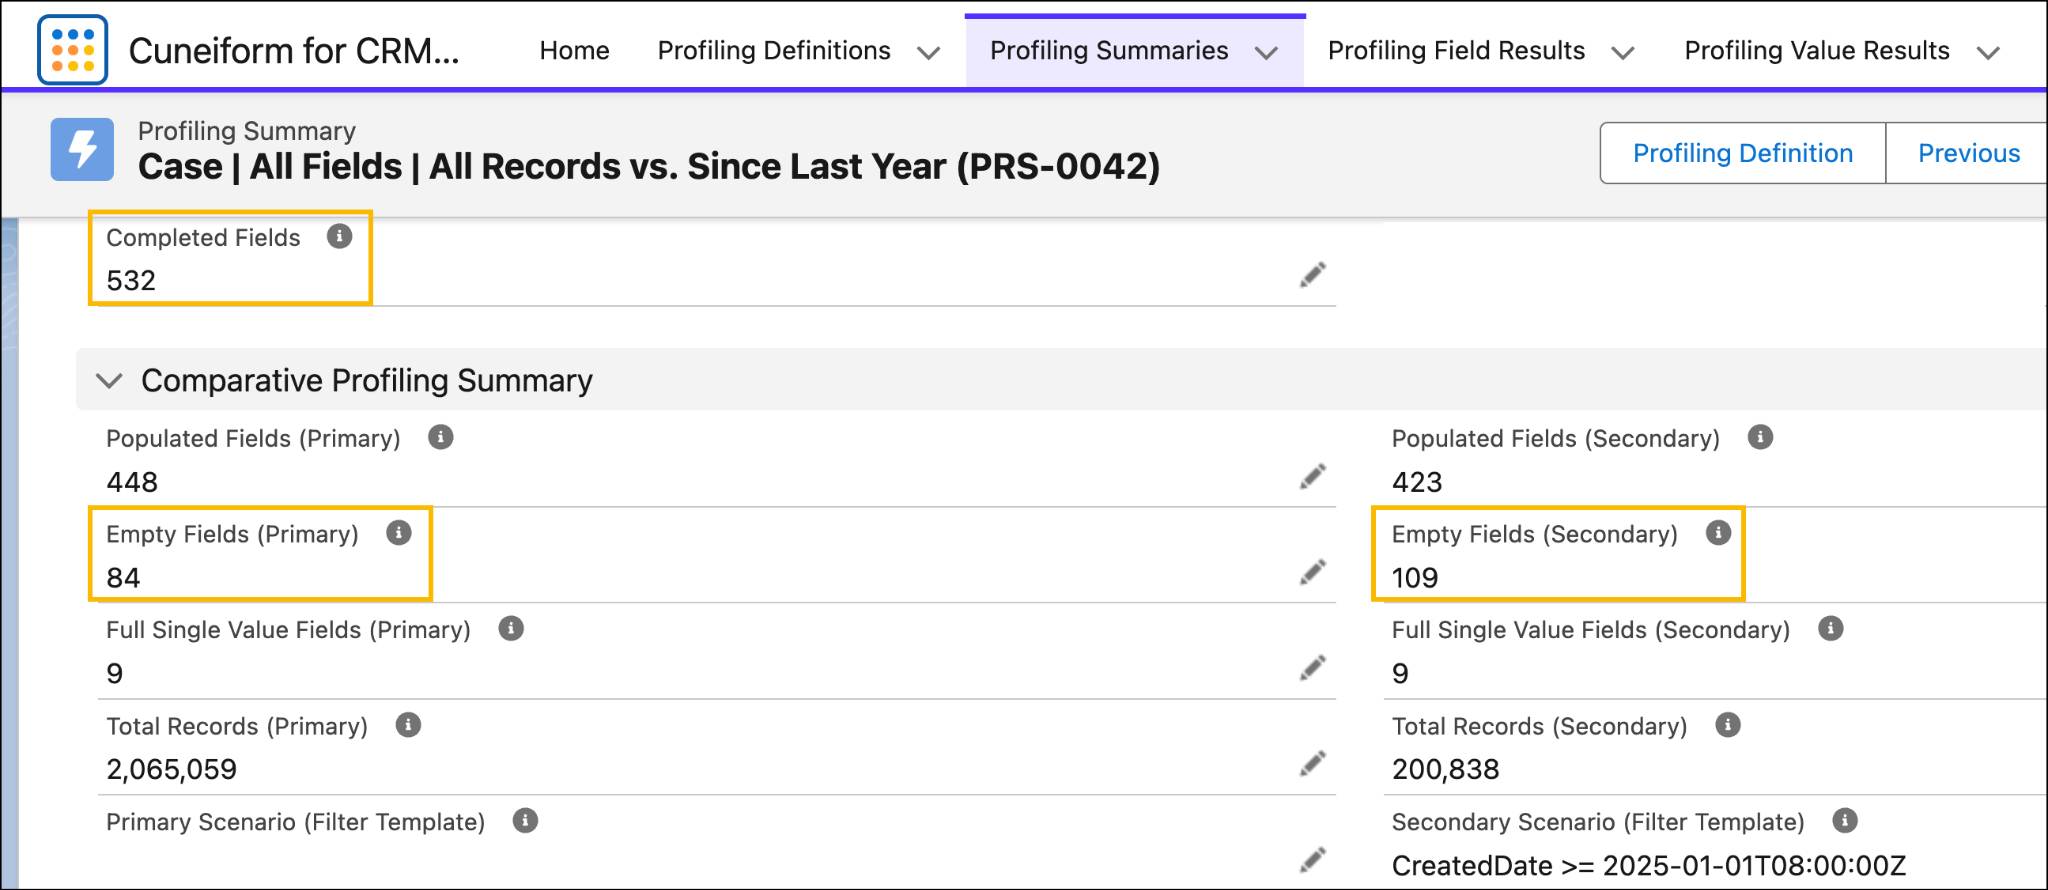
画像工单记录后,Luna 发现很多字段未被使用:对象全部历史里有 84 个字段从未用过,自 2025 年 1 月 1 日起又有 25 个字段一直未用。这意味着对象 532 个字段里约有 104 个(约 20%)可能不需要。
零记录 + 零引用 = 可以安全删除。这是最快、最低风险的清理切入点——从这里开始,建立势头。
检测与决策:从数据画像到行动 (1)
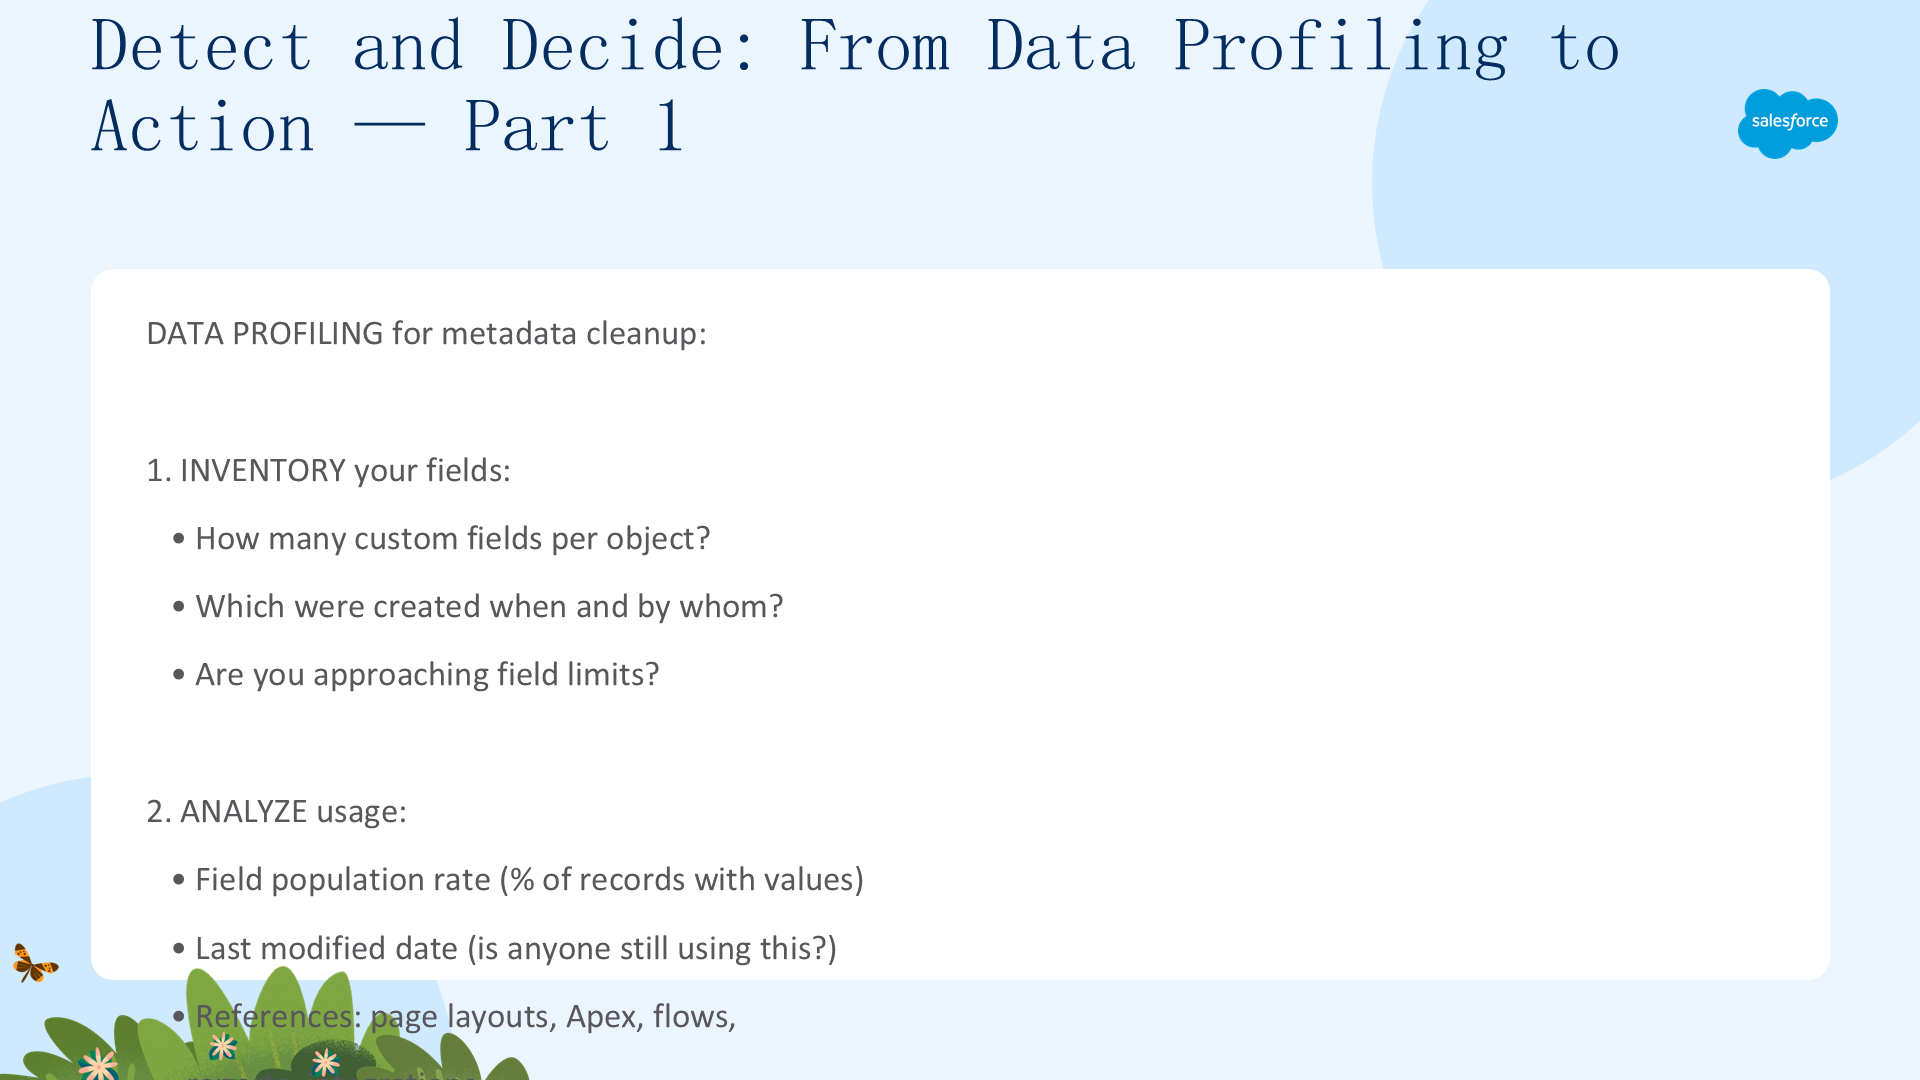
元数据清理的数据画像第一步是盘点字段:每个对象有多少自定义字段?分别何时、由谁创建?是否接近字段限额?
第二步是分析使用情况:
- 字段填充率(有值的记录占比)——0% 填充说明字段毫无用处。
- 最后修改日期(还有人用吗?)。
- 引用:页面布局、Apex、Flow、报表、集成。
检测与决策:从数据画像到行动 (2)
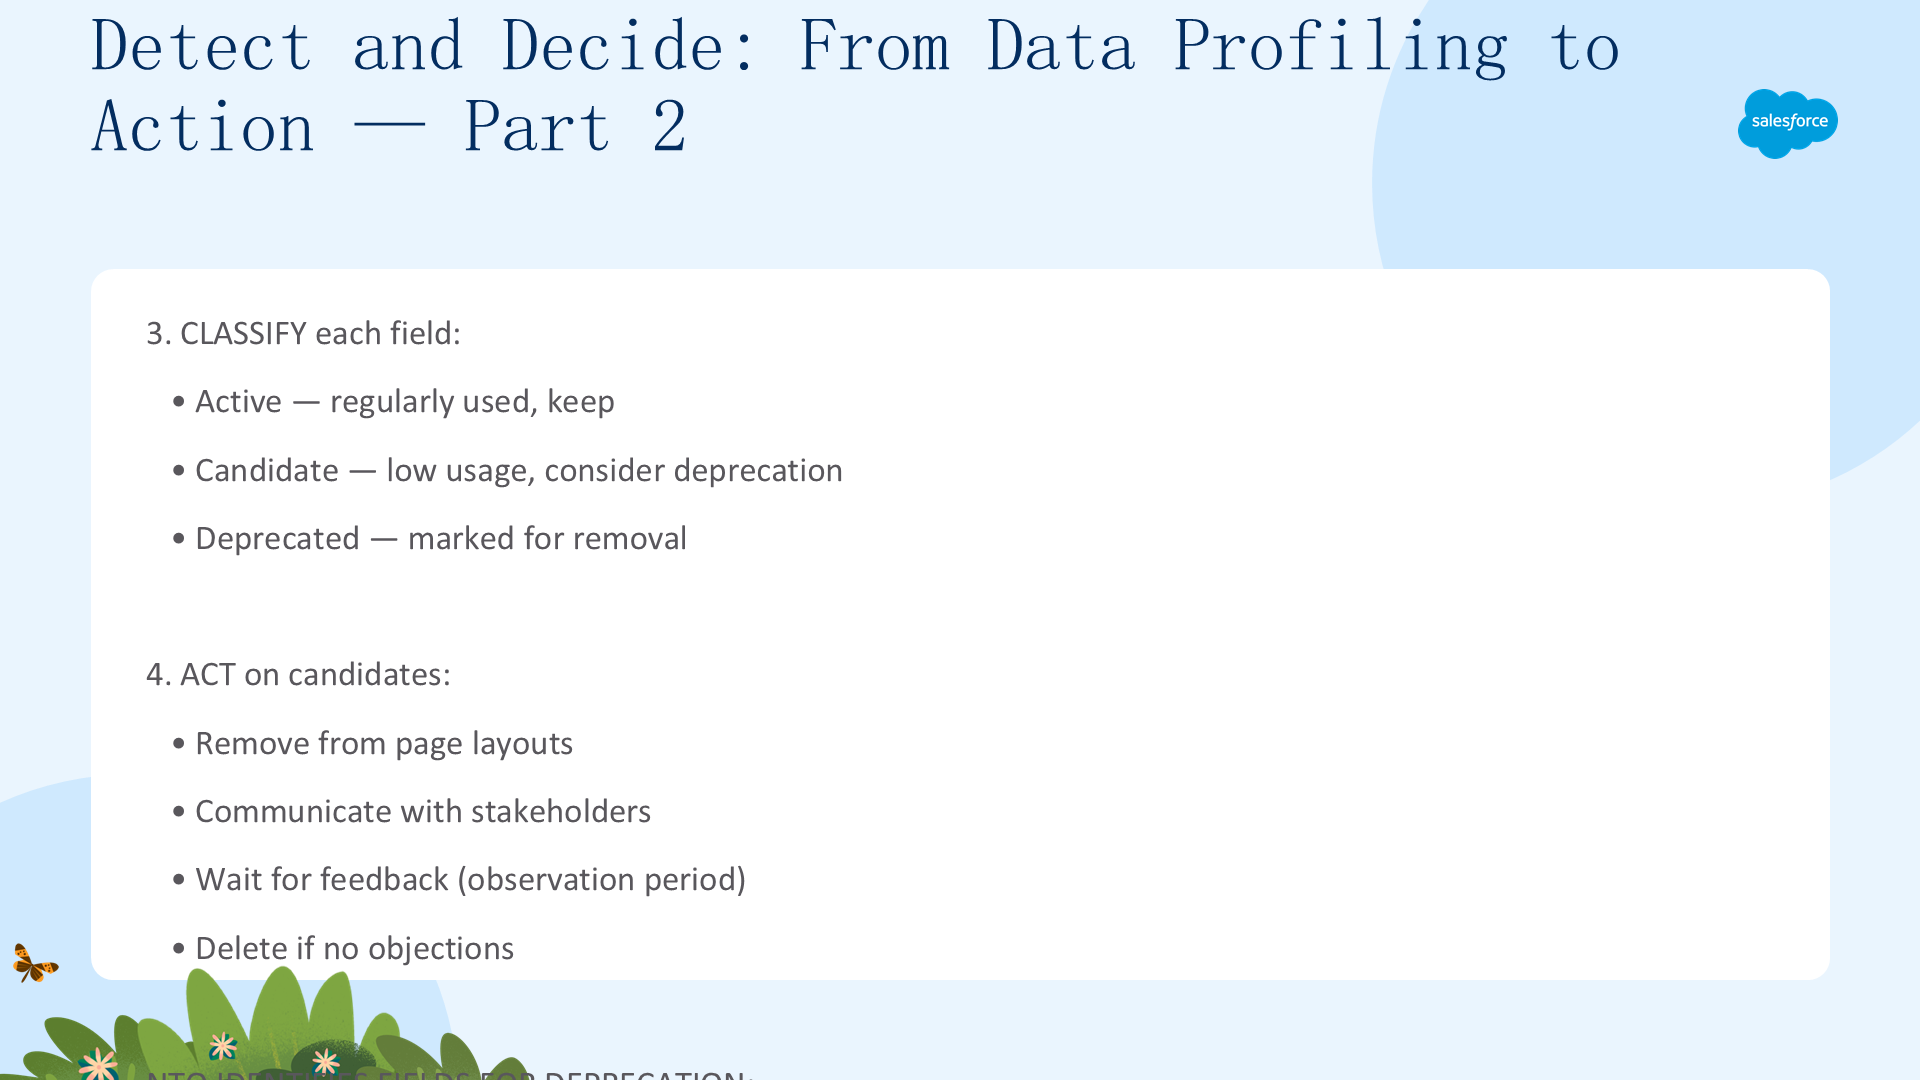
第三步分类每个字段:Active(常用,保留)、Candidate(低使用,考虑弃用)、Deprecated(标记移除)。
第四步对候选字段采取行动:从页面布局移除、与干系人沟通、等待反馈(观察期)、无异议后删除。
Luna 把未使用和不再使用的字段按风险和移除速度分组:无依赖的空字段、需解决依赖的空字段、无依赖的已弃用字段、有依赖的已弃用字段。
NTO 识别待弃用字段
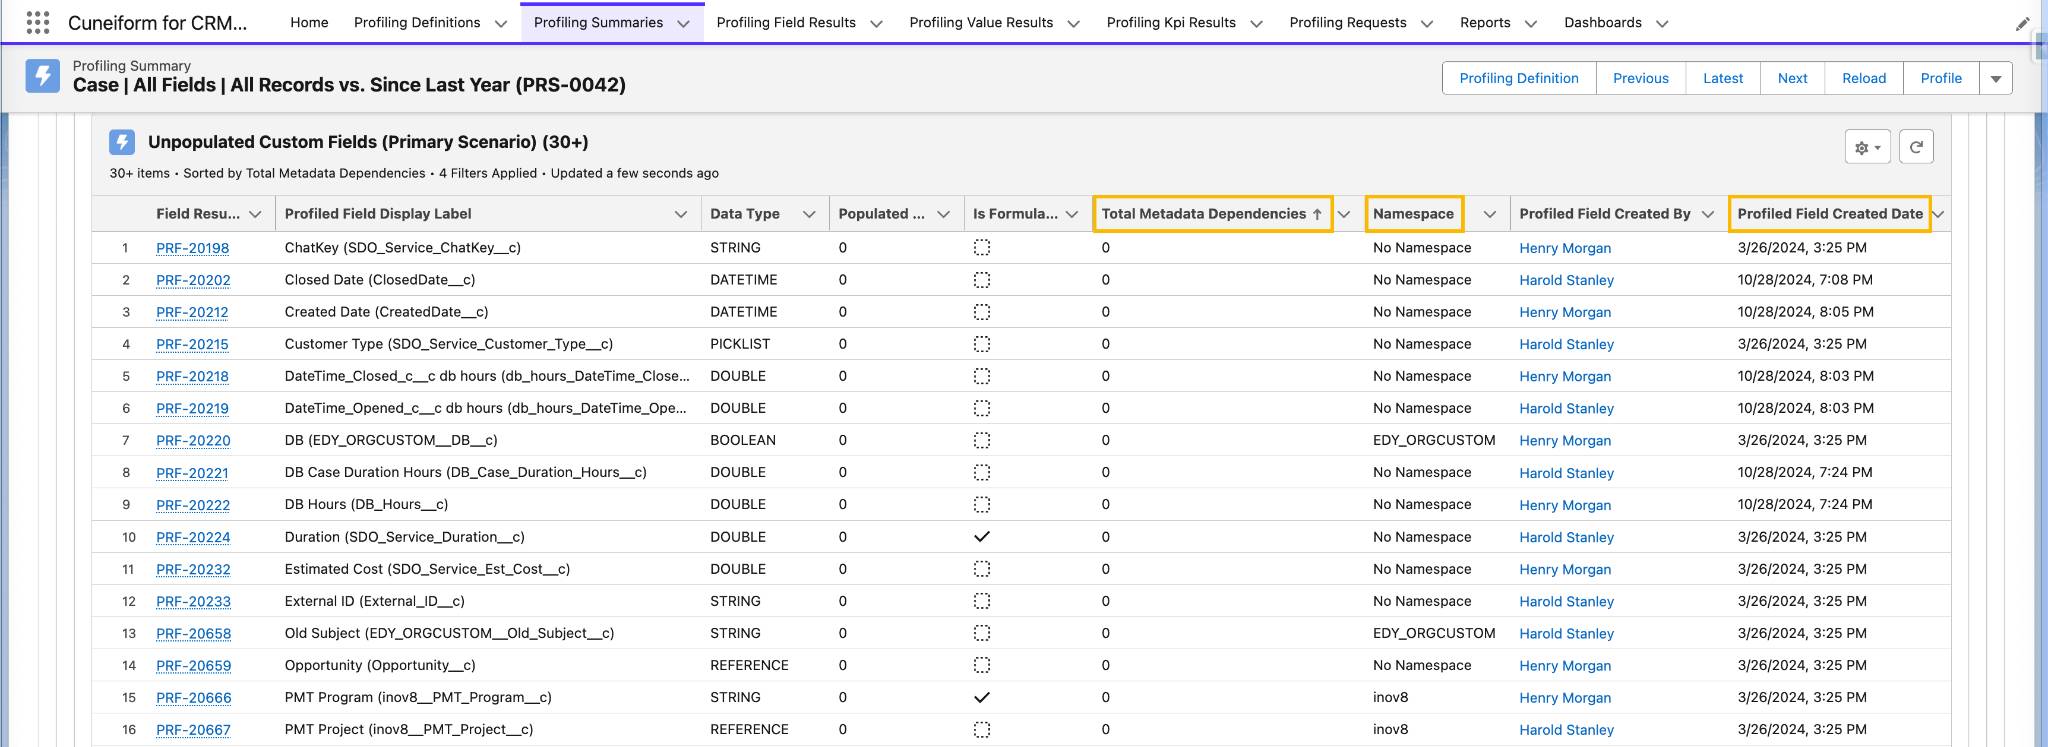
画像后 Luna 审查未填充的自定义字段,目标是识别可弃用的未使用字段。她审查:字段何时创建(避免误弃新字段)、从未使用的字段(最低风险)、由管理员还是托管包创建(涉及不同字段限额)、元数据依赖数量(有依赖就不能直接删除)。
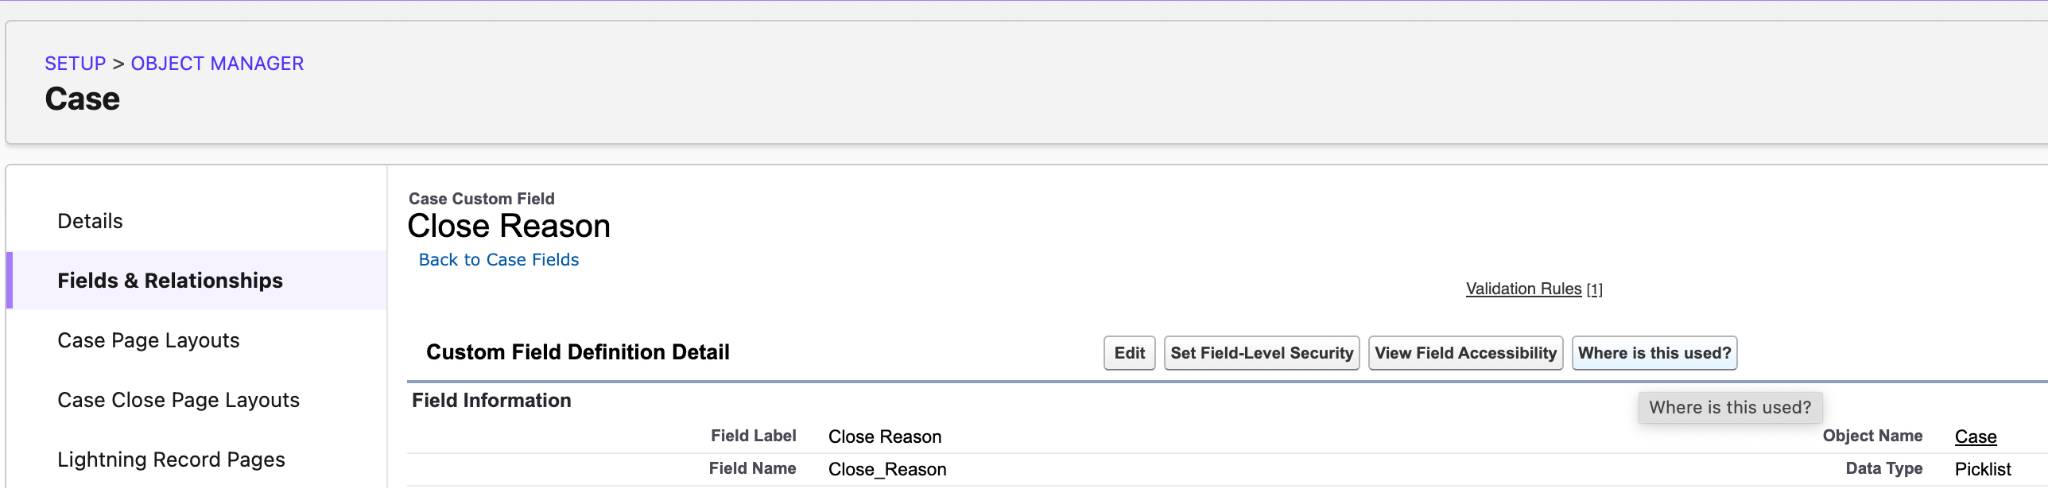
她还用 Object Manager 里的 Where is this used? 按钮查看所有引用和依赖,再决定是否删除:
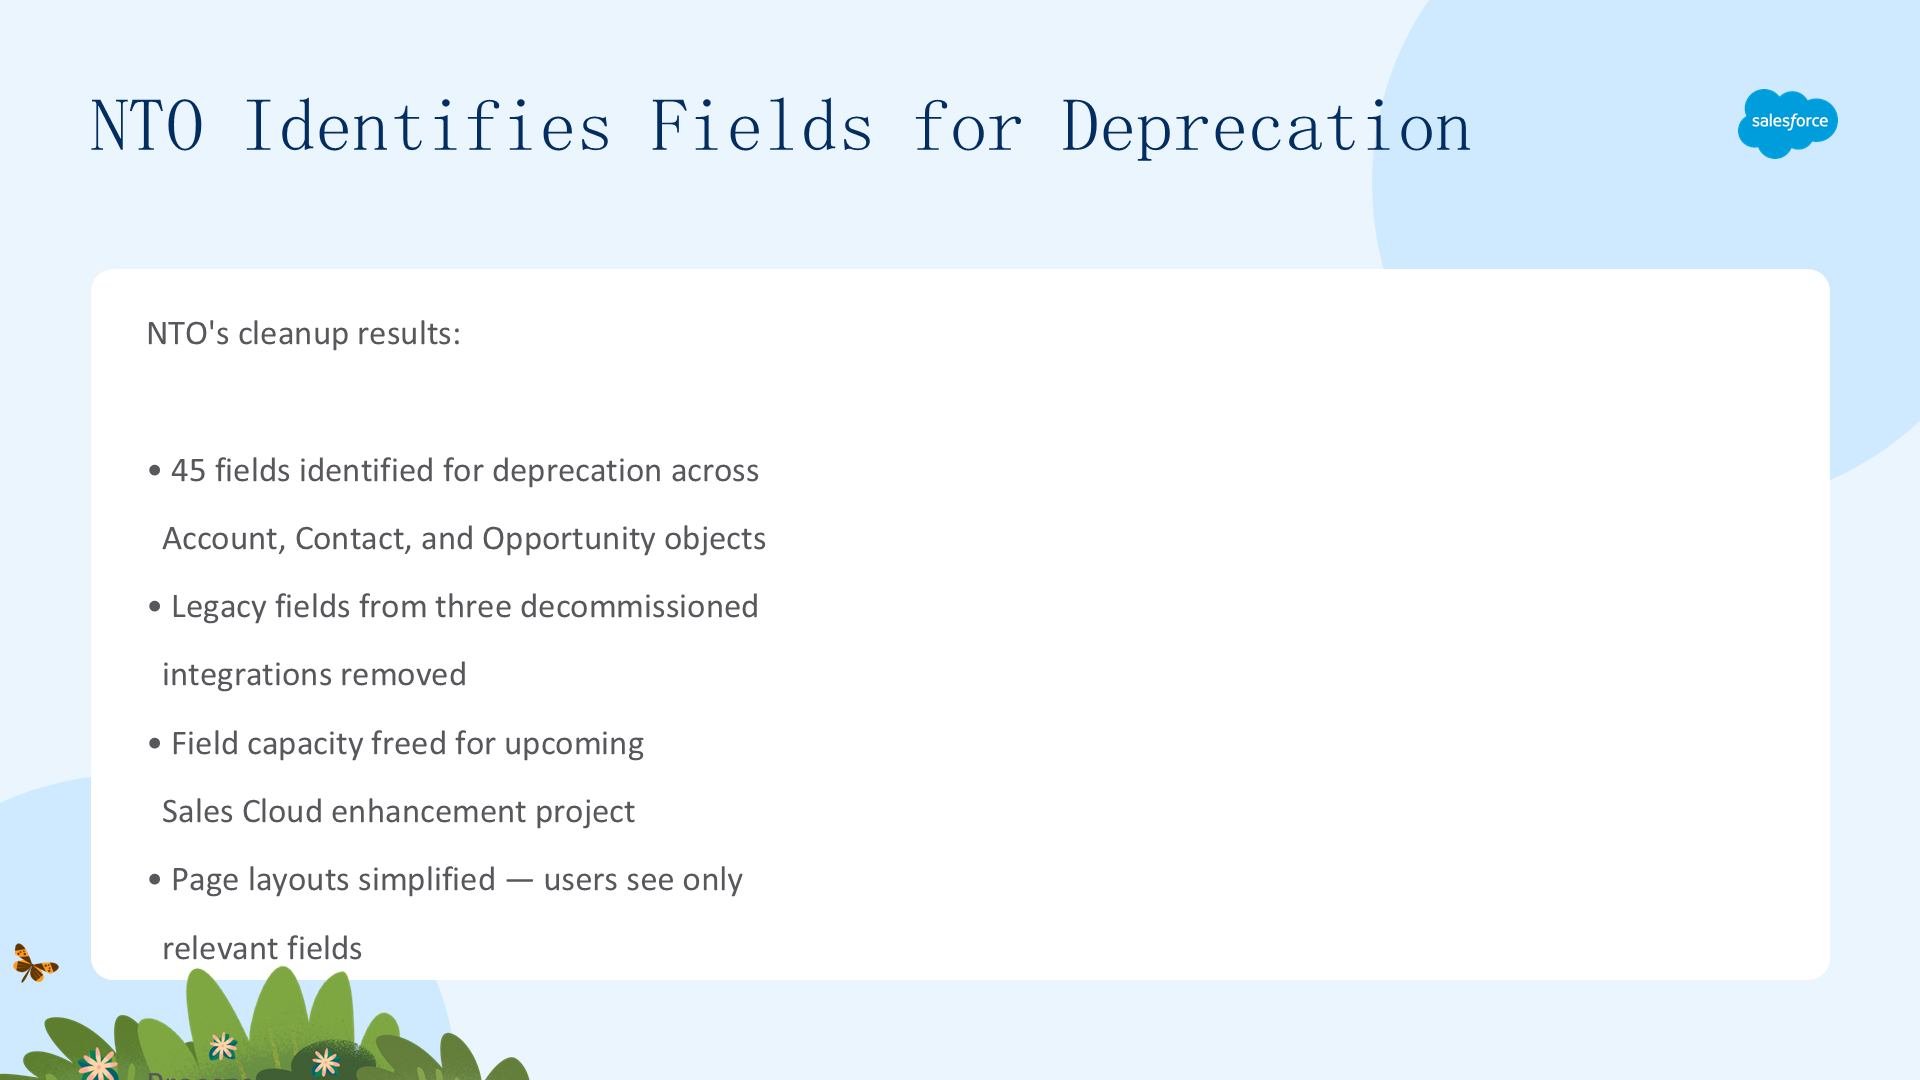
最终 NTO 识别出 45 个字段待弃用(Account、Contact、Opportunity),移除三个已停用集成的遗留字段,为即将到来的 Sales Cloud 增强项目腾出容量,简化了页面布局。
在正确权限下评估
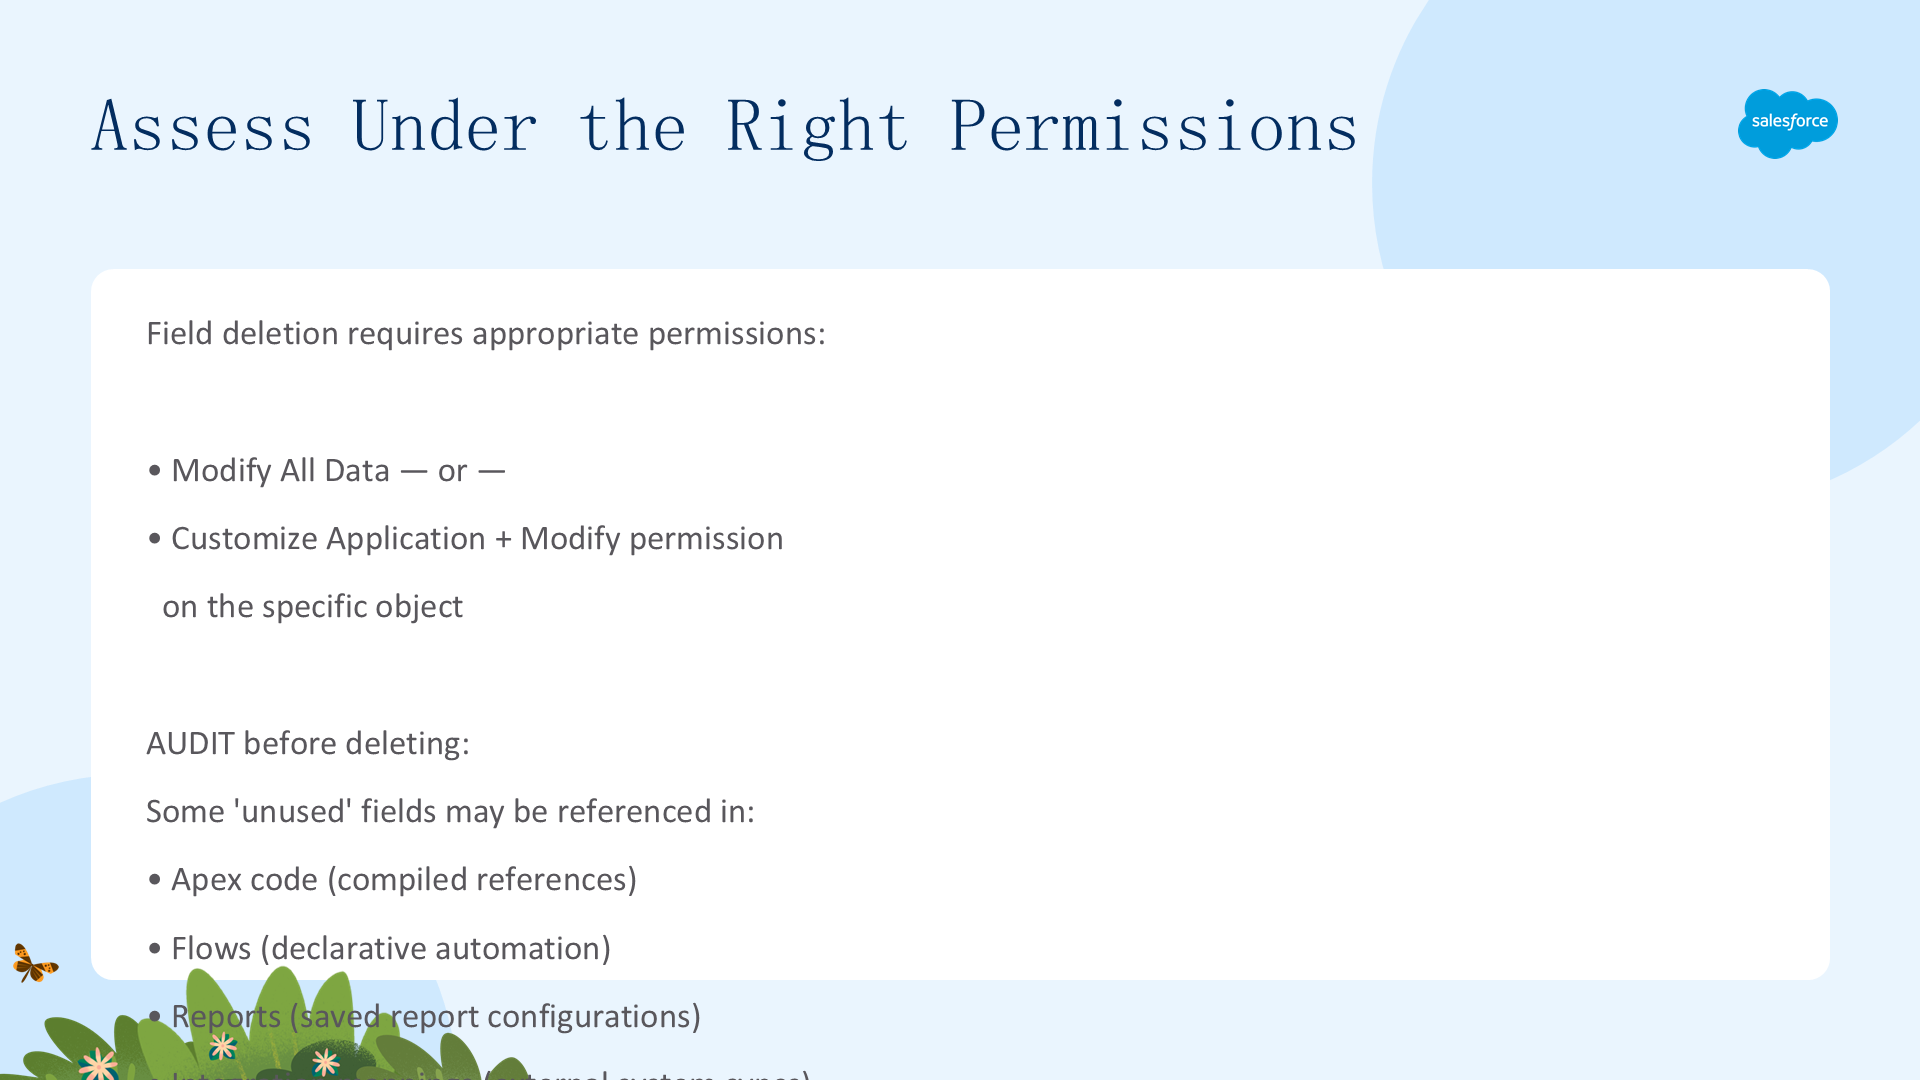
字段删除需要适当权限:Modify All Data,或对该对象拥有 Customize Application + Modify 权限。
删除前要审计——有些「未使用」字段可能被引用在:Apex 代码(编译期引用)、Flow(声明式自动化)、报表(保存的报表配置)、集成映射(外部系统同步)。
用 Salesforce Optimizer 或第三方工具扫描引用,再删除。宁可多留一分小心——一个被删除的字段及其数据就永远没了。最佳实践:弃用 → 从用户权限移除 → 等一段时间收集反馈 → 再删除。
总结
本模块覆盖了数据清理的完整图景:
- 数据清洗——检测并纠正问题。
- 重复管理——一个客户一条记录。
- 钥匙环 vs 黄金记录——保留上下文。
- 错误匹配预防——多因素身份解析。
- 字段不一致——标准化与预防。
- 归档 vs 清除——保留重要的、移除风险的。
- 元数据清理——弃用未使用的配置。
干净数据 = 可信数据;可信数据 = 可靠的 AI、准确的分析、自信的决策。数据清理不是有结束日期的项目,而是持续实践——画像、清洗、监控、循环往复。