优化 RAG 的混合搜索结果(Optimize Hybrid Search Results for RAG)
RAG 与混合搜索简介(Introduction to RAG and Hybrid Search)
在 Search Index Types in Data 360 中你已经了解到,可以在 Data 360 中构建搜索索引,将 AI 建立在你组织的非结构化、半结构化或结构化数据之上。本模块将教你如何针对 RAG 优化搜索结果。首先,让我们定义几个关键术语。
在 Data 360 中,检索增强生成(Retrieval Augmented Generation,RAG)是一个框架,用于将大语言模型(LLM)的提示词 grounding 到准确、最新且相关的信息上,从而提升 LLM 响应的相关性与价值。
混合搜索(Hybrid Search)是基础性的搜索服务,它结合了语义感知的向量搜索(理解含义与上下文)与关键词搜索的精确性(处理领域专业词汇、缩写与精确术语)两大优势。当你构建混合搜索索引时,需要在 AI Models(原 Einstein Studio)中为该索引创建一个独立的检索器(retriever),然后在为 LLM 编写提示词时,在提示词模板(prompt template)中使用它。
借助混合搜索索引,你可以增强搜索查询,并在 RAG 场景下用最相关的信息为 LLM 提示词提供 grounding。
真实场景:Storm Eowyn 风暴。Storm Eowyn 是一场于 2025 年 1 月袭击爱尔兰的强气旋,也是该国自 2017 年以来遭遇的最严重风暴。风暴来临前,许多居民致电保险公司,想了解自己的承保范围以及如何增强保障。
假设你是其中一家保险公司的管理员,希望客服人员能够借助 Agentforce 轻松找到这些信息。对向量搜索而言,这是一个直接的场景:向量搜索能够识别出描述自然灾害承保(例如风暴、气旋)的相关文章片段。
但在 Storm Eowyn 风暴过后,爱尔兰政府通过一项人道主义援助计划(Humanitarian Assistance Scheme,HAS)为符合条件的居民提供额外支持。混合搜索正是此场景的理想选择:它将自然灾害承保上的语义搜索与针对 Storm Eowyn 风暴及 HAS 等缩写的特定关键词相结合。此外,混合搜索还能借助排名因子(ranking factors)呈现 HAS 计划的持续更新。
混合搜索为你提供了三种优化策略,确保获得最准确、最新的结果:
- 配置预过滤字段(pre-filter fields)——在创建索引时配置,并使用预过滤条件筛选相关结果。
- 添加排名因子(ranking factors)——在创建索引时添加诸如最新(recency)与热度(popularity)等因子,以获取最新、最有用的结果。
- 使用排名模型(ranking models)——发送相关性特定参数,通过搜索查询影响结果排序。
预过滤字段与排名因子(Pre-Filter Fields & Ranking Factors)
在创建搜索索引时,你可以从搜索索引对象或相关对象中添加字段,从而为搜索提供更多过滤方式。你最多可以选择 10 个过滤字段,并使用这些预过滤字段来筛选结果。
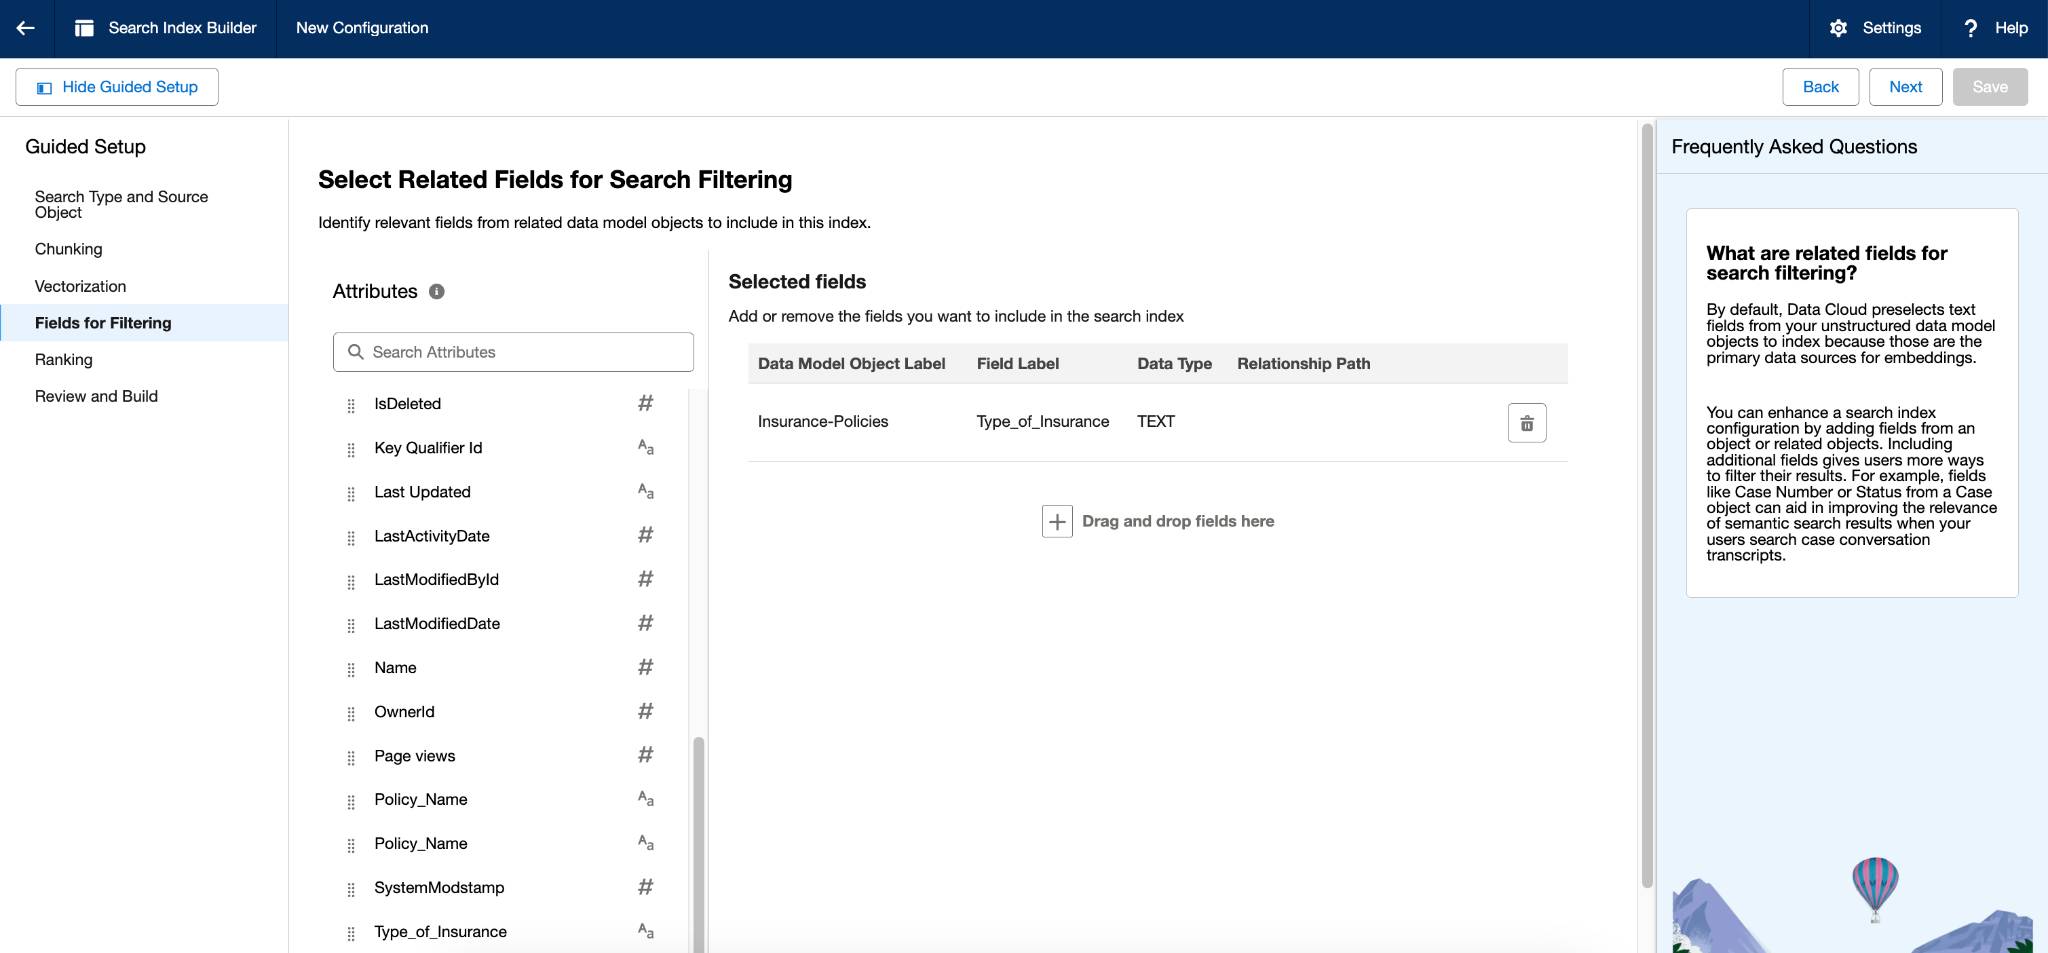
以家庭保险政策为例,你可以把保险政策类型作为过滤字段添加进去。之后,你便可以创建一个查询,专门选择家庭保险政策文章,从而确保返回的都是相关文章。
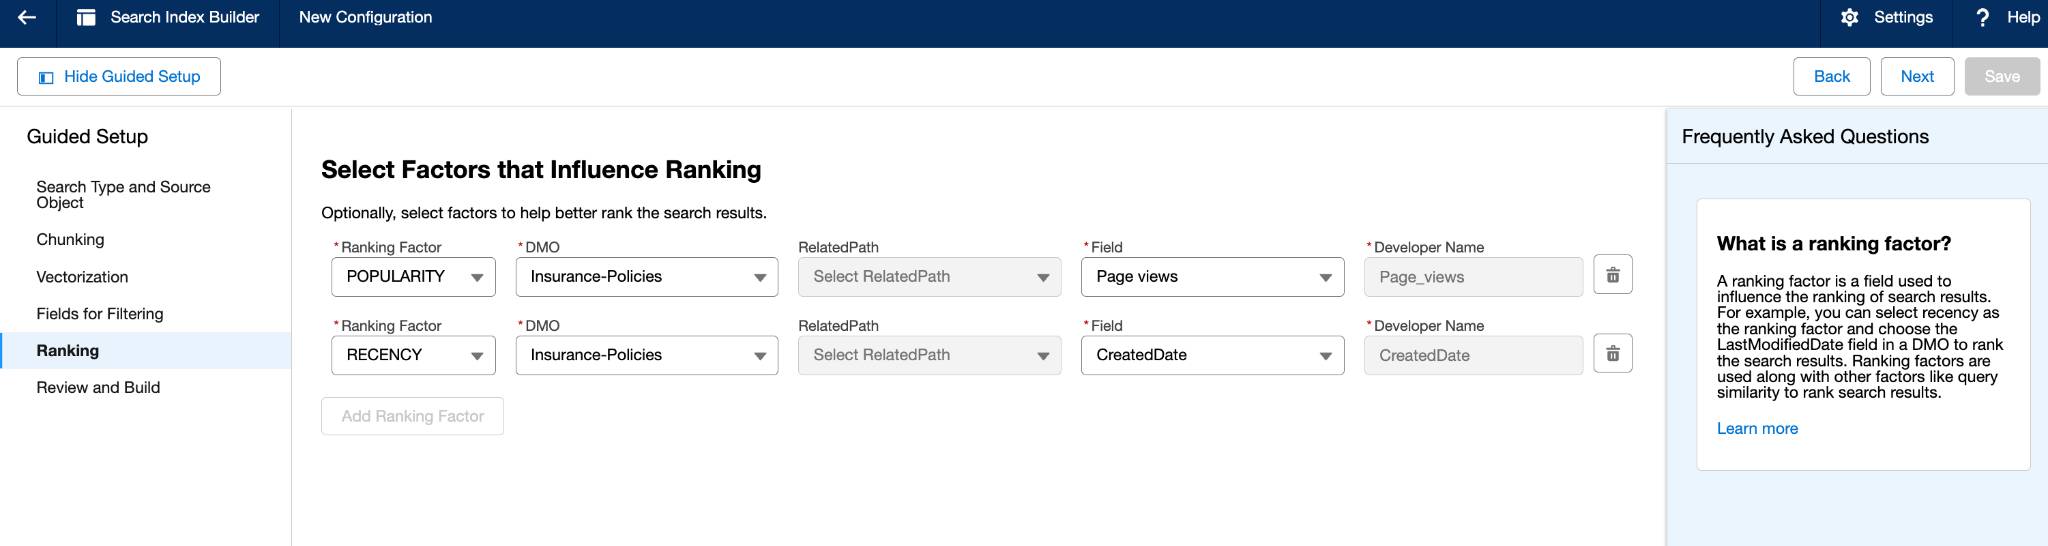
配置排名因子:在创建索引时,你可以配置最新(recency)与热度(popularity)等排名因子。内置的混合搜索融合排名模型(hybrid search fusion ranking model)会纳入这些排名因子,从而得到对客户最相关的结果。
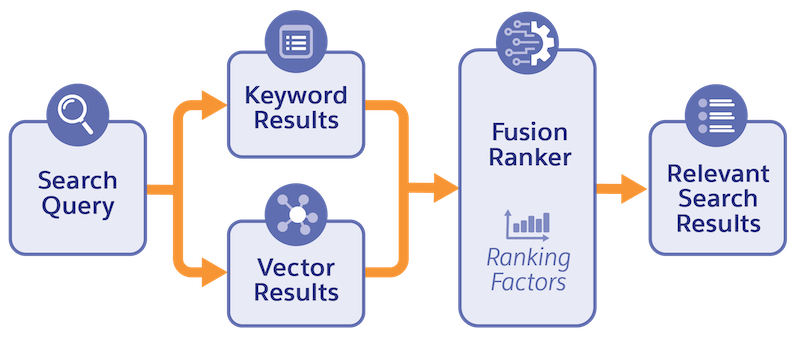
在本场景中,你最关心的是最新、最受欢迎的文章:对于最新(recency),选择 Last Updated 字段;对于热度(popularity),选择 Page Views 字段。默认的融合排名器模型在为最相关结果生成相似度分数时,会考虑这些排名因子。
注意:如果没有能充分代表最新或热度的字段,那么就不要在创建索引时配置它们——不恰当的字段反而会降低结果的相关性。
在下一节,我们将看看如何针对本场景使用并微调这些排名因子。
排名模型:LFR、DFR、RRF(Ranking Models)
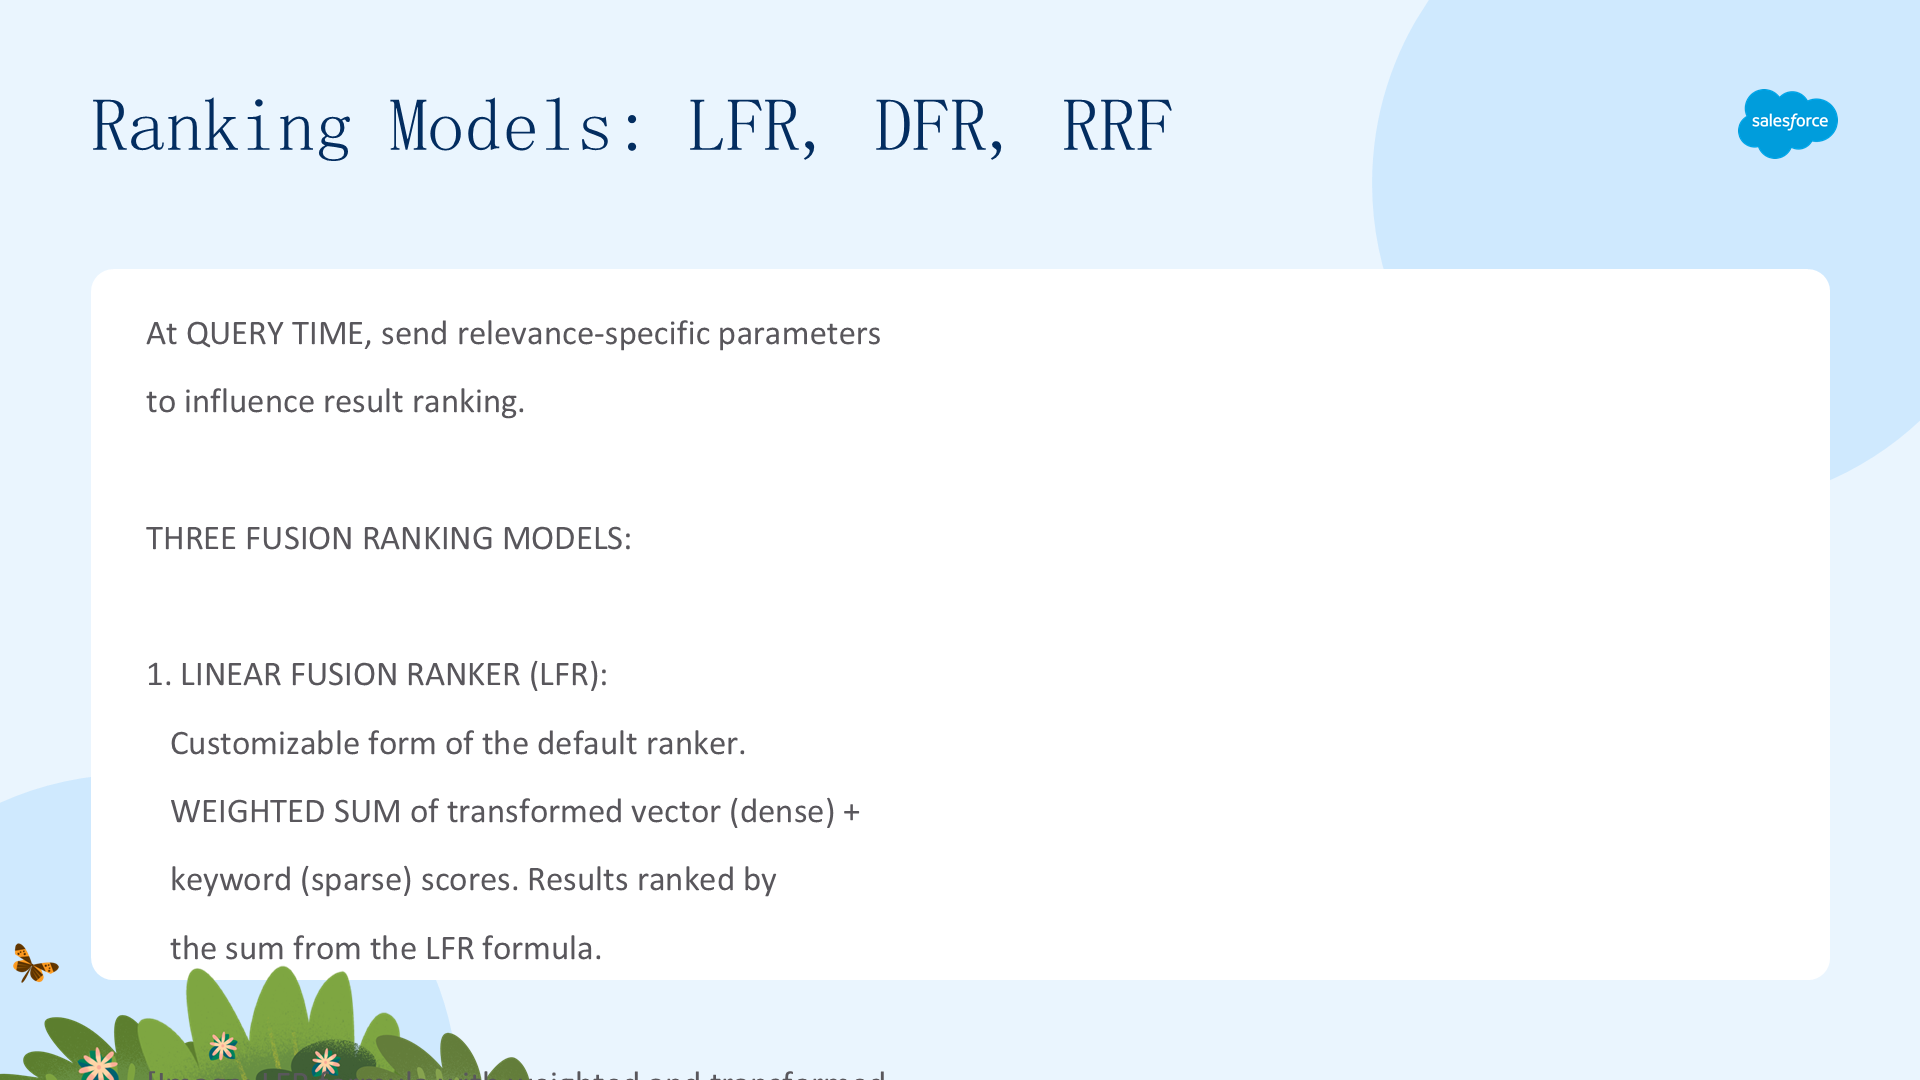
在查询时,你可以通过排名模型向搜索索引发送相关性特定参数,从而提升搜索结果的准确性。你可以调整赋予某种搜索类型以及排名因子的重要程度。
Data 360 混合搜索支持三种融合排名模型:
- 线性融合排名器(Linear Fusion Ranker,LFR)
- 深度融合排名器(Deep Fusion Ranker,DFR)
- 倒数排名融合(Reciprocal Rank Fusion,RRF)——行业标准
LFR 模型是默认融合排名器的可定制形式,它计算向量搜索(dense)与关键词搜索(sparse)转换分数的加权和,搜索结果按 LFR 公式求和后进行排名。
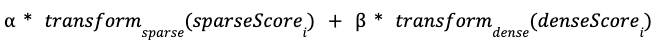
DFR 模型通过将向量相似度、关键词匹配、热度、最新等传统信号与对查询文本的深入理解相结合来增强搜索相关性。它借助深度学习技术与 Transformer 架构捕获复杂的特征交互,并对记录进行联合打分。
RRF 模型是行业标准,其公式是关键词搜索(sparse)与向量搜索(dense)倒数排名分数之和,默认排名常数 k=60。该公式还提供 alpha 参数,用于控制两者分数凸组合中 sparse 的权重,同时也可以纳入你在创建索引时配置的排名因子。搜索结果按 RRF 排名融合公式求和后进行排名。
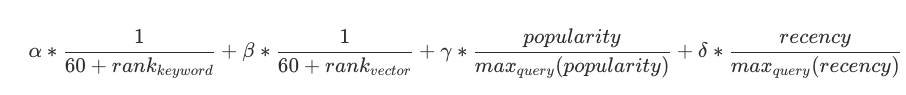
在高级 RRF 公式中:
- Alpha (α) 表示赋予关键词搜索的重要性,默认值为 0.5。
- Beta (β) 表示赋予向量搜索的重要性,根据关键词搜索的重要性计算(即 1 - alpha)。
- Gamma (γ) 表示排名因子热度(popularity)的重要性,默认值为 0.00074478,最大值为 1。
- Delta (δ) 表示排名因子最新(recency)的重要性,默认值为 0.00028472,最大值为 1。
在查询中指定各权重的重要性,并以较小的增量逐步微调数值,以确保结果达到正确的相关性。
回到本场景,我们使用 RRF 模型,为家庭保险领域的专业术语赋予更高的关键词搜索重要性。在下面的查询中,你想呈现的是关于「为风暴损坏的家庭保险政策添加 rider(附加险)或 add-on(附加项)」这一问题的结果。于是将关键词搜索重要性设置为较高的 0.8 权重,以呈现相关文章。
此外,你还更看重最新、热门的文章——这有助于确保 HAS 计划最新的政策补充在响应中比旧文章更重要。由于你在创建索引时已配置了最新(recency)因子,可以将其加入查询,确保最新文章在结果中排名更高;你也可以加入热度(popularity)权重,确保浏览量最多的文章靠前。通过微调组件权重,确保查询返回最相关的结果。
总结(In Summary)
Data 360 的混合搜索通过针对每个场景的可定制策略来优化搜索结果。例如,在创建搜索索引时配置预过滤字段和排名因子;在搜索查询中将预过滤字段、排名因子与排名模型搭配使用。你还可以为某个排名模型微调关键词搜索、向量搜索和排名因子的组件权重。
借助 Data 360 的混合搜索,为你的用户呈现他们真正需要的结果。