一、认识大语言模型(LLM)
本单元带你认识大语言模型(Large Language Model,简称 LLM):它是什么、如何逐 token 预测、如何训练与微调,以及版本背后的含义。学完本单元,你将能够:描述什么是 LLM、解释 LLM 如何训练,并更好地理解 LLM 微调。
大语言模型依赖自然语言处理(NLP)和机器学习来理解和生成类似人类的文本。如果你还没有获得 自然语言处理基础(Natural Language Processing Basics) 徽章,建议在开始本模块之前先完成它。
什么是大语言模型?
想象你有一个超级聪明的数字助手,它阅读过海量的文本——包括书籍、文章、网站和其他文字内容,一直到今天。但它不像图书馆那样"装着"整本书,而是能够处理模式、建立联系、产生创意洞察,或基于训练文本数据执行复杂计算。
你可以向这个数字助手提出任何问题,它会根据自己"读过"的内容尝试给出答案。它并不像人一样真正"理解",但非常擅长记忆和连接信息。
大语言模型(LLM)就像这个助手。LLM 是先进的计算模型,旨在理解和生成类似人类的文本。它们在海量文本数据上训练,以学习模式、语言结构以及词语和句子之间的关系。
大语言模型如何工作?
从本质上讲,像 ChatGPT、Gemini 或 Claude 这样的 LLM 一次预测一个 token(例如一个词或一个字符),从头到尾构建一个序列。收到请求后,它们尝试预测下一个 token,然后再下一个,如此反复。
LLM 所做的预测,指的是它们根据训练期间见过的模式来生成或补全文本的能力,在海量文本上执行令人印象深刻的模式识别。它们能在广泛的主题上生成连贯且符合上下文的内容。
"大语言模型"中的"大",指的是这些模型的规模和复杂度。它们使用大量的计算资源,例如带有多个处理器和大量内存的强大服务器。这些资源让模型能够处理海量数据,从而提升其理解和生成高质量文本的能力。
参数规模:从 GPT-3 到 GPT-4
LLM 的规模各不相同,但通常包含数十亿个参数。参数是模型在训练过程中学习的因素,构建了模型对语言的理解。参数越多,模型学习并捕捉数据中复杂模式的能力就越强,从而提升其生成类似人类文本的能力。
为了让你对 LLM 使用的参数量有个概念:GPT(生成式预训练 Transformer)模型的早期版本,比如 OpenAI 的 GPT-3,大约有 1750 亿个参数。这些模型被认为相当庞大,显著提升了语言处理的能力。OpenAI 更新的模型 GPT-4 估计有 1.76 万亿个参数。
这些数字确实令人印象深刻,但模型的庞大规模也伴随着挑战,例如训练所需的计算资源、对环境的影响、潜在的偏见等。
大语言模型就像知识渊博的虚拟助手,能帮助完成各种与语言相关的任务:协助写作、提供信息、给出创意建议,甚至参与对话。模型创造者的目标是让与技术交互变得更自然、更人性化。不过,用户应当意识到它们的局限性,把它们当作工具而非绝对可靠的真理来源。
LLM 是如何训练的?
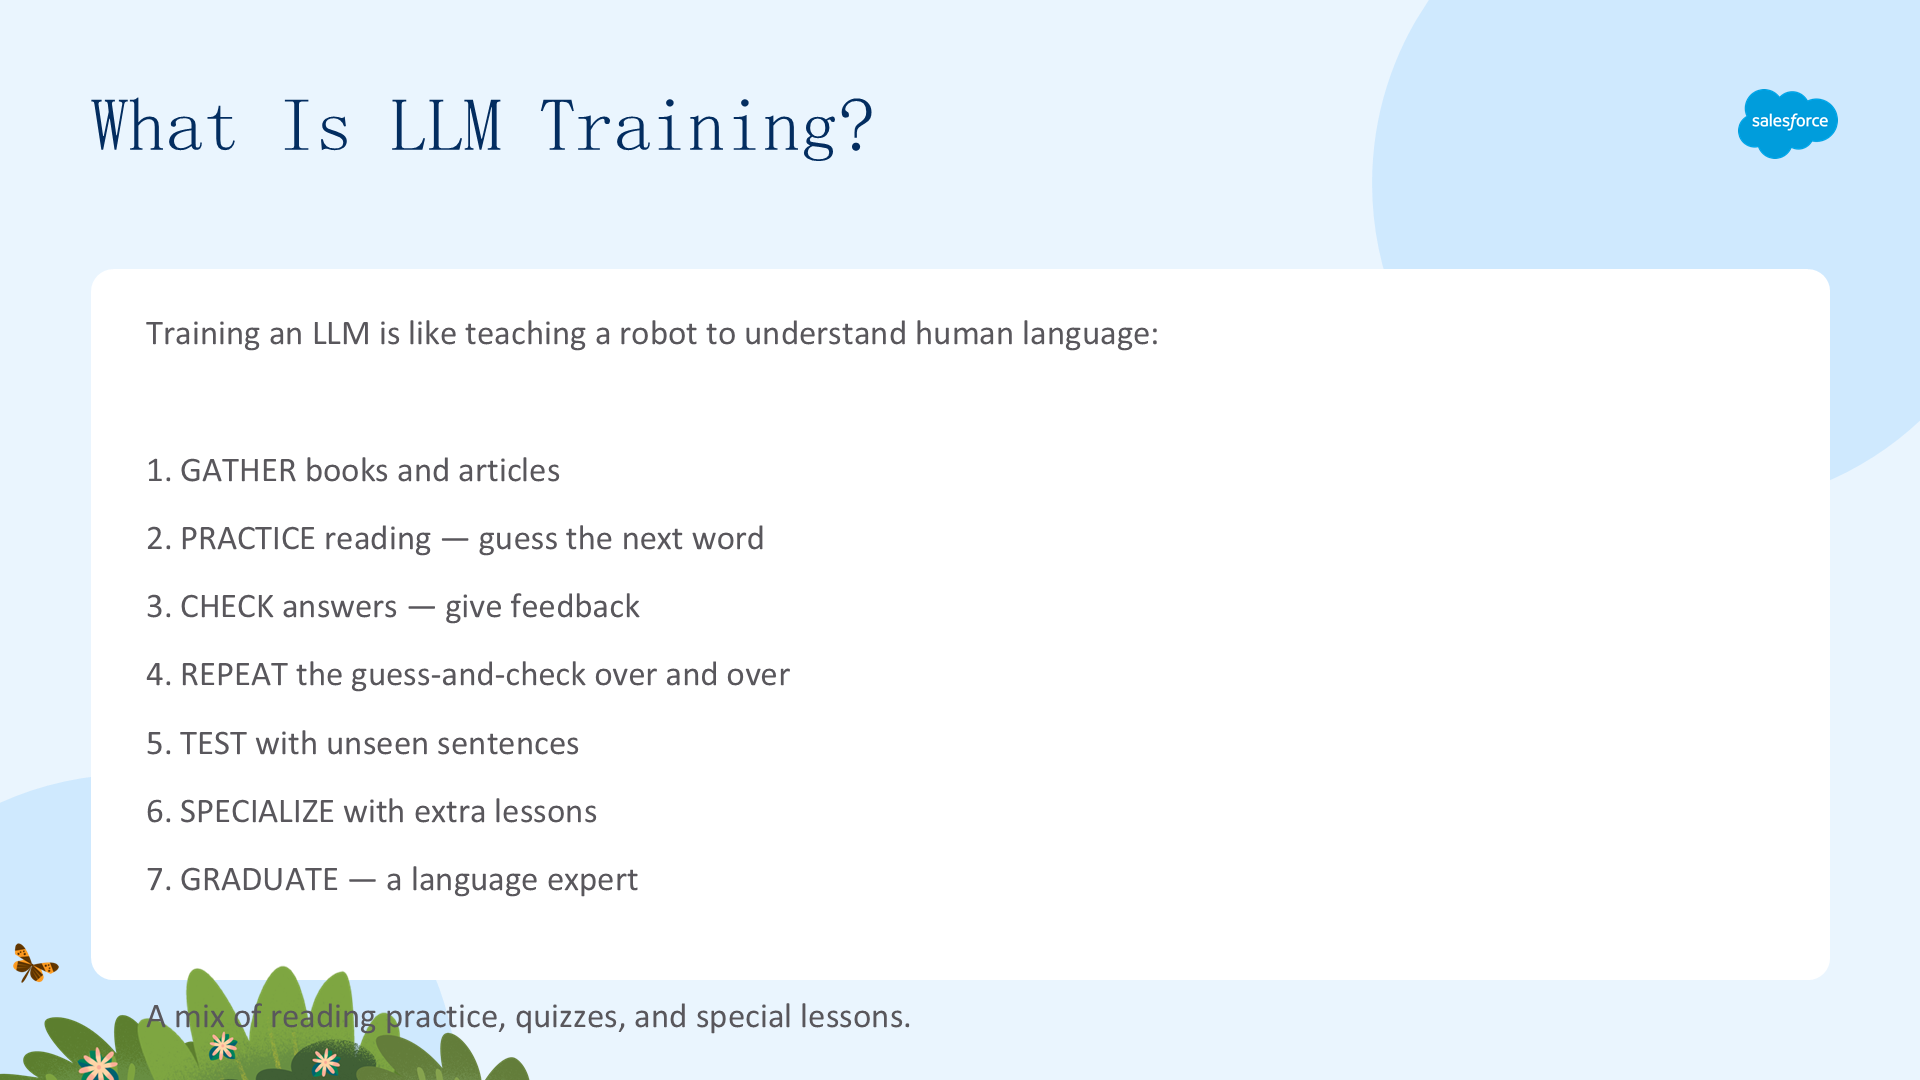
训练一个 LLM 就像教一个机器人理解和运用人类语言。具体可以这样做:
- 收集书籍和文章:想象收集一大堆书籍、文章和其他文字来教机器人。
- 练习阅读:让机器人读一个句子,然后猜下一个词。一开始它可能随机猜测,因为它还在学习。
- 核对答案:机器人猜完后,你给它看原文中正确的词。如果猜错了,就给它反馈,比如"哎呀,不对!"
- 重复:用大量句子反复进行这种"猜与核对"。随着阅读增多,机器人猜下一个词的能力会越来越好。
- 测试:偶尔用机器人没见过的句子来测试它,看它到底是真学会了还是只是在死记硬背。
- 专精:如果你想让机器人特别擅长某个领域(比如医学语言),可以给它额外上医学书籍的课。
- 毕业:一旦机器人真正擅长理解和生成文本,就可以说"干得好!"并让它帮助人们完成各种语言任务。
就是这样!训练就像阅读练习、测验和专项课程的结合,直到机器人成为语言专家。同样的基本原理也适用于 LLM。
什么是微调(Fine-Tuning)?
微调是在一个更小、更特定的数据集上进一步训练预训练模型的过程。
想象你已经用世界上最大的菜谱教会了一个机器人做世界各地的菜肴——那是基础训练。现在,假设你想让机器人专精于做意大利菜。你给它一本更小、更详细的意大利菜谱,让它练习这些菜谱。这种专门化的练习就像微调。
微调就是取一个"什么都懂一点"的机器人(或模型),然后针对特定主题进一步训练它,直到它成为该领域的专家。
为什么微调很重要?
- 迁移学习(Transfer Learning):预训练模型已经从大量训练数据中学到了许多通用特征。微调让这些模型能够用相对较小的数据集,把这些通用知识迁移到特定任务上。
- 效率(Efficiency):从零开始训练一个深度学习模型需要大量数据和计算资源。有了微调,你从一个已经懂很多的模型开始,因此可以用更少的数据和时间获得良好性能。
- 更好的性能(Better Performance):在特定任务上微调的模型,往往优于在该任务上从零训练的模型,因为它们受益于初始训练期间捕捉到的更广泛知识。
版本意味着什么?
对每个版本来说,底层架构可能保持相似,但规模、训练数据或某些参数会发生变化。每个新版本都旨在改进前一个版本的弱点、处理更广泛的任务,或减少偏见和错误。下面是一个简化的解释:
- 版本 1(例如 OpenAI 的 GPT-1 或 Google 的 BERT-base):模型的首次发布。它工作得不错,但就像小说的初稿——还有改进空间。使用一定量的数据,并拥有特定数量的参数(就像模型的"脑细胞")。
- 版本 2(OpenAI 的 GPT-2):基于第一版的经验做调整,就像根据反馈修改你的小说。通常更大、参数更多,可能在更多样化或更大的数据集上训练。
- 版本 3(OpenAI 的 GPT-4):融入更多反馈、研究和技术进步。规模大得多,例如 GPT-4 有 1.76 万亿参数,能力更强,但所需资源也更多。
微调版本与其他迭代
除了主要版本,有时还有针对特定任务微调过的专门版本,就像把一本通用小说改编成悬疑、爱情或科幻版本。
其他迭代:像 BERT 这样的模型有变体(RoBERTa、DistilBERT 等),它们在训练策略或架构上做了调整,本质上就是不同的"版本"。像 Claude 这样的模型则有 Haiku、Sonnet 和 Opus 等变体,用于优化不同水平的性能、能力和推理能力。
LLM 的版本就像一部丛书连续出版的各版,每一次新版都力求成为更精炼、更广阔、更引人入胜的读物。接下来,让我们看看 Salesforce 是如何使用 LLM 的。
二、Salesforce 如何使用大语言模型
本单元将介绍 Salesforce 如何为 LLM 带来信任、如何选择正确的 LLM 选项,以及各种可用 LLM 选项的局限性。学完本单元,你将能够:解释 Salesforce 如何为 LLM 提供安全保障、为业务选择正确的 LLM 选项,并描述可用 LLM 选项的局限性。
以信任为先
信任是 Salesforce 的第一价值观。因此,Salesforce 以安全、可信的方式使用大语言模型(LLM)。维护这种信任的关键在于 Einstein 信任层(Einstein Trust Layer)。Einstein 信任层通过无缝集成到 Salesforce 最终用户体验中的数据和隐私控制,确保生成式 AI 的安全。这些控制让 Einstein 能够安全地使用检索增强生成(RAG)将回答扎根于你的客户和公司数据,而不会引入潜在的安全风险。
用最简单的话来说,Einstein 信任层是一系列网关和检索机制,它们协同工作,实现可信且开放的生成式 AI。
值得信赖的 Salesforce Agent
Agentforce 代理通过 Einstein 信任层使用领先的 LLM,利用 RAG 结合 Salesforce 和 Data 360 数据构建安全的提示词。这创造了一个丰富且安全的环境,让 AI 代理能够支持员工和客户。
这些代理不只是提供建议——它们能独立完成任务。例如,它们可以处理客户咨询、排查问题,甚至在无需人工干预的情况下给出销售建议,同时始终用信任层保护数据并提供可信的回答。
选择最适合的大语言模型
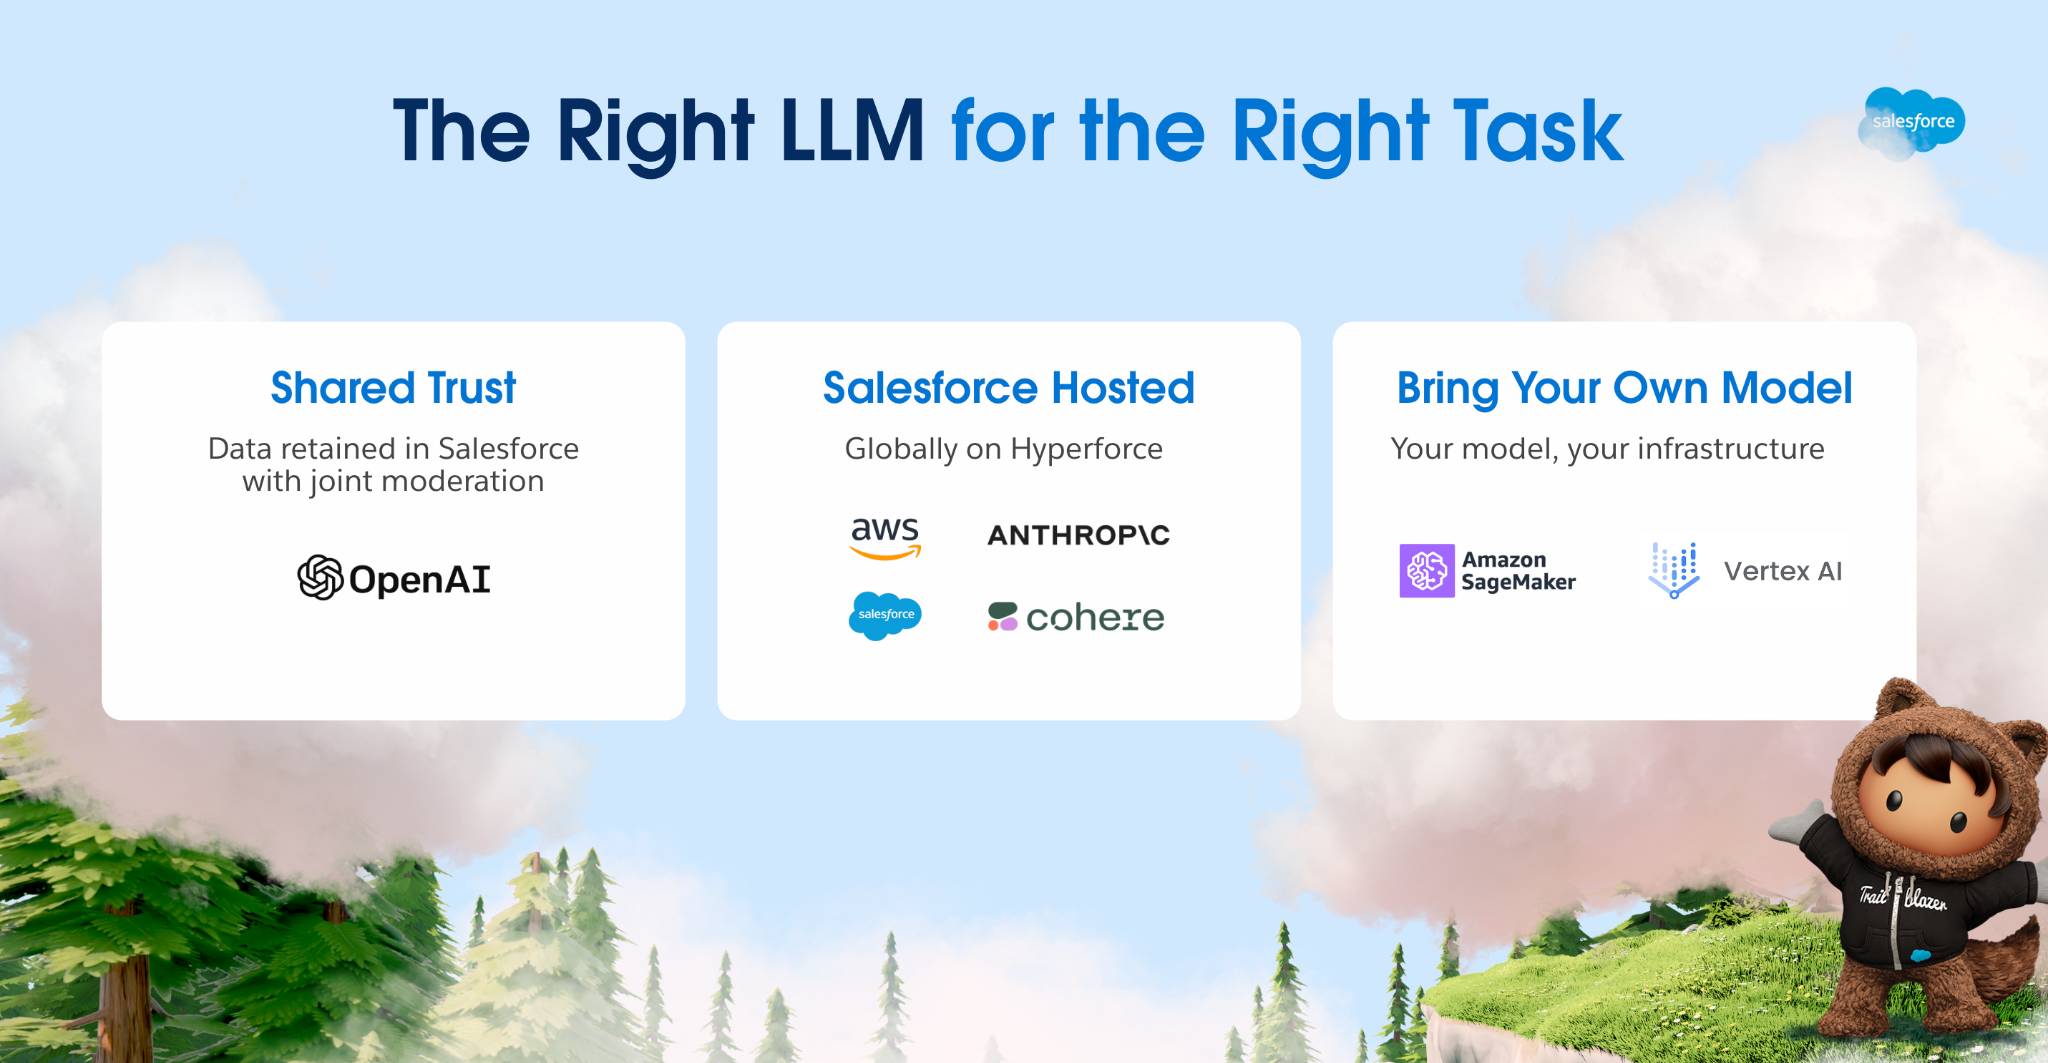
所有 Agentforce 推理引擎的调用默认使用 OpenAI GPT-4o,某些情况下使用 Azure OpenAI GPT-4o。不过,你可以根据业务需求选择其他模型。重要的是:为正确的任务选择正确的模型,能帮助你更快上手生成式 AI,并取得预期的结果。Salesforce 为多种不同 LLM 提供部署能力,同时帮助企业维护其数据隐私、安全、数据驻留和合规目标。
许多企业使用不同的 LLM 来处理特定类型的用例,比如编码、情感分析或内容生成。为某个用例选择模型时,要牢记模型的能力、成本、响应质量和速度。你也可以选择地理感知(geo-aware)模型,这些模型会根据你的组织配置 Data 360 的位置,自动将 LLM 请求路由到附近的数据中心,从而让你对数据驻留拥有更强的控制力并降低延迟。
下图展示了"为正确任务选择正确模型"的三种信任层级:
使用 Salesforce 托管的 LLM
Salesforce 托管的 LLM是一种跨互联网访问 LLM 的好方式,能让你快速上手生成式 AI。你可以通过 Models API 或 Prompt Builder,使用不同的 Salesforce 托管模型来定制你的 AI 实现。Salesforce 提供多种默认启用的模型,以加快配置过程。
要查看当前 Salesforce 托管模型的列表,请访问 大语言模型支持(Large Language Model Support) 帮助文档。
使用 Salesforce 托管的第三方 LLM
你也可以在 Salesforce 内部托管模型。作为 Salesforce 对开放生态承诺的一部分,Einstein 被设计为在 Salesforce 基础设施内部托管来自 Amazon、Anthropic、Cohere 等厂商的 LLM。Einstein 将帮助你在 Salesforce 基础设施内维护客户提示词和响应。
此外,Salesforce 与 OpenAI 建立了共享信任合作关系,通过 Einstein 信任层安全地交付内容。
自带大语言模型(BYOLLM)
如果你已经在投资自己的 LLM,可以将其连接到 Salesforce,用于自定义 Prompt Builder 模板。即使你在 Salesforce 之外训练了自己的领域专用模型,并将数据存储在自己的基础设施上,你依然可以从 Einstein 中获益。
当你通过已连接的外部 LLM 执行提示词时,它的工作方式与内部连接的 LLM 完全一样,在把内容分享给用户之前,会通过 LLM 网关 和 Einstein 信任层 路由请求。
BYOLLM 的选项变化很快!请持续关注相关资源以获取最新更新。