一、评估 AI 代理的价值(Evaluate AI Agent Value)
学完本单元,你将能够:区分技术故障(technical failures)与失败的体验(failed user experiences);用启发式优先级模型(heuristic priority model)对代理失败做分诊(triage)。
如何评估代理价值(How to Evaluate Agent Value)
在本单元,你将学习如何超越技术基准(benchmark),理解用户实际上如何感知 AI 代理。你将探索一个三层失败分类法(three-tier failure taxonomy),并学习提升信任和采用的实用设计策略。
「能运行」与「值得用」之间的差距(The Gap Between Working and Worth It)
成功不只是模型在基准上的表现,而是用户对价值的感知,以及他们对工具所建立的信任。当用户说代理「不行」时,他们通常不是在说 404 错误或系统崩溃。AI 交互是微妙的。用户往往缺乏技术词汇来描述「为什么这段对话感觉不对劲」,所以只能给出泛泛的抱怨。而这种模糊性,恰恰把真正的失败隐藏了起来,让团队看不到。
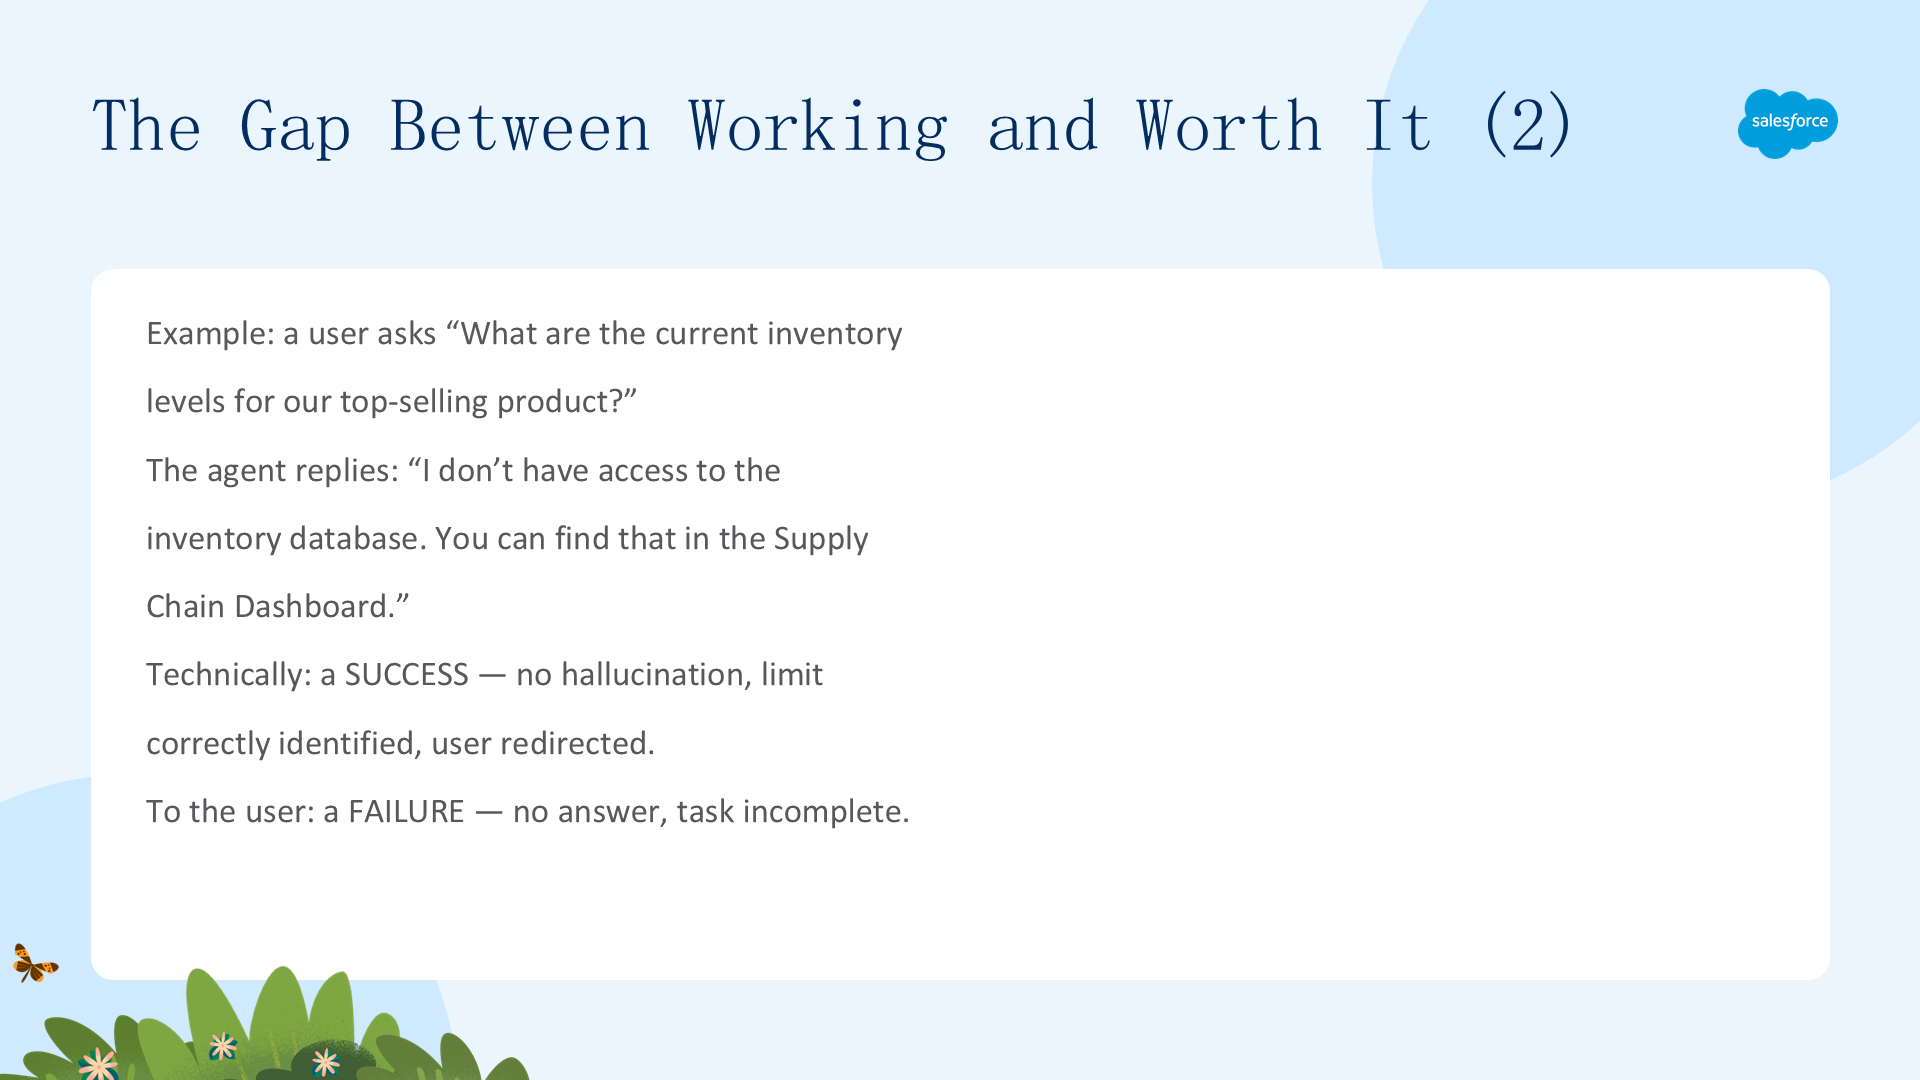
举个例子:用户问代理「我们最畅销产品当前的库存水平是多少?」代理回答:「我无权访问库存数据库。你可以在供应链仪表板中找到该信息。」
技术上?这是一次成功的交互——代理没有幻觉,正确地识别了自己的限制,并重定向了用户。但对用户来说?这是一次失败——他们没有拿到完成任务所需的答案。对他们而言,代理「没起作用」。
代理质量启发式(Agent Quality Heuristics)
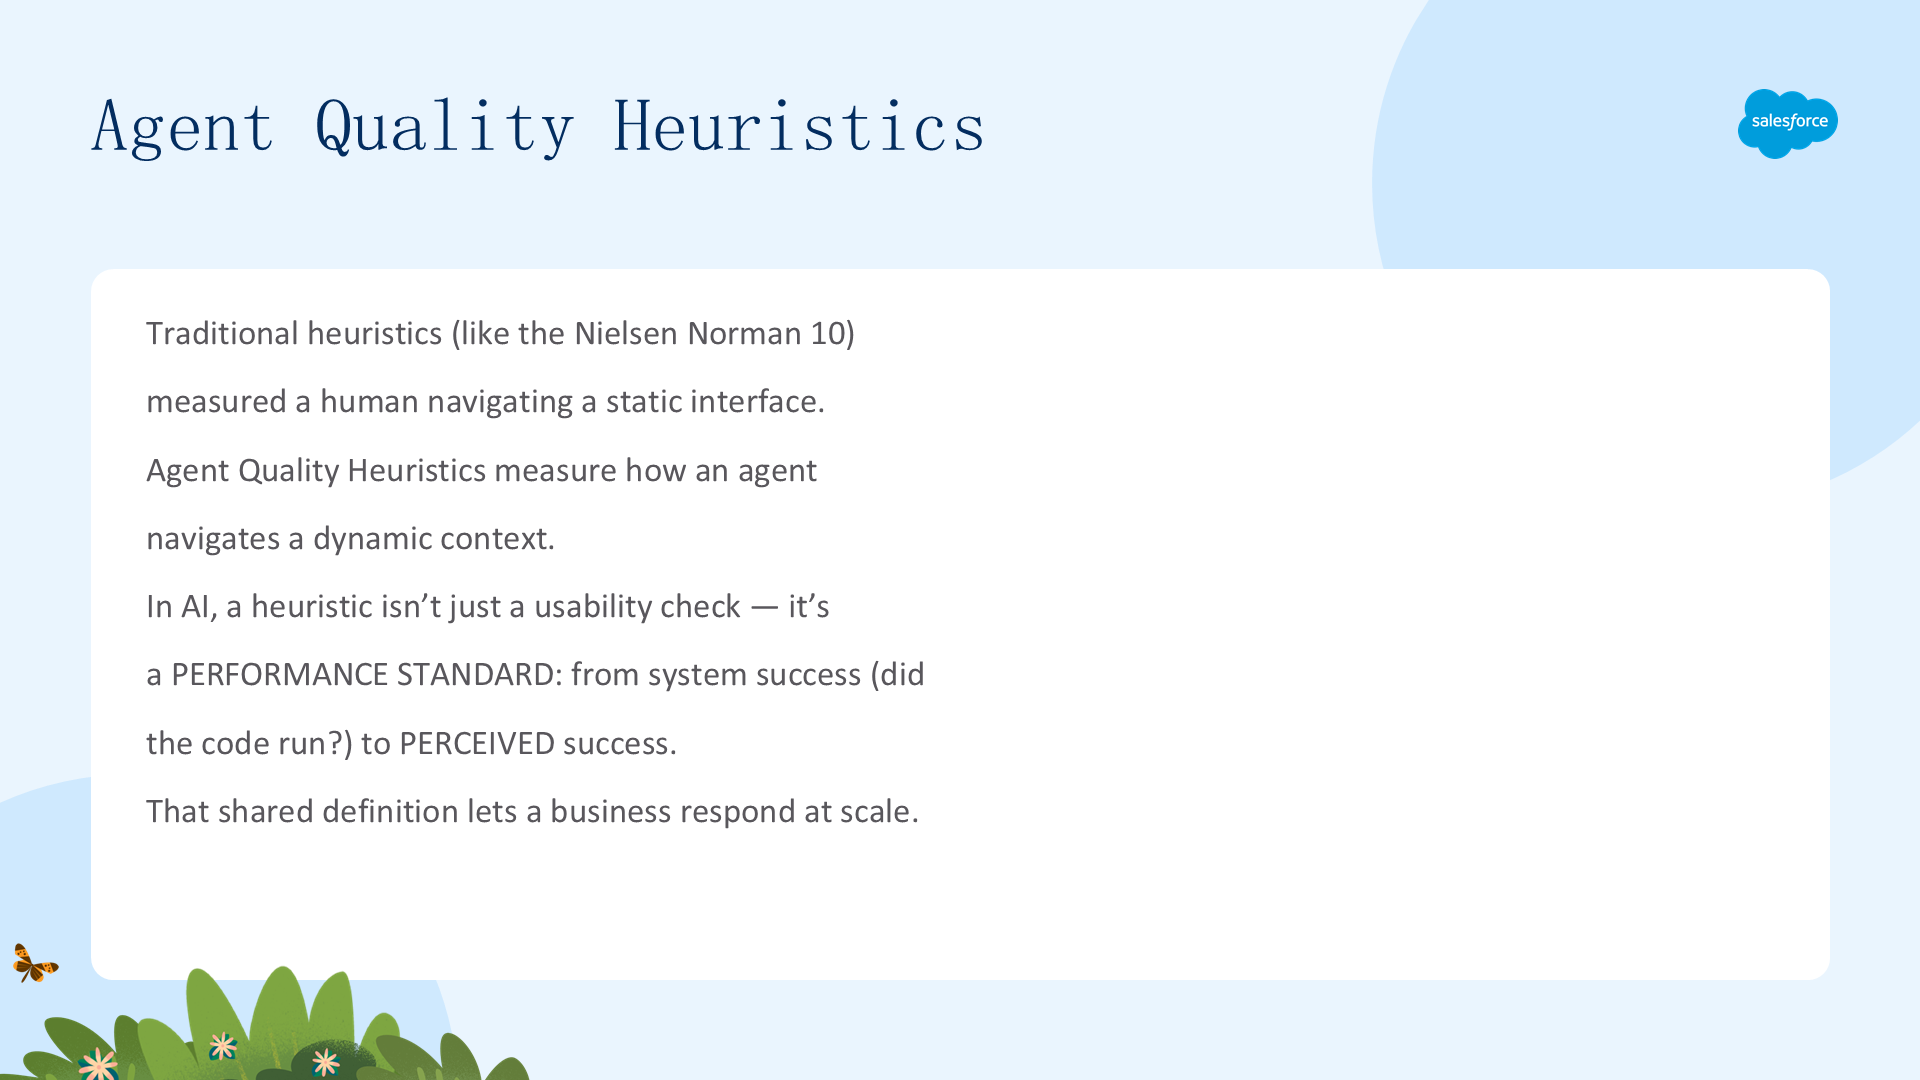
启发式(heuristics)一直是帮助设计师评估质量的经验法则。但传统启发式(如 Nielsen Norman 的 10 条可用性启发式)衡量的是「人如何浏览一个静态界面」,而代理质量启发式衡量的是「代理如何驾驭一个动态上下文」。
在 AI 世界里,启发式不只是可用性检查——它是一个性能标准。我们从简单的「系统成功」(代码是否运行正确?)走向「感知成功」,确保响应有价值、及时,并且足够可信,让用户能持续地依赖它。
这一点至关重要:要在规模化场景下响应最终用户,企业需要一个清晰、共享的「好的用户体验是什么样」的定义,以及如何评估那些不达标的体验。这需要考察以用户视角为中心的、代理成功的各种指标,再把它们映射到其影响的严重程度。
代理失败的三个层级(The Three Tiers of Agent Failure)
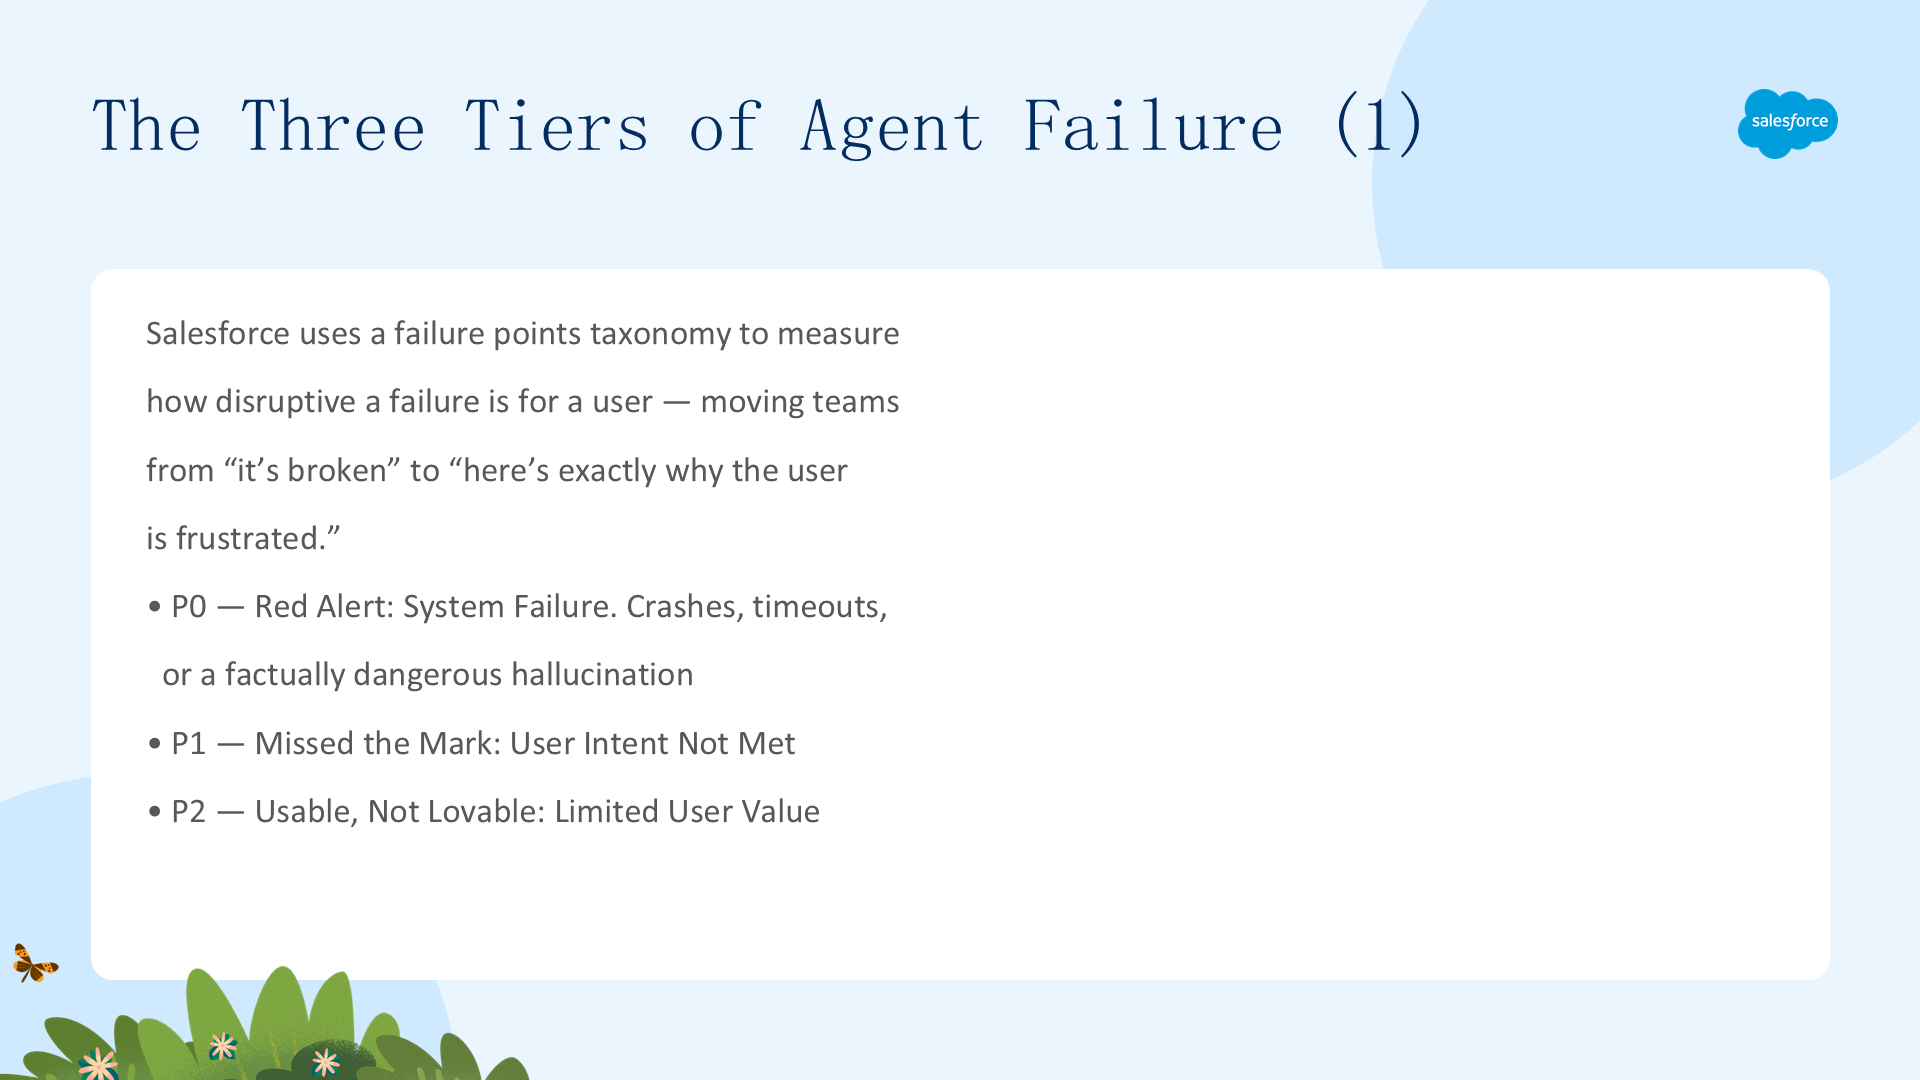
Salesforce 使用一个故障点分类法(failure points taxonomy)来判断某个失败对用户的破坏性有多大。这帮助团队从「它坏了」转向「这正是用户受挫的原因」。
| 严重级别 | 层级 | 描述 |
|---|---|---|
| P0 | 红色警报:系统故障(Red Alert: System Failure) | 最高严重级别。代理崩溃、超时,或给出一个在事实上危险的荒谬幻觉(hallucination)。 |
| P1 | 没打中要害:用户意图未满足(Missed the Mark: User Intent Not Met) | 代理功能正常,但输出的结果与用户目标不一致。它误解了请求的「是什么」或「为什么」。 |
| P2 | 能用但不可爱:用户价值有限(Usable, Not Lovable: Limited User Value) | 代理功能正常且准确,但输出质量低、太啰嗦,或需要用户做更多工作才能得到真正的答案。 |
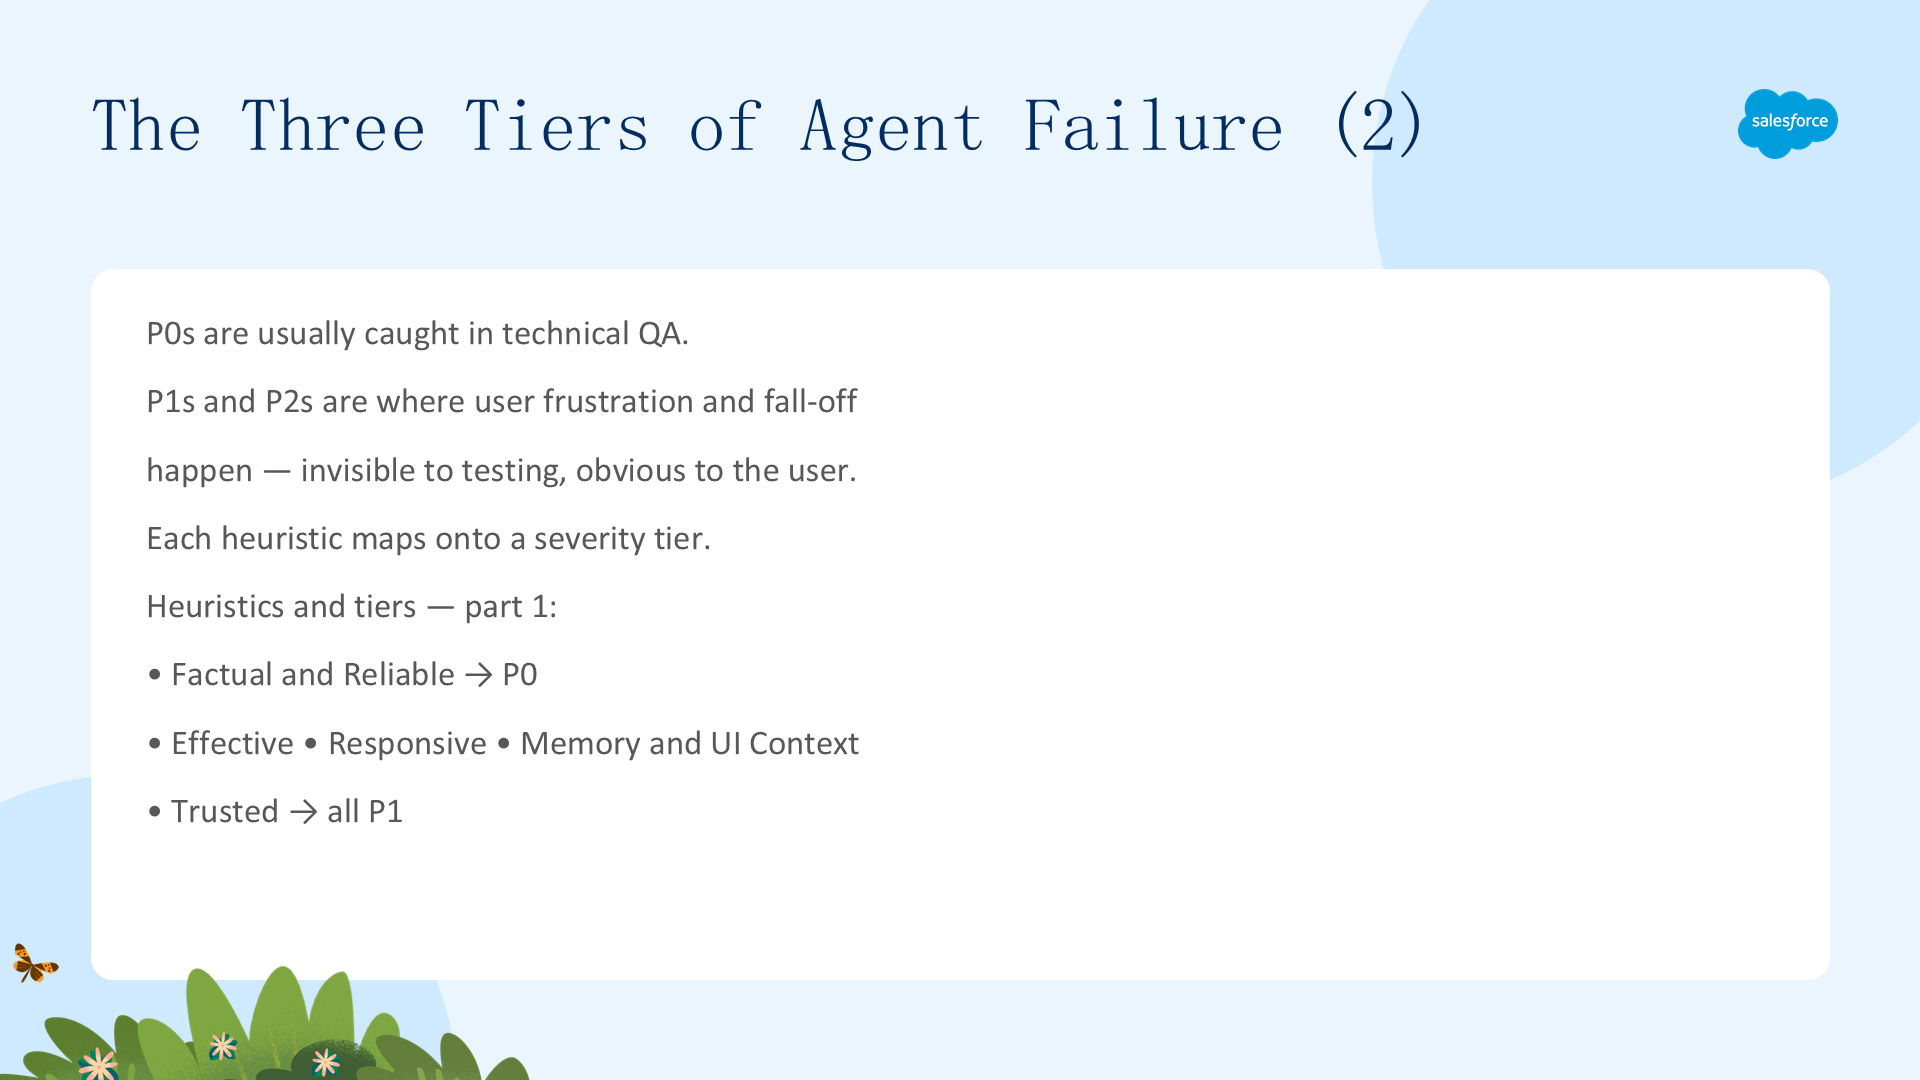
P0 通常在技术质量保证(QA)中被发现,而 P1 和 P2 往往是用户受挫和流失的风险所在——它们难以在传统测试中被识别,但对最终用户来说却痛苦地明显。每条启发式都映射到一个严重级别,这让设计师能把评估中看到的交互,转化为一套可用的分诊系统。
| 启发式 | 打分时的诊断问题 | 严重级别 |
|---|---|---|
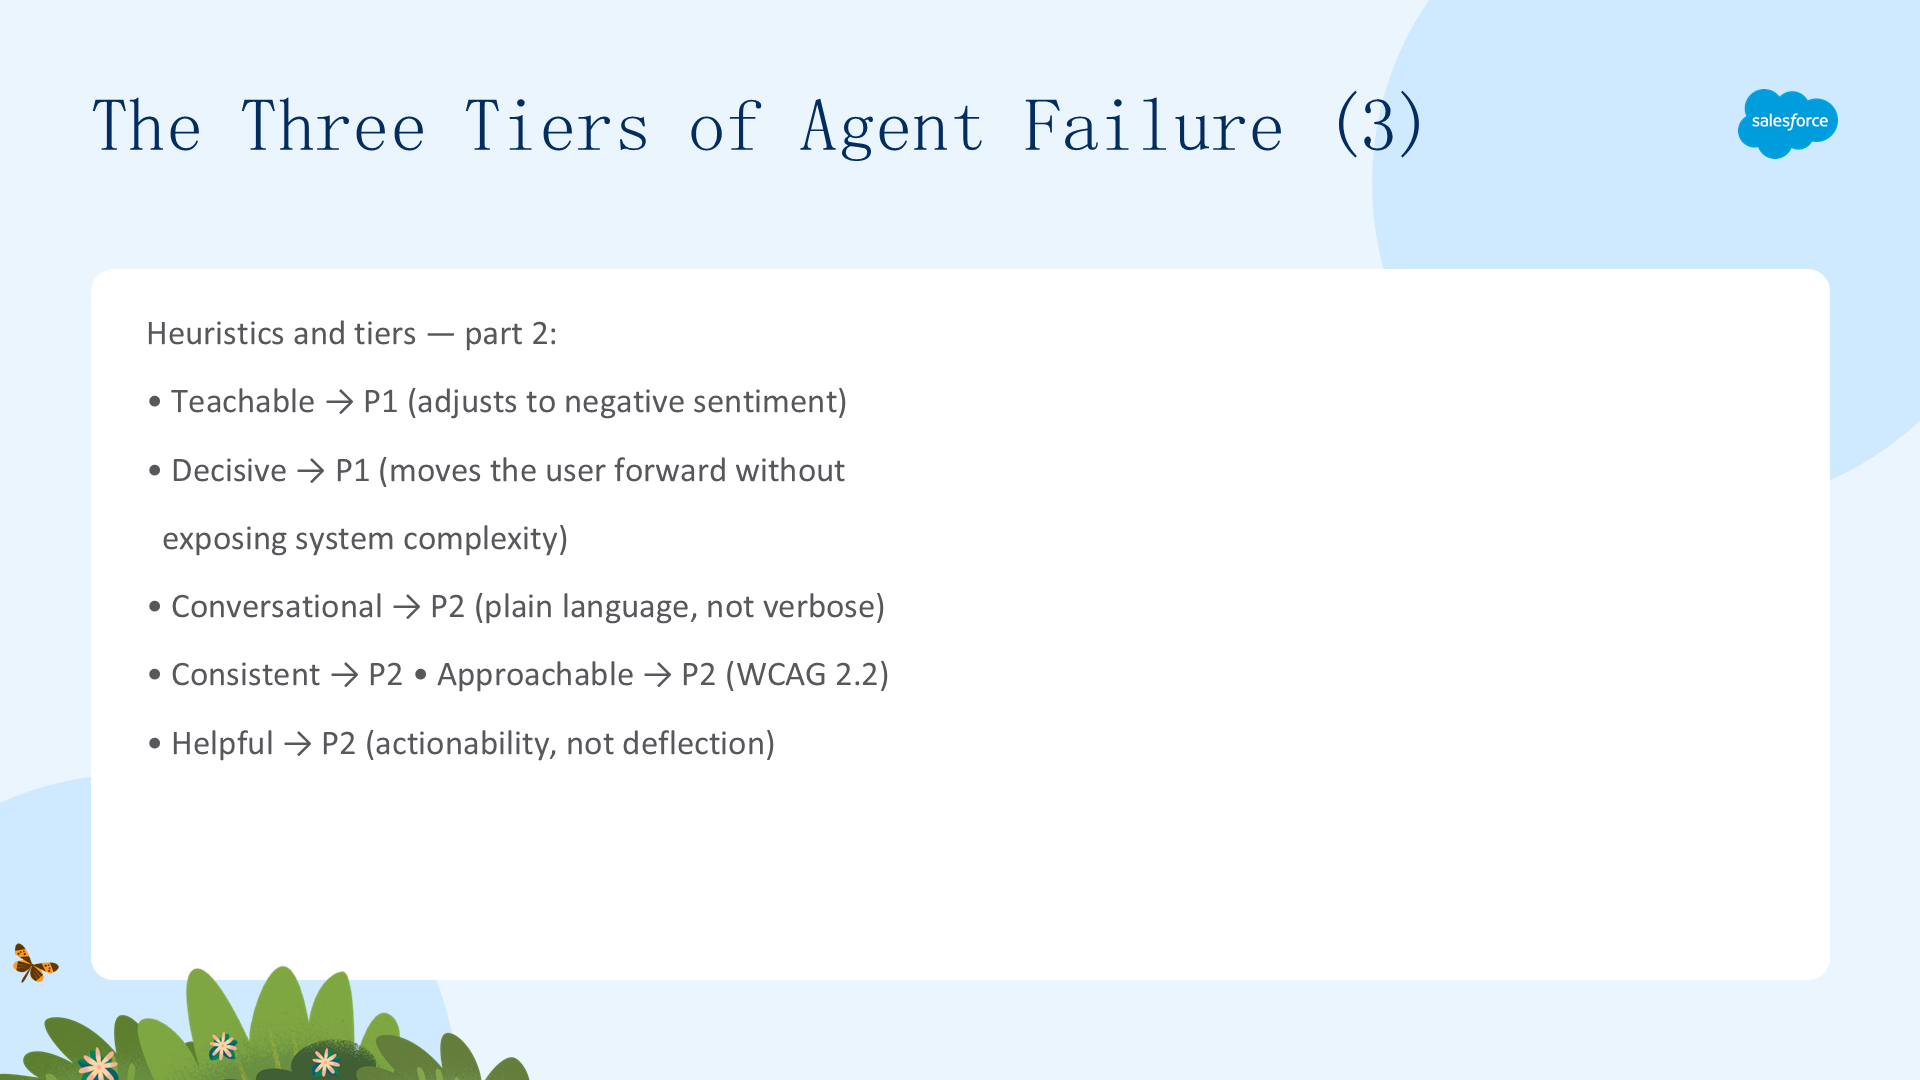
| Factual and Reliable(事实可靠) | 响应在当下是否被感知为正确?是否相关、无幻觉、无矛盾、无错误?是否避免与先前已确立的上下文或信息相矛盾? | P0 |
| Effective(有效) | 即使系统按设计运行,输出是否满足了用户的实际意图? | P1 |
| Responsive(响应式) | 如果初始提示含糊,代理是否会主动提出澄清性问题? | P1 |
| Memory and UI Context(记忆与 UI 上下文) | 它是否有效利用 UI 页面上下文和先前轮次的信息,提供更相关的响应,而不需要用户重复自己? | P1 |
| Trusted(可信) | 代理是否在适当的边界和权限内运作?是否避免「只陈述限制、却不提供可行动的替代方案」这样的单纯推脱? | P1 |
| Teachable(可教) | 代理是否会根据负面的用户情绪(如「我不是这个意思」)做出调整? | P1 |
| Decisive(果断) | 代理是否以清晰的方向和信心推动用户前进,而不暴露内部系统复杂性、不过度谨慎、不制造决策瘫痪? | P1 |
| Conversational(对话自然) | 是否使用平实的语言,避免太嘈杂或太啰嗦? | P2 |
| Consistent(一致) | 品牌声音、术语和格式在各轮次之间是否保持一致? | P2 |
| Approachable(易接近) | 是否具有包容性、可访问性(WCAG 2.2),并易于交互? | P2 |
| Helpful(有帮助) | 是否提供可行动性和下一步,而不是推给自助服务? | P2 |
通过理解影响用户对代理主观体验的因素,设计师就能为代理的初次成功和持续改进做好规划。启发式提供了评估代理行为的共享标准,而把代理失败映射到易于理解的优先级层级,则让识别和干预摩擦时刻变得更容易。在下一个单元,你将探索设计师如何把启发式评估中的洞察应用到代理失败的分诊中。
二、对代理响应做分诊(Triage Agent Responses)
学完本单元,你将能够:基于启发式分数优先排序代理行为设计;建立一个评估与改进代理行为的持续循环。
用分诊应对问题(Tackle Trouble with Triage)
代理失败并不总是显而易见的。与传统数字体验不同,代理可能一边继续产出响应,一边却没能解决用户的问题。薄弱的 prompt、缺失的数据、或不清晰的意图,都可能导致听起来合理、却无法帮助用户成功的回答。体验启发式帮助团队检测这些微妙的失败,并优先确定要修复什么。
启发式评估和严重程度映射,让设计师理解「行为模式在哪里失去价值」,以及「由于一次感知失败,有多少价值处于风险之中」。这样,他们就能优先干预那些对真实体验影响最大的地方。
这对设计师来说是另一个关键转变。虽然「把精力集中在最需要的地方」并非新鲜事,但代理需要一个持续的评估与改进过程,它考虑的不仅是 bug 和阻塞点。启发式帮助设计师识别「用户预期」与「代理日志现实」之间的差距;严重程度映射帮助设计师识别最紧迫要弥合的差距,并用其他设计师能理解的语言解释他们的过程。
评估决定体验成败(Evaluations Make or Break Experiences)
评估代理的表现,是维护代理「地面真相」(ground truth)的重要部分——也就是说,确保代理符合设计师对「好」行为的定义。虽然代理能从交互中自行学习,但真正长期塑造代理行为的,是设计干预。当设计师进入「定义代理交互中失败与成功是什么样」的角色时,他们需要能够适应意外或无效的行为模式。
过去设计师的角色可能涉及评估技术上的通过或失败,而代理式设计师需要充分利用代理日志中的丰富洞察。这些日志帮助设计师看到对话的流程,包括任何受挫或失败的点——代理本可以采取不同做法的地方。
在检查日志、评估可信度、易接近性、正确性等启发式因素时,评估者聚焦于两个关键理念:
- 所有评估都始于用户意图,并从用户意图出发。
- 评估应优先考虑失败的严重程度,而不仅仅是失败率。
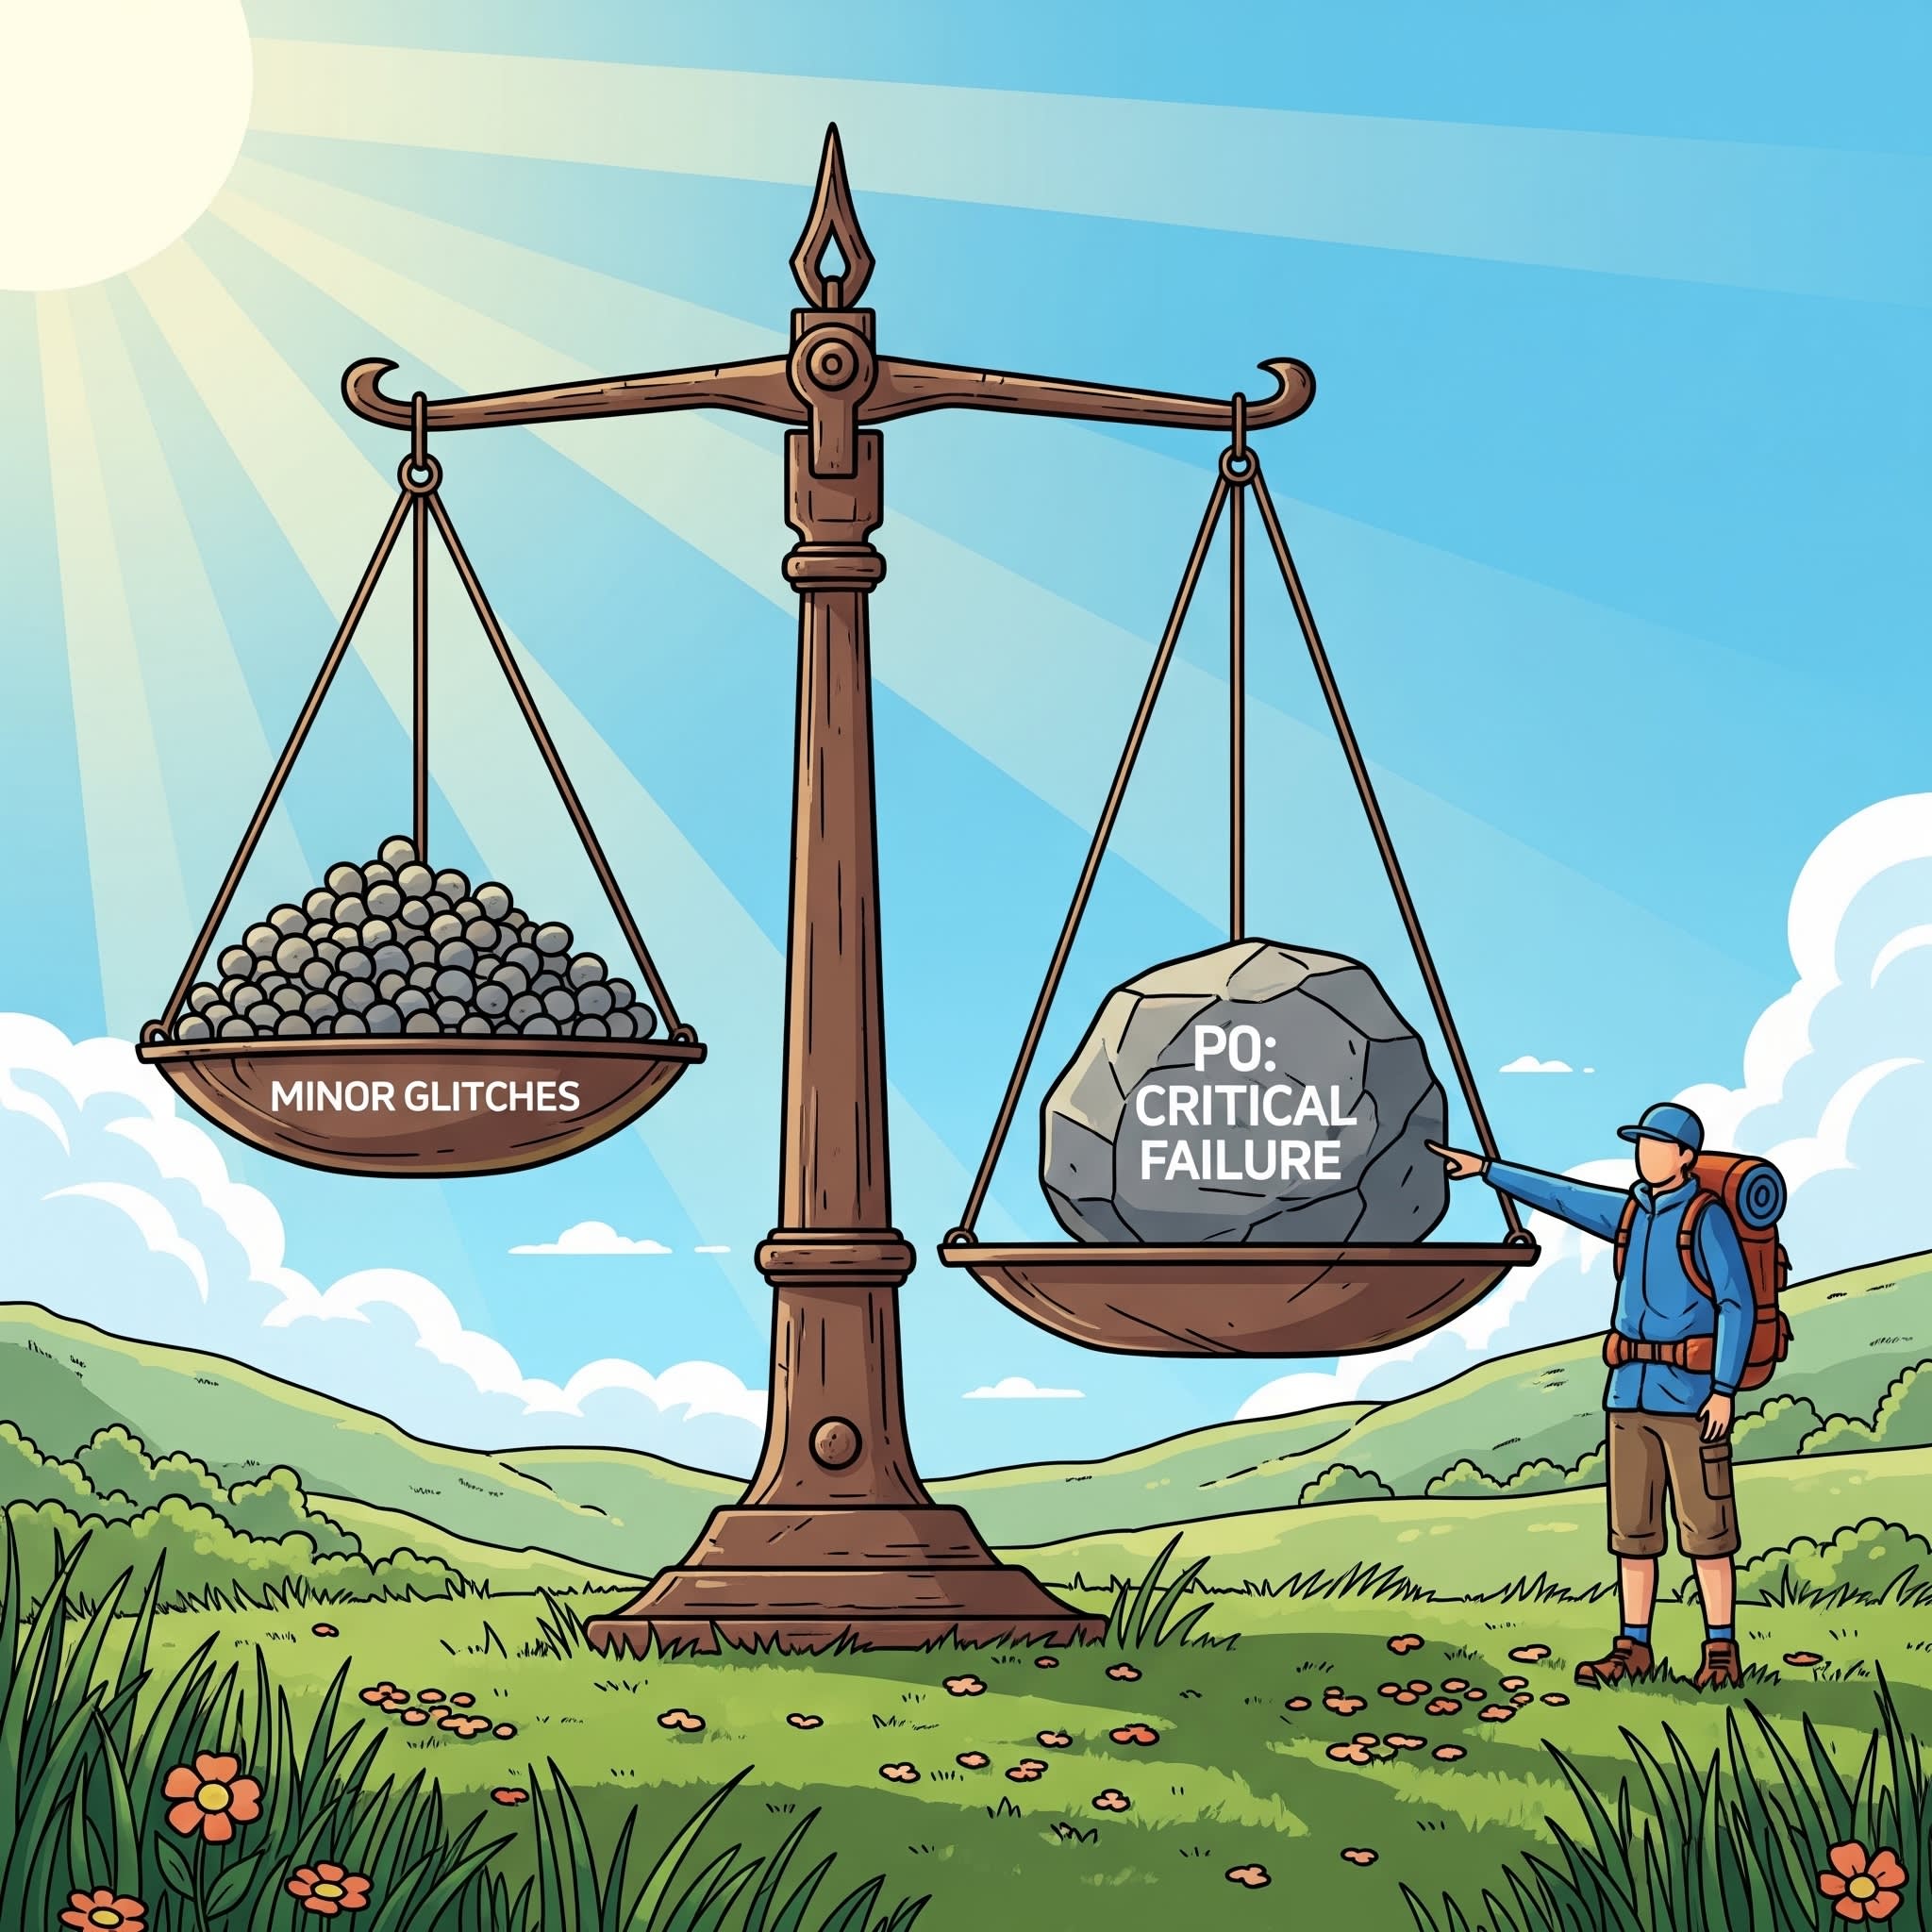
记住这一点,设计师就能把精力集中在最重要的事情上:为用户交付切实的结果,并优先纠正影响最大的失败。让我们看看评估本身具体包含什么。
应用启发式评估代理(Apply Heuristics to Assess Agents)
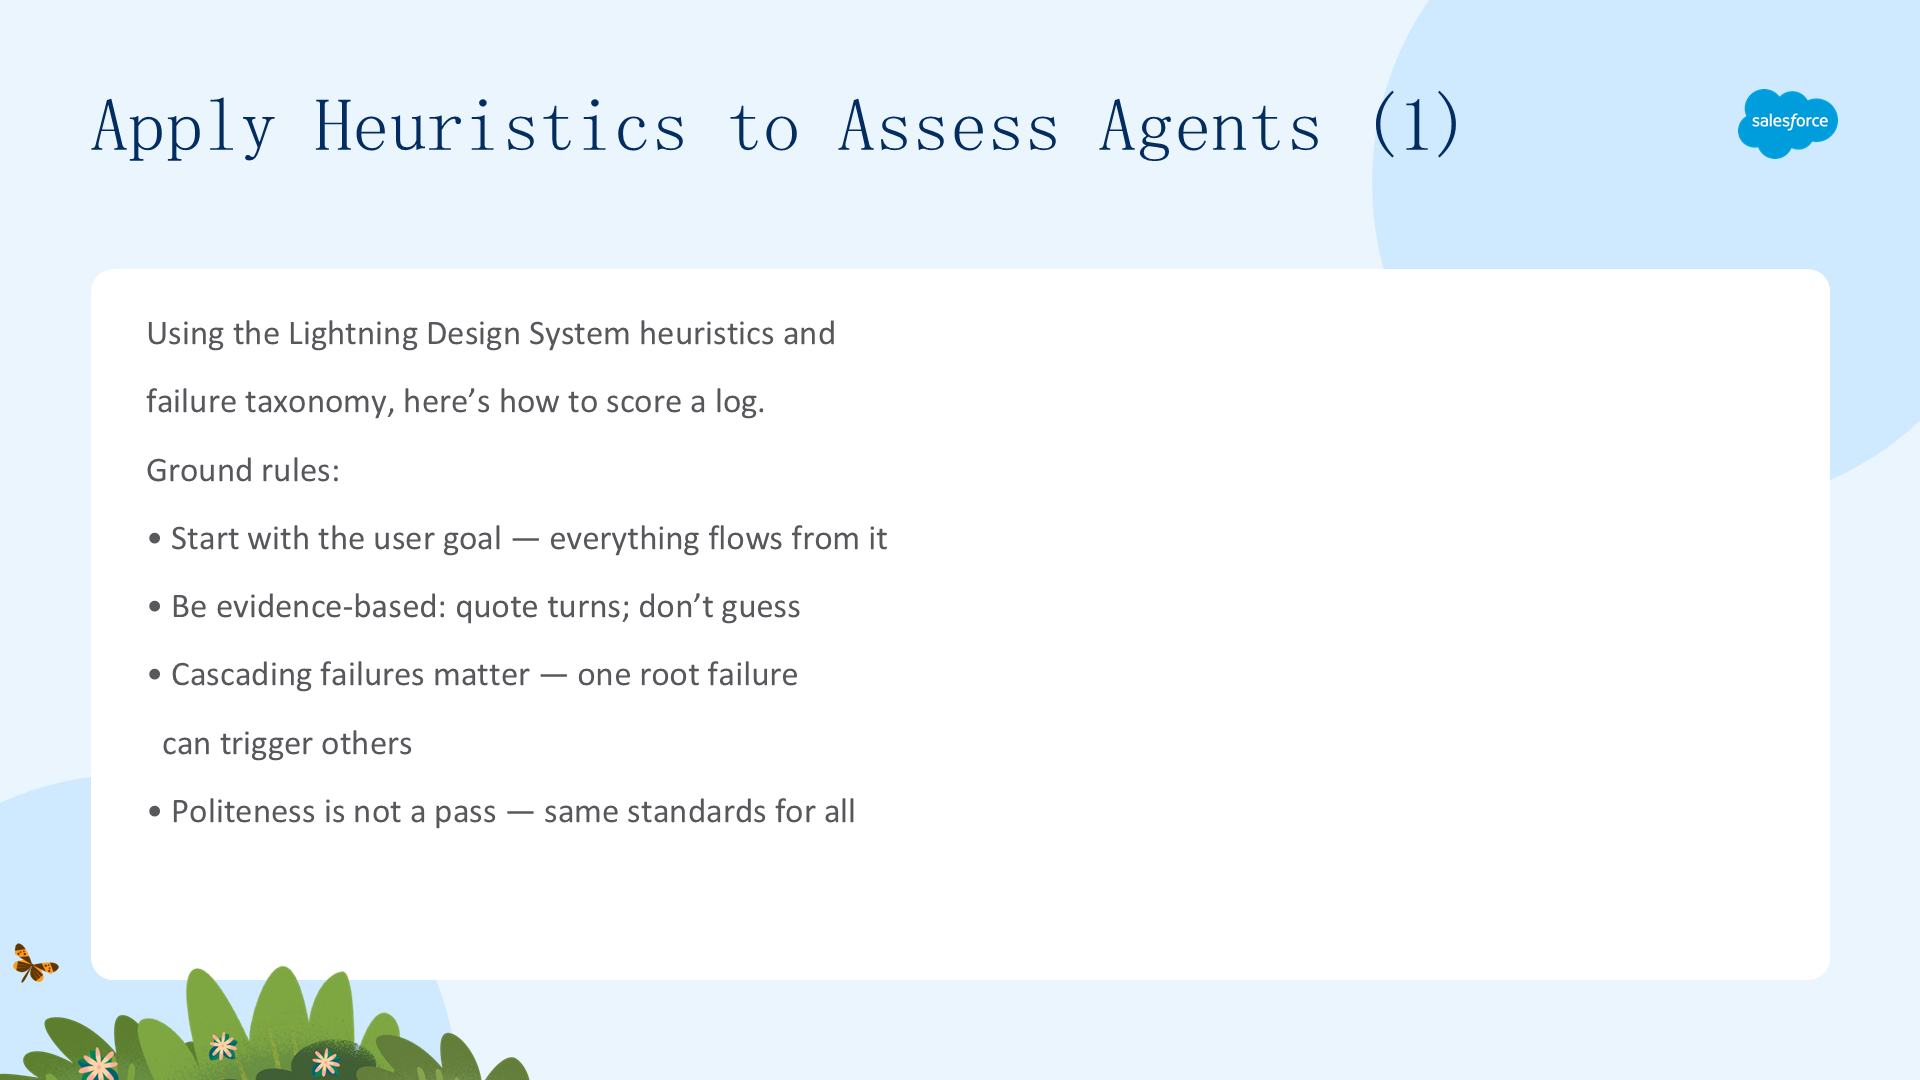
使用 Salesforce Lightning Design System 的代理启发式和失败分类法,下面是一位设计师如何给代理交互日志打分,以及该分数如何指导设计师的下一步行动。
首先,评估者在打分时应牢记几点:
- 从用户目标开始:一切都源于此。
- 基于证据:引用对话中的轮次,不要猜测。
- 级联失败很重要:一个根因失败可能导致后续的失败。
- 寻找矛盾:在某个启发式(如易接近性)上通过,是否会与在另一个启发式(如事实性)上失败相冲突?
- 礼貌不等于通过:聚焦任务价值。
- 一致性:在所有启发式上应用相同的标准。
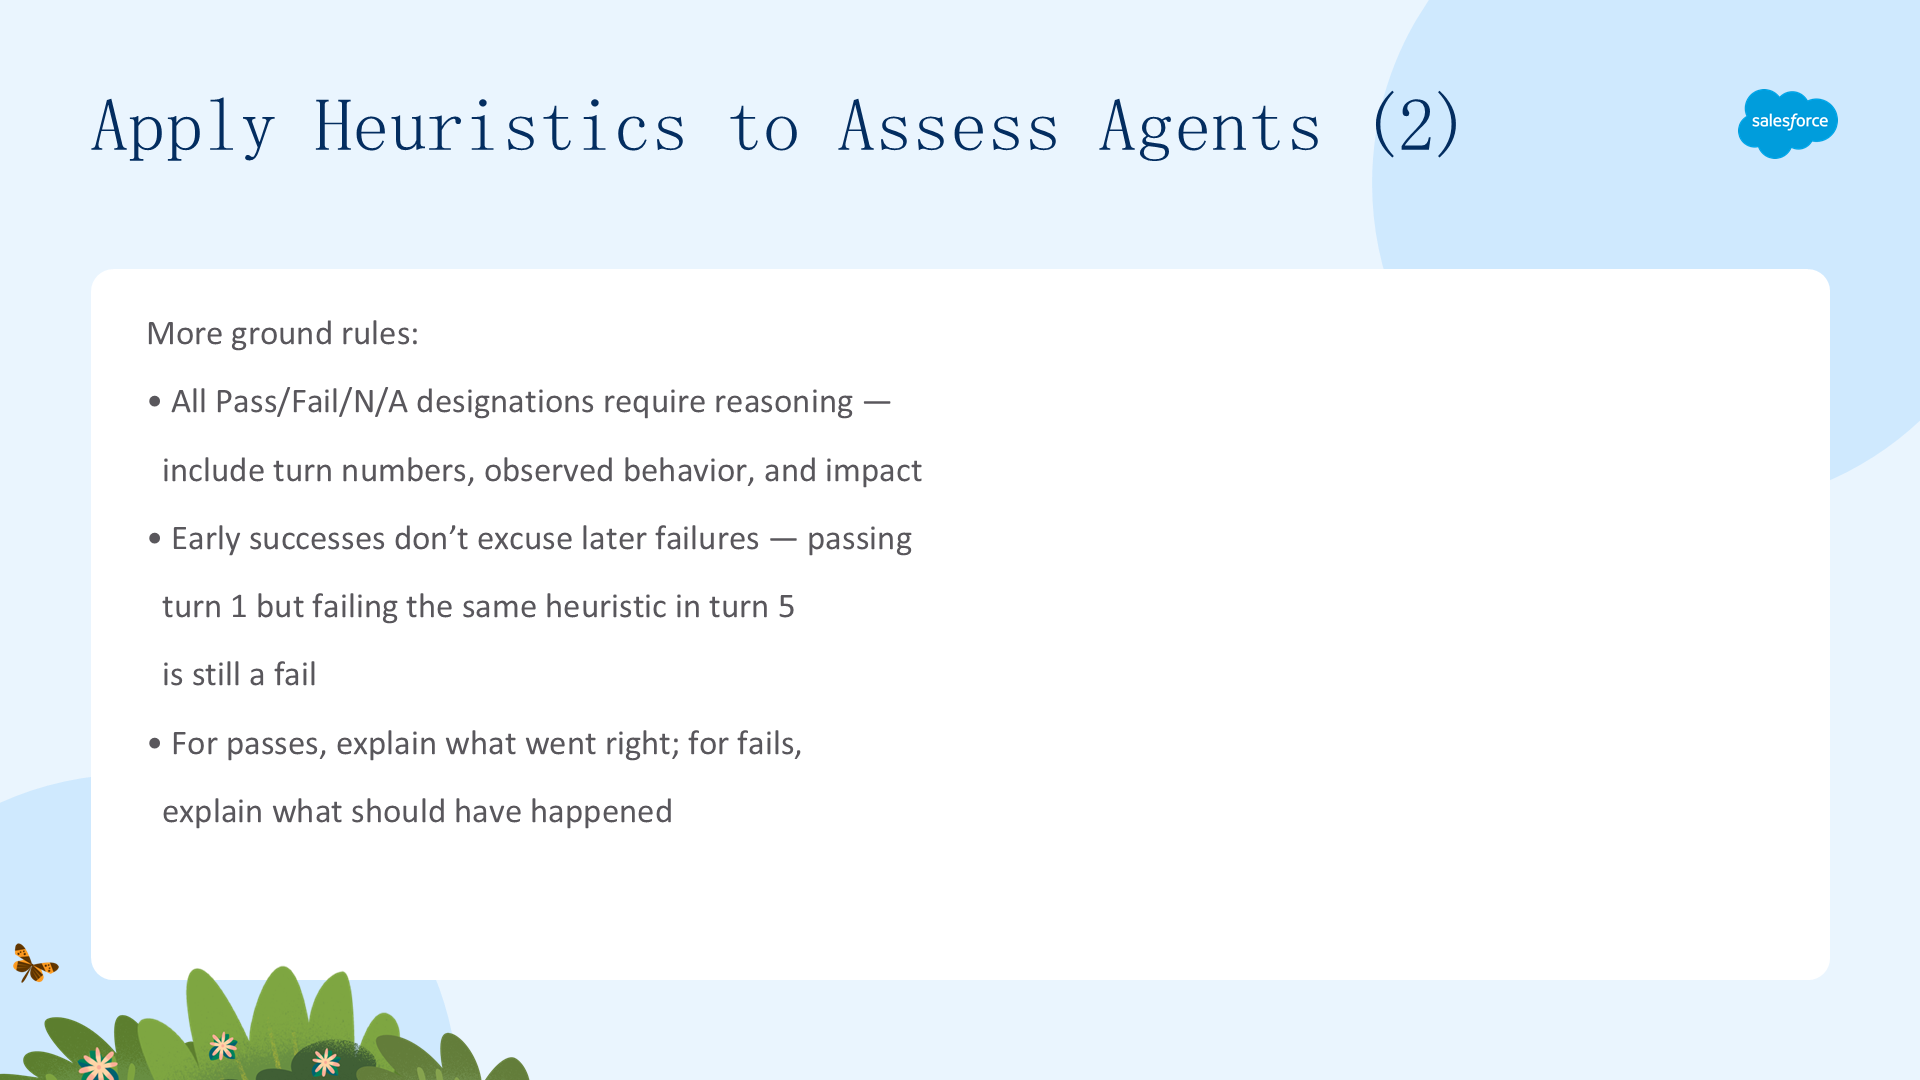
- 所有通过/失败/不适用(Pass/Fail/N/A)的判定都需要给出理由:始终包含轮次编号、观察到的行为和影响。
- 早期成功不能抵消后期失败:如果代理在第 1 轮成功、但在第 5 轮在同一个启发式上失败,那仍然是失败。
- 对于「通过」,说明什么做对了:什么具体行为证明了成功?
- 对于「失败」,说明什么做错了:代理本应怎么做?这如何影响了用户体验?
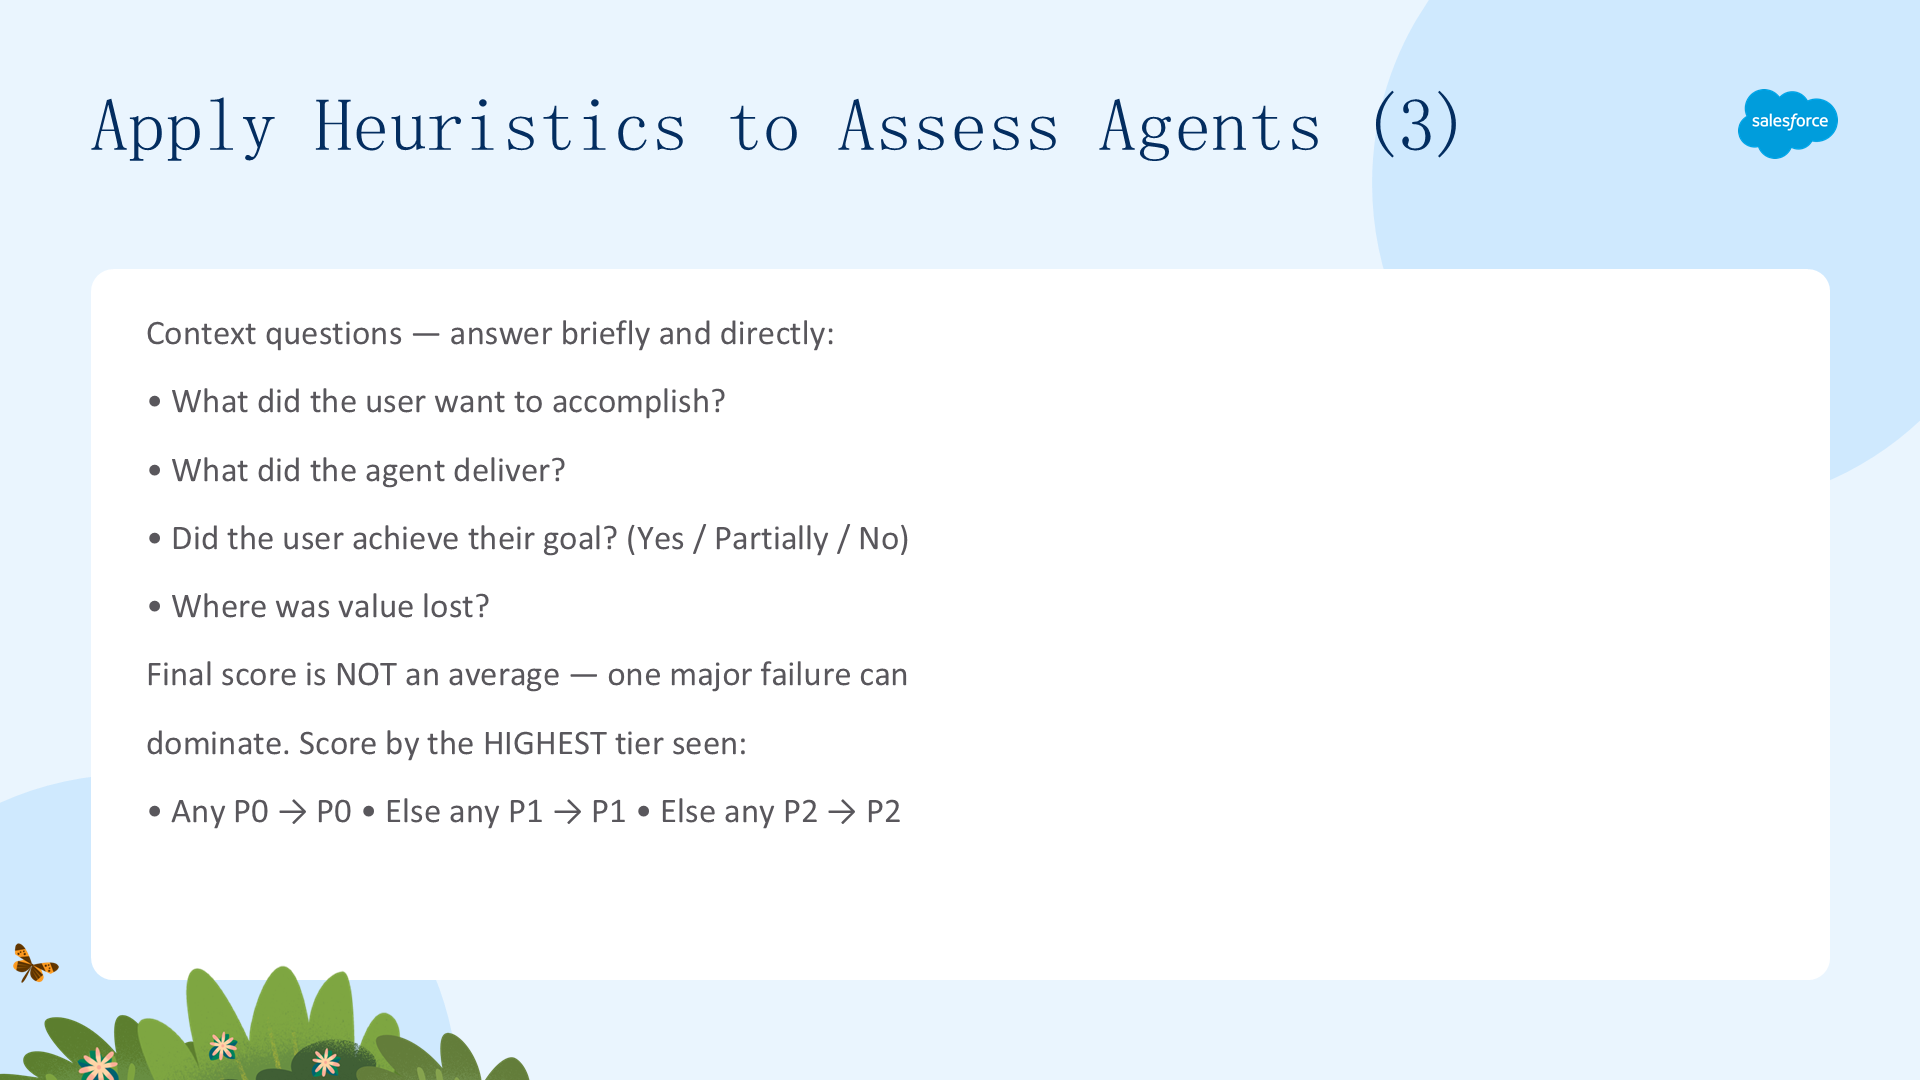
接下来,评估者的目标是理解对话本身的上下文。通过尽可能简短直接地回答以下问题来完成:
- 用户想完成什么?
- 代理交付了什么?
- 用户达成目标了吗?(是 / 部分 / 否)
- 价值在哪里丢失了?(聚焦轮次并描述结果。)
在对用户意图有了把握、并对交互过程中发生了什么有了良好理解之后,评估者就可以继续评估每条启发式,并给出通过或失败的判定。作为提醒,可参考上一单元的启发式表,它解释了与 P0、P1、P2 事件相关的严重级别。
对每条启发式,设计师选择「通过」「失败」或「不适用」(当某条启发式在特定对话中可能不出现或不适用时)。这些评估还会记录轮次、观察到的行为和用户影响。一旦所有启发式都打分完毕,评估者就可以为对话给出最终分数。这个最终分数不是基于平均值的——因为单个重大失败就可能对用户体验产生巨大影响。相反,对话的分数基于观察到的最高严重级别来判定。
| 判定结果 | 最终分数 |
|---|---|
| 任何启发式以 P0 级别失败。 | P0 关键系统故障 |
| 没有 P0 失败,但任何启发式以 P1 级别失败。 | P1 用户意图未满足 |
| 没有 P0 或 P1 失败,但任何启发式以 P2 级别失败。 | P2 价值有限 |
| 所有启发式都通过。 | 通过(Pass) |
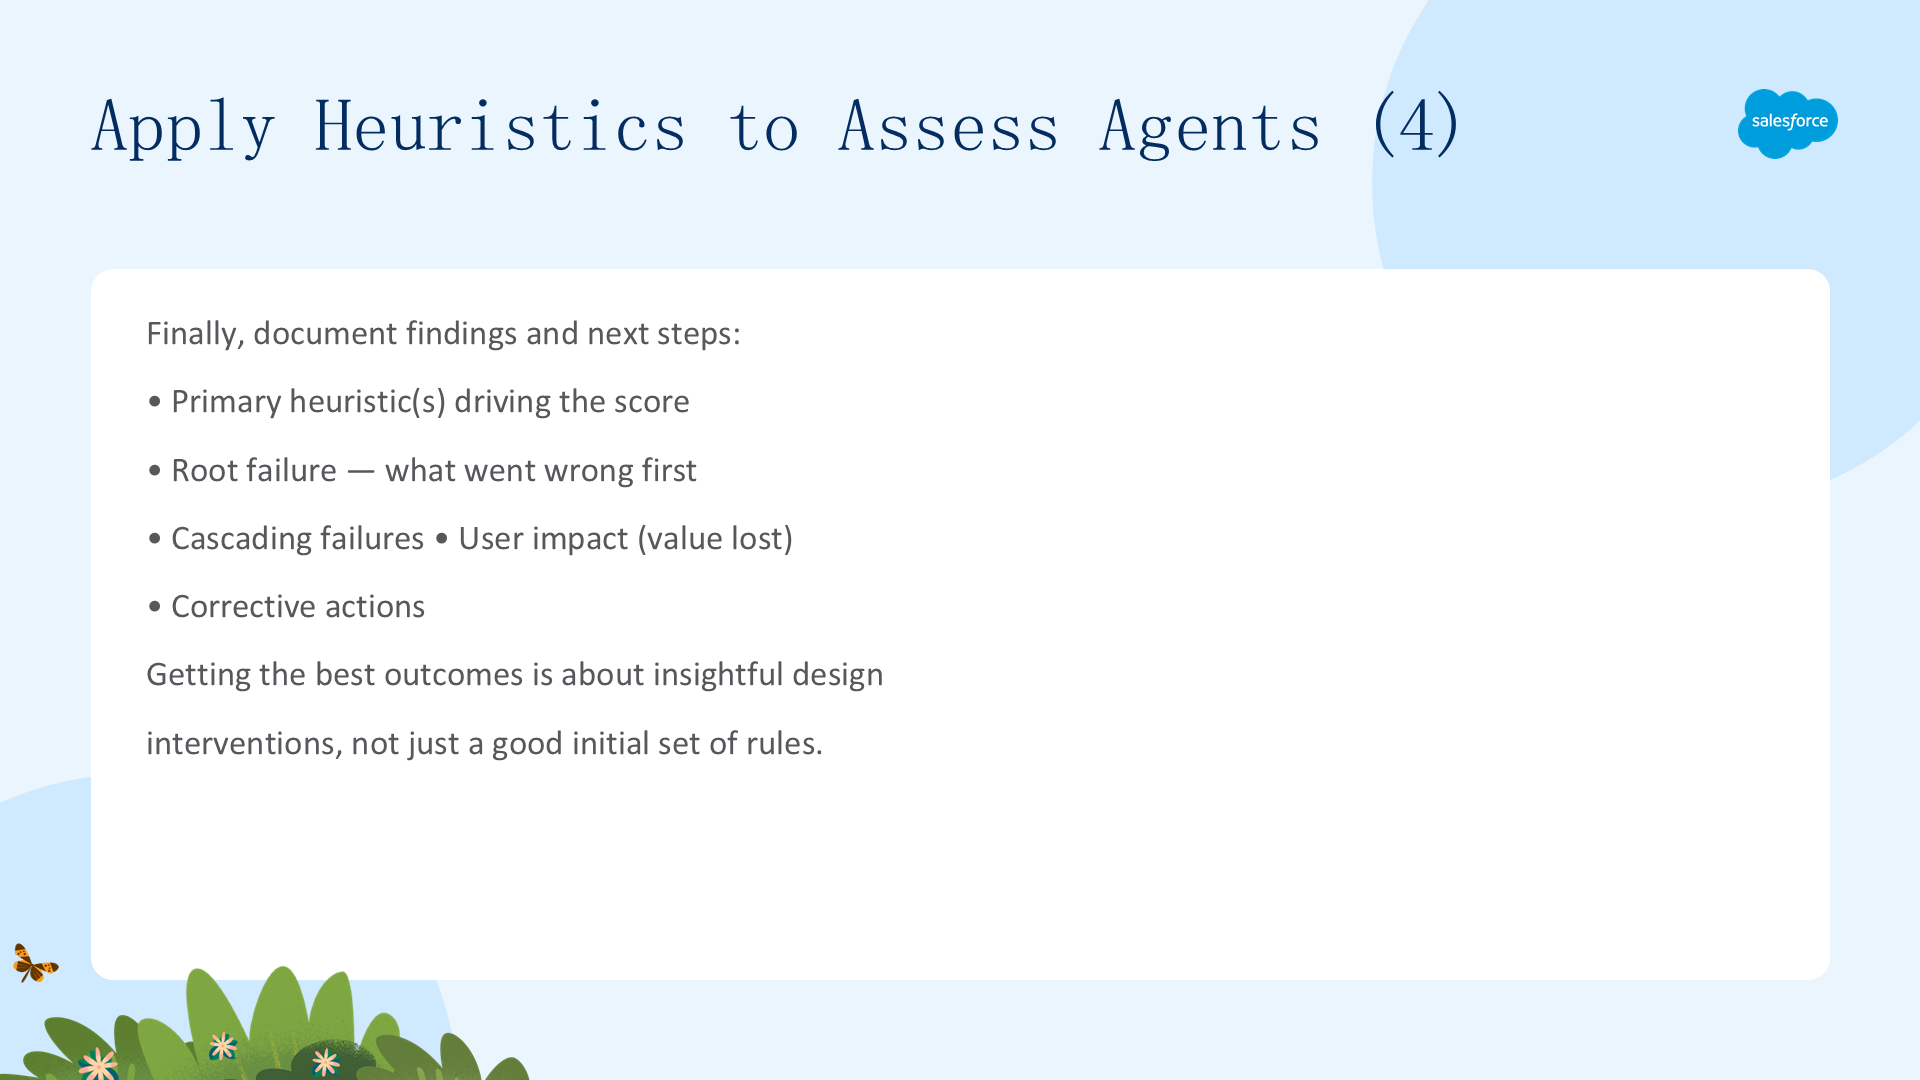
最后,一旦日志被打分,评估者记录他们的发现和下一步行动,包括:
- 驱动分数的主要启发式。
- 根因失败(最先出问题的地方)。
- 级联失败。
- 用户影响(丢失的价值)。
- 纠正措施。
在评估过程结束时,设计师对「对话中发生了什么」以及「下一步行动的合适优先级」都有了更好的理解。对代理而言,获得最佳结果关乎应用有洞察力的设计干预,而不仅仅是有一套好的初始规则。通过使用启发式和严重级别,设计师让代理行为围绕真实的人、真实的成功——由「代理做什么」与「用户需要什么」之间的一致性来定义。
评估 AI 代理不只是发现哪里坏了,更是理解对用户最重要的是什么,并据此排定改进的优先级。有了结构化的分诊与改进方法,你就能持续塑造代理行为,交付有意义、可靠的体验。